AI-basisprincipes
Coderen en AI: Een beginnerspad naar Kunstmatige Intelligentie

 Voeg Unite.AI toe aan je voorkeursbronnen op Google
Je kunt beginnen met AI te leren zonder eerdere professionele programmeerervaring, maar het bouwen van betrouwbare systemen vereist uiteindelijk voldoende codeer‑, data‑ en evaluatievaardigheden om te inspecteren wat de tools doen. Het snelste pad is een korte reeks projecten die gekoppeld zijn aan de basisprincipes in plaats van een lange tour door losse tutorials.
AI‑ondersteund coderen kan syntaxis uitleggen, voorbeelden genereren en helpen bij het debuggen. Beschouw de output als een concept: voer het uit, test het, lees de documentatie en begrijp de data en permissies voordat je het vertrouwt.
Belangrijkste punten
- Leer basis‑Python, notebooks, Git, de commandoregel en hoe je fouten leest.
- Bouw één klein supervised‑learning project voordat je naar agents of grote modellen springt.
- Gebruik trainings‑, validatie‑ en testdata correct; vergelijk met een eenvoudige basislijn.
- Laat AI de feedbacklus ondersteunen, maar verifieer zelf code, bronnen, licenties, beveiliging en resultaten.
Fase 1: programmeerfundamenten
Leer variabelen, collecties, voorwaarden, lussen, functies, modules, bestanden, omgevingen en uitzonderingen. Oefen met het lezen van een CSV, het transformeren van records, het aanroepen van een gedocumenteerde API, het schrijven van een test en het gebruiken van Git om wijzigingen bij te houden.
Je hebt geen geavanceerde wiskunde nodig voordat je code schrijft, maar je moet basisprobabiliteit, vectoren, gemiddelden, distributies en grafieken leren zodra ze relevant worden. Computational thinking helpt een vaag doel om te zetten in testbare stappen.
Fase 2: een volledig ML‑project
Kies een kleine openbare dataset en een duidelijke voorspellingsvraag. Verken de data, maak een onafhankelijke splitsing, bouw een basislijn, train een eenvoudig model, inspecteer fouten en noteer beperkingen. Gebruik scikit-learn voordat je een aangepast neuraal netwerk inzet, wanneer dat passend is.
Dit project maakt machine‑learning concepten concreet: features, labels, data‑lekkage, overfitting, meetwaarden, reproduceerbaarheid en het verschil tussen een modelscore en een bruikbare beslissing.
Fase 3: deep learning en taalmodellen
Leer tensors, batches, loss, gradient descent en backpropagation via een klein beeld‑ of tekstmodel. Gebruik vervolgens een voorgetraind model via een API of open bibliotheek, registreer prompts en versies, en vergelijk het met een eenvoudigere methode.
Verken generatieve AI via een begrensde toepassing met retrieval of tool‑gebruik. Voeg validatie, citaties, permissies en fallback toe zodat het project zowel systeem‑engineering als prompting onderwijst.
AI‑code‑assistenten doelbewust gebruiken
Vraag om kleine functies, tests, uitleg, randgevallen en documentatierreferenties. Voer statische controles en tests uit, beoordeel afhankelijkheidswijzigingen en plak nooit geheimen of privé‑data zonder toestemming. Als je een kritieke regel niet kunt uitleggen, vertraag dan.
Een nuttig portfolio toont de vraag, data‑rechten, basislijn, methode, evaluatie, fouten en wat je zou verbeteren. Voltooide, gedocumenteerde kleine projecten tonen meer beoordelingsvermogen dan gekopieerde code uit een grote demo.
Een praktisch leerpad van probleem tot prototype
Begin met een specifieke taak en een kleine set representatieve voorbeelden in plaats van een brede ambitie om ‘AI te leren.’ Het classificeren van ondersteuningsberichten, het extraheren van factuurvelden of het beantwoorden van vragen uit goedgekeurde documenten levert observeerbare invoer en uitvoer op. Beschrijf hoe een goed resultaat eruitziet voordat je een model of tool kiest.
No‑code‑interfaces kunnen prompting, datapreparatie, evaluatie en workflow‑ontwerp leren, maar ze wegnemen niet de noodzaak van technisch oordeel. Leer tabellen, bestanden, API’s, authenticatie, variabelen, voorwaarden en basisstatistieken. Deze concepten verklaren hoe data beweegt, waarom integraties falen en wat een modelresultaat wel of niet betekent.
Bouw een basislijn met een eenvoudige regel, zoekmethode, spreadsheet of klein model. Vergelijk vervolgens een AI‑benadering op dezelfde testcases. Een basislijn onthult of complexiteit waarde toevoegt en geeft beginners een concreet debug‑doel. Houd testdata gescheiden van voorbeelden die worden gebruikt om het systeem te configureren of te prompten.
Prompten, API’s en de overgang naar code
Een nuttige prompt geeft de taak, relevante context, beperkingen, output‑schema en voorbeelden (indien nodig) weer. Prompt‑wijzigingen zijn software‑wijzigingen: versie ze, test ze tegen een vaste evaluatieset en inspecteer fouten. Beschouw vloeiende uitleg van het model niet als bewijs dat het antwoord of de geciteerde bron correct is.
Workflow‑builders koppelen model‑aanroepen aan formulieren, databases, bestanden en zakelijke toepassingen. Begrijp welke data elke stap naar derden stuurt, hoe inloggegevens worden opgeslagen en wat er gebeurt bij time‑out of herpoging. Voeg invoervalidatie, gestructureerde outputs, snelheidslimieten, menselijke goedkeuring en logs toe voordat je een prototype met echte gebruikers gebruikt.
Code wordt waardevol wanneer de workflow aangepaste logica, herhaalbare tests, schaal, prestaties, draagbaarheid of gedetailleerde beveiligingscontroles vereist. Python en JavaScript zijn gangbare instappunten, maar de taal is minder belangrijk dan de basisprincipes: functies, datastructuren, pakketten, fouten, versiebeheer en tests. Gebruik gegenereerde code alleen nadat je deze veilig hebt gelezen en uitgevoerd.
Portfolio‑projecten, evaluatie en loopbaanontwikkeling
Een sterk beginnersproject documenteert het probleem, de gebruikers, data‑permissies, basislijn, architectuur, evaluatieset, meetwaarden, fouten, risico’s en vervolgstappen. Een gepolijste interface zonder evaluatie toont minder dan een klein, reproduceerbaar experiment. Verwijder privé‑data en geheimen voordat je code, screenshots, prompts of logs publiceert.
Evalueer het succes van de taak in plaats van de indrukwekkendheid van het model. Classificatie vereist klassen‑specifieke precisie en recall; extractie vereist veld‑accuratesse; retrieval vereist dekkingsgraad van bewijs; generatie vereist feitelijkheid, bruikbaarheid, veiligheid, latency en kosten. Beoordeel de prestaties over talen, randgevallen en getroffen groepen, en bepaal wanneer een mens moet beslissen.
AI‑werk omvat productmanagement, domeinexpertise, data‑operaties, evaluatie, ontwerp, beveiliging, beleid en verandermanagement naast modelontwikkeling. Bouw diepgang op in één domein en voldoende technische geletterdheid om over rollen heen samen te werken. Credible portfolio’s leggen afwegingen en beperkingen uit in plaats van elke prototype te presenteren als productie‑klare automatisering.
Voorbeeld: een beginner bouwt een document‑triage‑assistent
Een leerling verzamelt een kleine set openbare of toegestane documenten en definieert drie categorieën plus een ‘onzekere’ uitkomst. Ze labelen voorbeelden met een geschreven regel, reserveren een testset en implementeren een trefwoord‑basislijn in een spreadsheet. Een no‑code‑model of API geeft vervolgens een gestructureerde categorie en vertrouwen terug, die wordt vergeleken met dezelfde gevallen. Onjuiste en dubbelzinnige voorbeelden vormen het leermateriaal, niet iets dat verborgen blijft in een demo.
De workflow accepteert een bestand, extraheert tekst, verwijdert niet‑ondersteunde formaten, roept het model aan met een vast schema, valideert de respons en stuurt onzekere gevallen naar review. Het slaat alleen noodzakelijke velden op en bevat nooit inloggegevens in prompts of gedeelde screenshots. De leerling registreert modelnaam, prompt‑versie, latency, kosten en output zodat wijzigingen getest kunnen worden in plaats van uit het geheugen te worden beoordeeld.
Een portfolio‑rapportage geeft per‑klasse precisie en recall, privacy‑aannames, foutvoorbeelden en de grens tussen prototype en productie weer. De volgende code‑stap kan een fragiele handmatige integratie vervangen door een kleine geteste functie of API. Deze voortgang leert overdraagbare vaardigheden: probleemdefinitie, datakwaliteit, evaluatie, interfaces, foutafhandeling, beveiliging en communicatie. Deze fundamenten wegen zwaarder dan beweren een geavanceerde agent te hebben gebouwd na één succesvol voorbeeld.
Praktische implementatie‑checklist
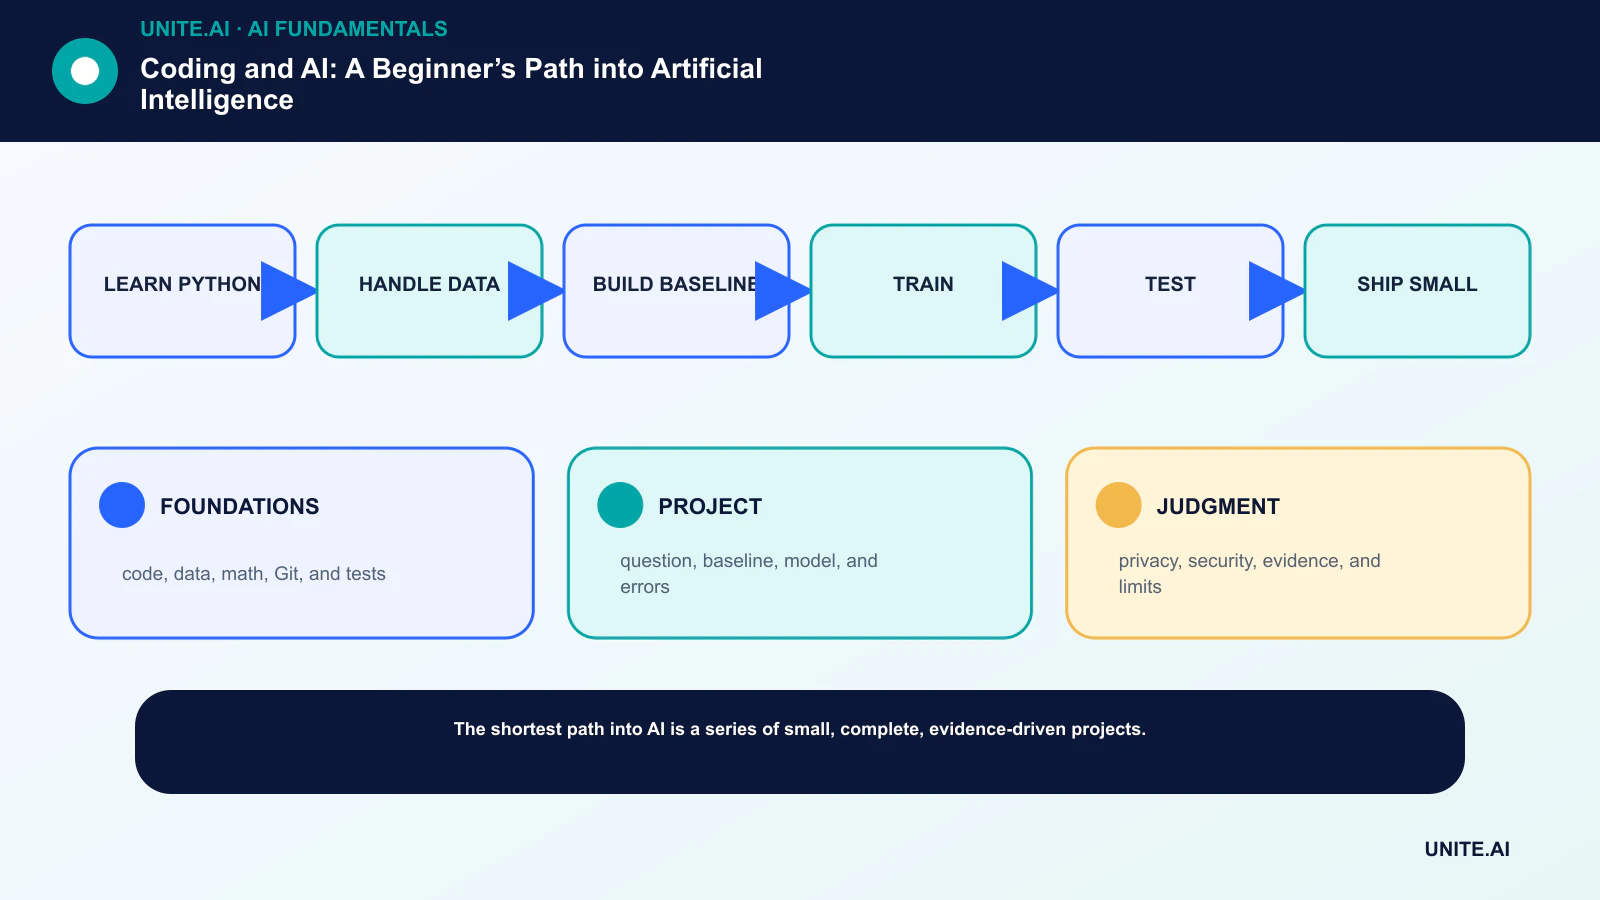
Zet het concept om in een begrensde, testbare workflow: leer python → verwerk data → bouw basislijn → train → test → lever klein op. Benoem een verantwoordelijke eigenaar, documenteer de data en afhankelijkheden, stel een eenvoudige basislijn vast, definieer acceptatie‑ en stopcriteria, test representatieve fouten, en bepaal monitoring, rollback en review voordat je de scope uitbreidt. Leg versies en aannames vast zodat een ander team het resultaat kan reproduceren en begrijpt wat er veranderd is.
Voordat je lanceert, voer een gedocumenteerde gereedheidsreview uit met de mensen die het systeem bouwen, exploiteren, beveiligen en erdoor worden getroffen. Test normale gevallen, grenscondities, afhankelijkheidsfouten en misbruik; bewaar het bewijs en onopgeloste risico’s. Definieer wie de release kan goedkeuren, een drempel kan aanpassen, een output kan overschrijven of de werking kan stoppen. Herzie de beslissing zodra real‑world data binnenkomt, want een technisch geslaagde pilot garandeert geen betrouwbare prestaties op grotere schaal.
- FOUNDATIONS: code, data, wiskunde, Git, en tests.
- PROJECT: vraag, basislijn, model, en fouten.
- JUDGMENT: privacy, beveiliging, bewijs, en limieten.
Veelgestelde vragen
Heb ik een informatica‑diploma nodig om in AI te werken?
Nee. Rollen omvatten engineering, onderzoek, product, design, operations, data, evaluatie, beleid en domeinexpertise. Elke rol heeft een andere diepgang qua code‑vereiste.
Welke programmeertaal moet een beginner leren?
Python is een praktische eerste keuze omdat de syntaxis toegankelijk is en het data‑ en ML‑ecosysteem breed is. De onderliggende probleemoplossende vaardigheden zijn overdraagbaar naar andere talen.
Primaire referenties