
Anderson의 관점
HunyuanCustom,

 Unite.AI를 Google의 선호 소스에 추가
이 글은 Hunyuan Video의 새로운 멀티모달 월드 모델인 HunyuanCustom을 다룬다. 새 논문이 다루는 범위가 매우 넓고 프로젝트 페이지의 여러 예시 영상에도 문제가 있어, 평소보다 개괄적으로 살펴보고 공개된 방대한 영상 자료 중 일부만 소개한다. 많은 영상은 화면 구성을 읽기 쉽게 만들려면 상당한 재편집과 처리가 필요하다.
논문은 API 기반 생성 시스템 Kling을 ‘Keling’이라고 부르지만, 혼동을 피하기 위해 이 글에서는 Kling으로 표기한다.
Tencent는 Hunyuan Video 모델의 새 버전인 HunyuanCustom을 공개하고 있다. 이 버전은 한 장의 이미지만으로 딥페이크와 유사한 맞춤형 영상을 생성할 수 있어 Hunyuan LoRA 모델의 필요성을 줄이는 것을 목표로 한다.
첫 비교 영상의 맨 왼쪽 열에는 HunyuanCustom에 제공한 단일 원본 이미지가 있고, 두 번째 열에는 새 시스템이 프롬프트를 해석한 결과가 표시된다. 나머지 열은 Kling, Vidu, Pika, Hailuo, Wan 기반 SkyReels-A2 등 여러 상용 및 오픈소스 시스템의 결과를 보여준다.
두 번째 영상은 이번 공개에서 중요한 세 가지 시나리오를 보여준다. 각각 사람과 물체의 조합, 단일 인물 재현, 사람과 의류를 결합한 가상 착용 사례다.
이 예시에서는 같은 피사체의 여러 사진이 아니라 단 한 장의 원본 이미지에 의존하는 시스템의 한계가 드러난다.
첫 번째 영상에서 남성은 거의 계속 카메라를 바라본다. 고개를 아래나 옆으로 약 20~25도 정도만 움직이는데, 그보다 더 크게 돌리면 시스템은 한 장의 정면 사진만으로 옆모습을 추측해야 한다. 이를 정확하게 재구성하는 것은 매우 어렵다.
두 번째 예시에서 어린 소녀는 정지 원본 이미지와 마찬가지로 생성된 영상에서도 미소를 짓는다. 한 장만 참고하면 HunyuanCustom은 표정이 없는 얼굴을 충분한 정보 없이 추정해야 한다. 얼굴 각도도 앞선 남성 예시보다 더 크게 벗어나지 않는다.
마지막 예시에서는 여성과 입힐 의류의 원본 이미지가 완전하지 않기 때문에, 시스템이 상황에 맞게 화면을 잘라냈다. 이는 제한된 입력 데이터에 대한 꽤 합리적인 해결책이다.
새 시스템은 사람과 과자 또는 사람과 의류처럼 여러 이미지를 함께 처리할 수 있지만, 한 인물의 여러 각도나 다른 시점을 입력하는 기능은 제공하지 않는 것으로 보인다. 따라서 다양한 표정이나 특이한 각도를 처리하기 어렵다. 지난해 12월 HunyuanVideo 공개 이후 형성된 LoRA 생태계는 학습 데이터에 포함된 20~60장의 이미지로 여러 각도와 표정에서 일관된 인물을 만들 수 있으므로, HunyuanCustom이 이를 완전히 대체하기는 어려울 수 있다.
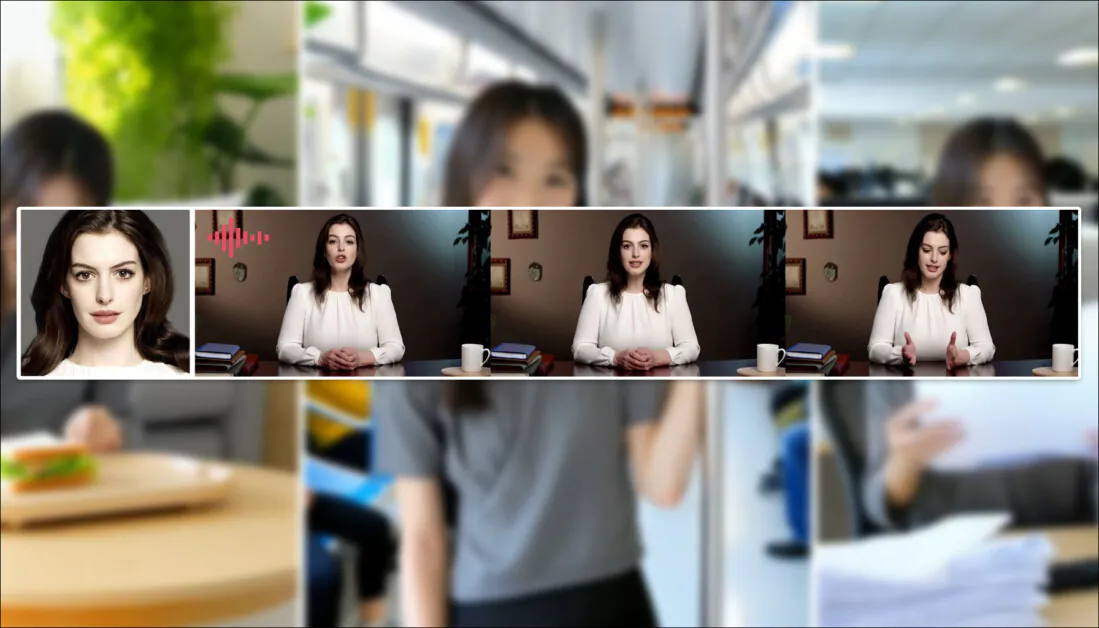
소리와 연결된 생성
오디오 처리에는 LatentSync를 활용한다. 이 시스템은 개인 사용자가 설치하고 좋은 결과를 얻기 어렵기로 알려져 있지만, 사용자가 제공한 오디오와 텍스트에 맞춰 입 모양을 생성한다.
글을 작성하는 시점에는 영어 예시가 없었지만 공개된 결과는 상당히 좋아 보였다. 특히 제작 방식이 설치하기 쉽고 접근성이 높다면 더 의미가 있다.
기존 영상 편집
새 시스템은 기존 실제 영상의 일부를 마스킹하고 단일 참조 이미지로 제공한 피사체로 지능적으로 바꾸는 비디오 투 비디오(V2V 또는 Vid2Vid) 편집에서도 인상적인 결과를 제시한다.
Vid2Vid 처리의 일반적인 특성처럼 대상 영역만이 아니라 영상 전체가 어느 정도 달라지지만, 중앙의 인형처럼 지정된 부분에서 변화가 가장 크다. 대부분의 원본 영상을 그대로 유지하는 가비지 매트 방식의 파이프라인을 개발할 수 있을 것으로 보인다. Adobe Firefly는 내부적으로 이 방식을 비교적 잘 사용하지만, 오픈소스 생성 생태계에서는 충분히 연구되지 않았다.
다른 예시들은 변경 대상을 더 정확히 통합하며, 대상이 아닌 주변 소재를 상당히 잘 보존한다.
새로운 출발인가?
이번 프로젝트는 Hunyuan Video 개발 흐름을 버리고 완전히 전환한 것이 아니라 기존 프로젝트의 확장이다. 전면적인 구조 변경 대신 개별 아키텍처 모듈을 추가해, LoRA나 텍스트 역전처럼 피사체별 미세 조정에 의존하지 않고도 프레임 사이에서 정체성을 유지하도록 설계됐다.
따라서 HunyuanCustom은 처음부터 학습한 모델이 아니라 2024년 12월 공개된 HunyuanVideo 기반 모델을 미세 조정한 버전이다.
기존 HunyuanVideo LoRA 제작자들은 새 버전에서도 LoRA가 작동하는지, 아니면 내장 기능 이상의 맞춤화가 필요할 때 다시 LoRA를 만들어야 하는지 궁금할 수 있다.
초대형 모델을 크게 미세 조정하면 일반적으로 가중치가 충분히 바뀌어 이전 모델용 LoRA가 새 모델에서 제대로 작동하지 않거나 전혀 작동하지 않는다.
그러나 미세 조정 모델이 원본보다 독자적인 생태계를 만들기도 한다. Stable Diffusion XL을 미세 조정한 Pony Diffusion은 효과적인 포크가 된 사례다. CivitAI에서 59만 건이 넘는 다운로드를 기록했고, SDXL이 아니라 Pony를 기반으로 한 많은 LoRA가 만들어져 추론 시 Pony가 필요하다.
공개 현황
HunyuanCustom: A Multimodal-Driven Architecture for Customized Video Generation 논문의 프로젝트 페이지는 GitHub 저장소로 연결된다. 글을 작성하는 시점에 저장소가 막 활성화됐으며, 로컬 구현에 필요한 코드와 가중치 및 공개 일정이 포함된 것으로 보인다. 아직 남은 주요 항목은 ComfyUI 통합이다.
같은 시점에 Hugging Face 페이지는 아직 404 오류를 냈다. 다만 WeChat 스캔 코드를 제공하면 시험할 수 있는 API 버전이 있다.
HunyuanCustom처럼 매우 다양한 프로젝트를 하나의 구성에 폭넓게 결합한 사례는 드물다. 일부 라이선스 조건도 전체 공개를 요구할 가능성이 있다.
GitHub에는 두 모델이 소개됐다. 720×1280 버전은 최대 GPU 메모리 80GB, 512×896 버전은 최대 60GB가 필요하다. 저장소는 720×1280, 129프레임 생성에 필요한 최소 GPU 메모리가 24GB지만 매우 느리며, 더 나은 품질을 위해 80GB GPU를 권장한다고 설명한다. 현재는 Linux에서만 시험됐다.
기존 Hunyuan Video 모델은 공식 공개 이후 24GB 미만의 VRAM에서도 실행할 수 있도록 양자화됐다. 새 모델 역시 커뮤니티가 소비자 하드웨어에 맞는 형태로 조정하고 Windows에서도 빠르게 사용할 수 있게 만들 가능성이 높다.
이번 공개에 포함된 정보가 방대해 여기서는 심층 분석보다 전체적인 개요를 먼저 살펴본다. 다음으로 HunyuanCustom의 내부 구조를 간단히 살펴보자.
논문 살펴보기
HunyuanCustom의 데이터 파이프라인은 GDPR 기준을 준수하는 것으로 소개되며, 합성 영상과 OpenHumanVid 같은 오픈소스 영상 데이터셋을 함께 사용한다. 핵심 범주는 사람, 동물, 식물, 풍경, 차량, 물체, 건축, 애니메이션의 여덟 가지다.

초기 필터링에서는 PySceneDetect로 영상을 한 장면씩 분리한다. 이어 TextBPN-Plus-Plus를 이용해 화면 속 글자, 자막, 워터마크 또는 로고가 지나치게 많은 영상을 제거한다.
해상도와 길이의 불일치를 줄이기 위해 모든 클립을 5초로 표준화하고 짧은 변을 512 또는 720픽셀로 맞춘다. 미적 품질은 Koala-36M으로 필터링하며 연구진이 만든 맞춤 데이터셋에는 0.06의 자체 임곗값을 적용한다.
피사체 추출에는 Qwen7B 대규모 언어 모델, YOLO11X 객체 인식 프레임워크, InsightFace 구조를 결합해 사람의 정체성을 식별하고 검증한다. 사람이 아닌 피사체에는 QwenVL과 Grounded SAM 2를 사용해 경계 상자를 추출하며, 너무 작은 상자는 버린다.

여러 피사체를 추출할 때는 Florence2로 경계 상자를 표시하고 Grounded SAM 2로 분할한 뒤, 학습 프레임을 군집화하고 시간 단위로 나눈다.
처리된 클립에는 Hunyuan 팀이 만든 독자적인 구조화 라벨링 시스템으로 설명과 카메라 움직임 같은 계층적 메타데이터를 붙인다. 경계 상자로 변환하는 등의 마스크 증강도 적용해 과적합을 줄이고 다양한 물체 형태에 적응시킨다.
오디오는 앞서 언급한 LatentSync로 동기화하며 점수가 최소 임곗값보다 낮은 클립은 제거한다. HyperIQA 품질 평가에서 40점 아래인 영상도 제외하고, 유효한 오디오 트랙은 Whisper로 처리해 후속 작업에 사용할 특징을 추출한다.
주석 단계에서는 LLaVA 언어 보조 모델이 중심 역할을 한다. LLaVA는 이미지 캡션을 만들고 시각 콘텐츠와 텍스트 프롬프트를 정렬해 여러 모달리티에 일관된 학습 신호를 제공한다. 시각-언어 정렬은 특히 여러 피사체나 복잡한 장면에서 시각 요소와 설명 사이의 의미적 일관성을 높인다.

맞춤형 영상
참조 이미지와 프롬프트를 바탕으로 영상을 만들기 위해 LLaVA 중심 모듈 두 개를 추가했다. 먼저 HunyuanVideo의 입력 구조를 수정해 텍스트와 함께 이미지를 받을 수 있게 했다.
프롬프트에는 이미지를 직접 삽입하거나 짧은 정체성 설명 태그를 붙인다. 이미지 임베딩이 텍스트 프롬프트를 압도하지 않도록 구분 토큰도 사용한다.
LLaVA의 시각 인코더는 이미지와 텍스트 특징을 정렬할 때 세밀한 공간 정보를 압축하거나 버리는 경향이 있다. 특히 한 장의 참조 이미지를 일반적인 의미 임베딩으로 바꿀 때 이 문제가 두드러지므로, 정체성 강화 모듈을 추가했다. 대부분의 영상 잠재 확산 모델이 5초짜리 클립에서도 LoRA 없이 정체성을 유지하기 어렵다는 점을 고려하면 이 모듈의 실제 성능은 중요하다.
참조 이미지는 원본 HunyuanVideo 모델의 인과적 3D-VAE로 크기를 조절하고 인코딩한다. 생성 영상이 이미지를 그대로 복제하지 않으면서도 참고할 수 있도록 공간 오프셋을 적용한 뒤, 해당 잠재 표현을 시간축 전체의 영상 잠재 공간에 삽입한다.
모델은 로짓 정규분포에서 뽑은 잡음 표본과 Flow Matching을 사용해 학습했다. 네트워크는 잡음이 섞인 잠재 표현에서 올바른 영상을 복원하도록 훈련됐다. LLaVA와 영상 생성기는 함께 미세 조정해 이미지와 프롬프트가 출력에 자연스럽게 영향을 주고 피사체 정체성이 유지되도록 했다.
여러 피사체가 포함된 프롬프트에서는 이미지-텍스트 쌍을 각각 별도로 임베딩하고 서로 다른 시간 위치를 부여한다. 이를 통해 정체성을 구분하고 여러 피사체가 상호작용하는 장면을 생성한다.
소리와 영상의 결합
HunyuanCustom은 사용자가 넣은 오디오와 텍스트 프롬프트를 함께 조건으로 사용해, 설명된 환경 속 인물이 말하는 영상을 만든다.
정체성 분리형 AudioNet 모듈은 참조 이미지와 프롬프트의 정체성 신호를 방해하지 않으면서 오디오 특징을 넣는다. 특징을 압축된 영상 시간축에 맞추고 프레임 단위로 나눈 다음, 각 프레임을 독립적으로 유지하는 공간 교차 주의 메커니즘으로 삽입한다. 이는 피사체 일관성을 지키고 시간 간섭을 피한다.
두 번째 시간 주입 모듈은 AudioNet과 함께 동작하며 타이밍과 움직임을 더 세밀하게 제어한다. 오디오 특징을 잠재 시퀀스의 특정 영역에 배치하고 다층 퍼셉트론으로 토큰 단위 움직임 오프셋으로 변환해 몸짓과 표정이 음성의 리듬과 강세를 더 정확히 따르게 한다.
HunyuanCustom은 전체 클립을 처음부터 다시 만들지 않고도 기존 영상의 사람이나 물체를 교체하거나 삽입할 수 있다. 외형이나 움직임을 특정 부분에서 바꾸는 작업에 유용하다.
최근 인기를 얻은 VACE처럼 전체 영상 시퀀스를 합치는 자원 집약적 방식 대신, 사전 학습된 인과적 3D-VAE로 참조 영상을 압축해 생성 파이프라인의 내부 영상 잠재 표현과 정렬한 뒤 두 표현을 더한다. 외부 영상을 출력의 지침으로 사용하면서도 비교적 가볍게 처리할 수 있다.
작은 신경망이 깨끗한 입력 영상과 생성에 쓰이는 잡음 잠재 표현을 정렬한다. 연구진은 두 특징 집합을 합친 뒤 다시 압축하는 방식과 프레임별로 특징을 더하는 방식을 시험했다. 두 번째 방식이 계산량을 늘리지 않으면서 화질 손실을 피하고 더 좋은 결과를 냈다.
데이터와 실험
평가에는 여러 지표가 사용됐다. ArcFace 정체성 일관성 모듈은 참조 이미지와 생성 영상의 각 프레임에서 얼굴 임베딩을 추출해 평균 코사인 유사도를 계산한다. 피사체 유사도는 YOLO11X로 자른 영역을 DINO 2에 보내 비교한다.
CLIP-B-T는 프롬프트와 생성 영상의 텍스트-영상 정렬을 측정한다. 또 다른 CLIP-B 기반 지표는 각 프레임을 이웃 프레임과 첫 프레임에 비교해 시간적 일관성을 계산한다. 움직임 강도는 VBench의 정의를 따른다.
상용 기준 모델은 Hailuo, Vidu 2.0, Kling 1.6, Pika였고 오픈소스 경쟁 모델은 VACE와 SkyReels-A2였다.
연구진은 HunyuanCustom이 가장 높은 얼굴 정체성 및 피사체 일관성을 얻었고 프롬프트 추종과 시간 일관성에서도 비슷한 수준의 결과를 냈다고 말한다. Hailuo는 텍스트 지시를 잘 따르기 때문에 CLIP 점수가 가장 높지만, 사람 이외 피사체의 일관성을 희생해 DINO 유사도가 가장 낮았다. Vidu와 VACE는 움직임 강도가 약했으며 연구진은 모델 크기가 작은 것이 원인일 수 있다고 본다.

프로젝트 사이트에는 많은 비교 영상이 있지만 화면 구성이 웹사이트 미관에 맞춰져 있어 세부 비교가 쉽지 않다. PDF의 정적 결과와 같은 구성을 가진 영상도 현재 없다. 정확한 평가는 프로젝트 페이지의 원본 영상과 논문 PDF를 함께 확인하는 편이 낫다.
객체 중심 맞춤화에서 연구진은 Vidu, SkyReels-A2, HunyuanCustom이 프롬프트 정렬과 피사체 일관성에서 비교적 좋은 결과를 냈지만, HunyuanVideo-13B 기반 모델의 생성 성능 덕분에 HunyuanCustom의 화질이 더 좋다고 평가한다.

Kling은 영상 품질이 좋지만 첫 프레임에서 복사해 붙인 듯한 문제가 나타나고, 피사체가 너무 빠르게 움직여 흐려지는 경우가 있어 시청 경험을 해친다고 지적한다. Pika는 시간 일관성이 부족하고 자막 아티팩트를 만들었다. Hailuo는 얼굴 정체성은 유지하지만 전신 일관성이 떨어졌다. VACE는 정체성 일관성을 유지하지 못한 반면, HunyuanCustom은 품질과 다양성을 유지하면서 정체성을 강하게 보존했다고 주장한다.
여러 피사체 맞춤화에서는 Pika가 지정된 피사체를 만들 수 있지만 프레임이 불안정해 어떤 장면에서는 남성이 사라지고 다른 장면에서는 여성이 지시대로 문을 열지 못했다. Vidu와 VACE는 사람의 정체성을 일부 포착했으나 사람이 아닌 물체의 중요한 세부를 잃었다. SkyReels-A2는 프레임 불안정과 많은 아티팩트를 보였다.

반면 HunyuanCustom은 사람과 비인간 피사체의 정체성을 모두 포착하고, 프롬프트를 따르며 높은 시각 품질과 안정성을 유지했다고 연구진은 설명한다.
가상 인간 광고 실험에서는 제품과 사람을 한 장면에 통합했다. HunyuanCustom은 사람의 정체성을 유지하면서 제품의 글자 등 세부를 보존했고, 사람과 제품 사이의 상호작용도 자연스러워 광고 영상 제작 가능성을 보여줬다.

오디오 기반 피사체 맞춤화에서는 기존 방식이 사람 이미지와 오디오만 받아 자세, 의상, 환경을 원본 이미지에 고정하는 한계가 있었다. HunyuanCustom은 텍스트로 설명한 장면과 자세 속에서 인물이 해당 오디오를 말하게 해 더 유연하고 제어 가능한 애니메이션을 제공한다.

영상 피사체 교체 시험에서 VACE는 입력 마스크를 엄격히 따라 경계 아티팩트, 부자연스러운 형태, 끊어진 움직임을 만들었다. Kling은 피사체를 영상 위에 직접 붙인 듯해 배경과 잘 섞이지 않았다. HunyuanCustom은 경계 아티팩트를 피하고 배경과 자연스럽게 통합하면서 정체성을 강하게 유지했다고 연구진은 평가했다.

연구 및 출처 링크
본문에 언급된 논문, 프로젝트, 모델과 기술 자료:
- project page
- Hunyuan Video model
- Hunyuan LoRA models
- Kling
- Vidu
- Pika
- Hailuo
- Wan
- SkyReels-A2
- sprung up
- LatentSync
- garbage matte
- Hunyuan Video project
- fine-tuning
- yet again
- model weights
- Pony Diffusion
- Stable Diffusion XL
- ever-changing
- project page
- new paper
- GitHub site
- Hugging Face presence
- API-based version
- quantized
- GDPR
- OpenHumanVid
- PySceneDetect
- TextBPN-Plus-Plus
- Koala-36M
- Qwen7B
- YOLO11X
- InsightFace
- QwenVL
- Grounded SAM 2
- Florence2
- Mask augmentation
- overfitting
- HyperIQA
- Whisper
- LLaVA
- latent
- Flow Matching
- logit-normal
- cross-attention
- Multi-Layer Perceptron
- token-wise
- VACE
- ArcFace
- Dino 2
- CLIP-B
- VBench
결론
이번 공개는 Hunyuan Video와 Wan 2.1 같은 시스템의 높아진 사실성에 새로운 차원의 진정성을 더할 립싱크 부족 문제를 다룬다는 점에서 흥미롭다.
프로젝트 페이지의 비교 영상 구성은 HunyuanCustom과 이전 모델을 직접 비교하기 어렵게 만든다. 그럼에도 영상 합성 분야에서 상용 영상 확산 API인 Kling과 공개적으로 경쟁 시험을 하는 프로젝트는 매우 드물다. Tencent는 이 강력한 경쟁 모델을 상대로 인상적인 진전을 보인 것으로 보인다.
일부 영상은 지나치게 넓고 높이가 짧으며 고해상도여서 VLC나 Windows Media Player 같은 일반 재생기에서 검은 화면만 표시되기도 한다.
2025년 5월 8일 목요일 최초 게시.


