
Anderson의 관점
시야에서 벗어난 것, 마음에서 벗어난 것: AI 비디오의 가장 큰 문제 해결

 Unite.AI를 Google의 선호 소스에 추가
최고 수준의 AI 비디오 생성기조차 만성적인 기억상실 문제를 안고 있다. 중국의 새로운 연구는 카메라 밖으로 사라진 인물과 배경을 기억하는 방법으로 이 문제를 다룬다.
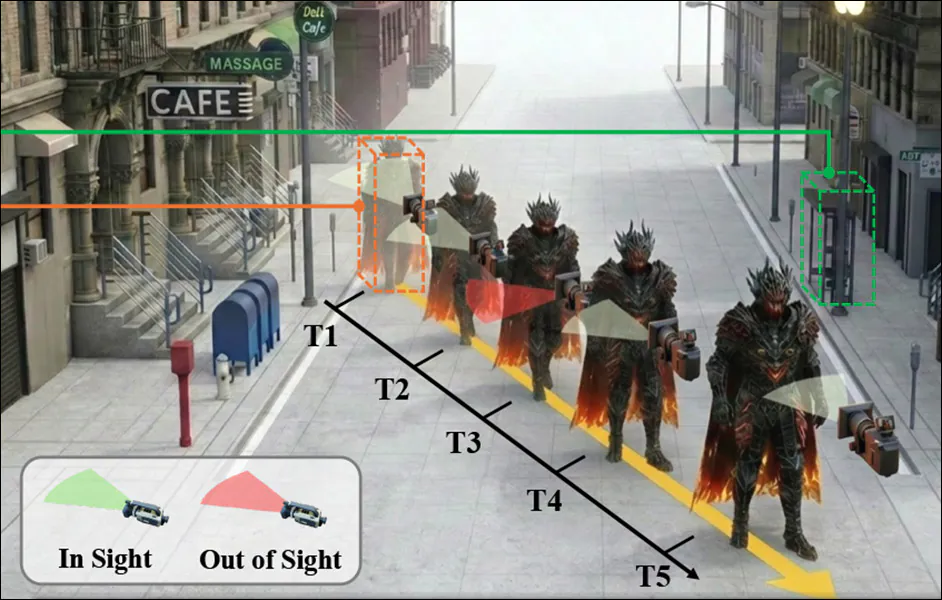
확산 기반 비디오 생성기는 제한된 이동식 어텐션 창 안에서 현재 보이는 장면만 처리한다. 카메라가 피사체에서 벗어났다가 돌아오면 인물이 사라지거나 외형과 움직임이 바뀌고, 배경도 달라질 수 있다. 화면 밖의 요소가 사실상 모델의 기억에서 버려지기 때문이다.
전통적인 CGI는 메시와 비트맵 텍스처를 다시 불러와 동일한 외형을 재현할 수 있다. AI 비디오에는 이에 해당하는 독립적인 참조 파일이 없어 같은 일을 하기 훨씬 어렵다.
전통 CGI에서는 메시, 텍스처, 동작 파일과 기타 행동 데이터를 디스크에 따로 저장하고 필요할 때 다시 장면에 불러올 수 있다. 생성형 비디오 AI에는 이런 평면 저장소가 없다. LoRA로 특정 인물이나 의상을 강제로 유지할 수 있지만, 기반 모델의 정확한 버전에 묶이고 모델이 바뀔 때 다시 학습해야 하며, 한 인물의 특성이 장면의 다른 인물에게 번지는 부작용도 있다.
재생하려면 클릭하십시오. LoRA는 AI 비디오의 기억 문제를 일부 줄일 수 있지만 결과가 지나치게 강하게 적용될 수 있다.
정확한 재등장
중국의 산학 협력 연구진은 화면 밖 인물과 주변 환경을 모델의 잠재 공간에 계속 유지하는 ‘하이브리드 메모리’를 제안했다. 시점이 다시 돌아오면 인물의 외형, 움직임, 환경이 일관되게 복원된다.
재생하려면 클릭하십시오. WAN으로 생성한 인물이 화면 밖으로 나갔다가 정확한 모습으로 돌아오는 두 사례다.
이는 서로 다른 숏에서 같은 캐릭터를 유지하는 문제와 다르다. 이 연구가 해결하려는 것은 하나의 연속 장면 안에서 보이지 않게 된 인물의 이전 외형과 동작, 주변 환경을 기억했다가 다시 나타낼 때 복구하는 것이다.
재생하려면 클릭하십시오. 프로젝트가 공개한 다른 주요 사례들이다. 같은 원리는 도시 탐색, 1인칭 운전 등 인물이 아닌 장면에도 적용할 수 있다.
연구는 Unreal Engine으로 만든 전용 데이터셋, 이 문제를 위한 새로운 평가 지표, WAN 위에 구축한 생성 프레임워크로 구성된다. 논문 제목은 Out of Sight but Not Out of Mind: Hybrid Memory for Dynamic Video World Models이며, 화중과학기술대학교와 Kuaishou Technology의 Kling 팀 소속 연구자 7명이 참여했다.
방법
핵심은 ‘시야 밖 추론’을 가능하게 하는 하이브리드 메모리다. 카메라가 다른 곳을 보거나 인물이 화면에서 나간 동안에도 캐릭터와 맥락을 유지해야 한다. 따라서 프레임 안의 생성과 보이지 않는 인물의 지속 상태를 동시에 다루는 시공간 분리가 필요하다.
카메라 이동 때문에 인물이 화면을 나갔다 다시 들어오는 사례. 다른 샘플에는 인물 자체가 잠시 화면 밖으로 움직이는 경우도 포함된다. 출처
확산 잠재 임베딩에서는 필요한 특성이 배경과 다른 속성에 강하게 얽혀 있다. 이를 단순히 추출하면 움직이는 인물이 배경에 얼어붙거나 섞일 수 있다. 연구진은 하이브리드 메모리 학습에 특화된 HM-World 데이터셋을 만들었다.
HM-World 데이터셋의 네 가지 범주에서 가져온 샘플.
HM-World는 피사체 궤적, 카메라 궤적, 장면, 피사체라는 네 축으로 구성된다. 17개 장면과 다양한 외형의 사람 및 여러 종의 동물 49개를 포함한다. Unreal Engine에서 각각 고유한 동작 애니메이션과 무작위 궤적을 부여했다. 28종의 카메라 궤적과 여러 시작점을 조합해 다양한 퇴장·재등장 사건을 만들었다.
최종 데이터는 59,225개 비디오 클립이며 MiniCPM-V 멀티모달 대형 언어 모델로 주석을 달았다.
기존 데이터셋과 HM-World의 비교. Dynamic Subject는 움직이는 개체, Subject Exit-Enter는 피사체의 퇴장과 재등장, Subject Pose는 주석이 달린 3D 자세를 뜻한다.
덜 가본 경로
과거 프레임과 알려진 카메라 경로가 주어졌을 때, 모델은 관점이 바뀌는 미래 장면을 예측하면서 독립적으로 움직이고 화면을 떠날 수 있는 피사체까지 추적해야 한다. 안정적인 배경만 유지해서는 부족하며, 보이지 않는 동안에도 각 피사체의 외형과 행동에 대한 내부 기록이 필요하다.
Hybrid Dynamic Retrieval Attention(HyDRA)은 동적 피사체를 정적 장면 표현에서 분리하는 전용 메모리 경로를 도입한다. 피사체는 시간이 지나도 메모리에 남고 다시 나타날 때 외형과 동작이 이어진다.
HyDRA 모델의 개념도.
HyDRA는 Wan2.1-T2V-1.3B를 기반으로 한다. 확산 파이프라인은 대부분 유지하면서 동적 검색 어텐션을 포함하는 수정된 Transformer 블록을 추가했다. 모델은 고정된 지역 맥락에만 의존하지 않고 과거 프레임에서 관련 외형과 동작 신호를 선택적으로 불러온다. 학습에는 표준 확산 손실 대신 수정된 Flow Matching 목표를 사용했다.
카메라 이동과 장면을 맞추기 위해 각 프레임의 회전과 이동으로 정의된 카메라 궤적을 조건 신호로 넣는다. 카메라 인코더는 이를 압축 표현으로 바꾸고 Diffusion Transformer 특성에 더해, 카메라가 움직여도 객체 배치를 일관되게 유지한다.
토큰화
원시 확산 잠재 표현에는 피사체의 동작, 외형, 배경이 뒤섞여 있다. HyDRA의 3D 합성곱 기반 Memory Tokenizer는 공간과 시간을 함께 처리한다. 전체 잠재 기록을 전달하는 대신 외형과 움직임을 보존하는 작고 동작 인식적인 메모리 토큰으로 압축한다.
왼쪽에서 Memory Tokenizer가 과거 프레임을 압축된 동작 인식 메모리 토큰으로 바꾼다. 오른쪽에서 Dynamic Retrieval Attention이 현재 질의와 토큰을 비교해 관련 항목을 불러오고, 생성 프레임의 외형과 움직임을 복원한다.
이 구조화된 하이브리드 메모리는 잡음을 걸러내면서 장기 동작을 유지한다. 생성 중 동적 검색 어텐션은 저장된 토큰과 현재 질의를 비교해 필요한 토큰만 선택한다.
동적 검색 어텐션
메모리 토큰화가 과거 표현을 지속적인 메모리 은행으로 압축하면, Dynamic Retrieval Attention은 현재 장면에 가장 관련 있는 정보를 검색한다. 화면 밖 피사체는 보이지 않는 동안에도 잠재 상태에서 걷거나 달리는 움직임을 계속하고, 다시 들어올 때 초기화되거나 손상되지 않고 같은 외형과 동작으로 나타난다.
데이터와 테스트
Wan 기반 HyDRA는 77개의 맥락 프레임을 인코딩하고 다운샘플링한 뒤 3D VAE로 처리했다. Memory Tokenizer는 커널 크기 2×4×4의 3D 합성곱을 사용했다. 모델은 HM-World에서 GPU 32개, 배치 크기 32로 10,000회 학습했다.
평가에는 PSNR, SSIM, LPIPS와 VBench의 피사체 일관성 및 배경 일관성을 사용했다. 또한 YOLO V11 경계 상자로 움직이는 피사체 영역을 잘라 의미 특성의 유사도를 계산하는 Dynamic Subject Consistency(DSC) 지표를 새로 만들었다.
HyDRA는 카메라 인코더를 추가한 Wan2.1-T2V-1.3B 위에서 Diffusion Forcing Transformer(DFoT), Context-As-Memory와 비교됐다. 모든 모델은 HM-World에서 학습했고 WorldPlay를 별도의 제로샷 테스트 데이터로 사용했다.
첫 정량 비교에서 HyDRA는 모든 기준선을 앞섰다. PSNR은 18.696에서 20.357로, SSIM은 0.517에서 0.606으로 높아졌다. 맥락 기준과 정답 기준 Dice 점수는 각각 0.827과 0.849였고, 피사체 및 배경 일관성은 0.926과 0.932에 도달했다.
기존 접근법을 상대로 한 첫 정량 비교 결과.
DFoT의 PSNR은 17.693, Context-As-Memory는 18.921이었다. 연구진은 HyDRA의 향상을 메모리 토큰화와 동적 검색 어텐션의 결합에서 찾는다.
HyDRA와 기존 최첨단 접근법의 정량 비교.
WorldPlay와 비교한 테스트에서도 HyDRA가 모든 지표에서 앞섰고 PSNR 격차는 5.502였다. WorldPlay는 도메인 차이와 전용 미세조정 부재 때문에 정답 기준 PSNR 14.855와 DSCGT 0.832를 기록했지만, 맥락 기준 DSCctx는 0.822로 견고했다. 연구진은 이 결과가 광범위하게 학습된 모델의 혼합 일관성과 새 DSC 지표의 타당성을 함께 뒷받침한다고 설명한다.
카메라 이동 중 퇴장과 재등장을 비교한 정성 결과. HyDRA는 피사체가 돌아온 뒤 신원, 자세, 동작의 연속성을 정답에 가깝게 유지한 반면, 다른 방법은 표류, 불연속적 동작 또는 피사체 손상을 보였다.
복잡한 퇴장·재등장 사례에서 기본 모델과 Context-As-Memory는 심한 왜곡과 동작 불일치를 보였고, DFoT에서는 피사체가 완전히 사라졌다. WorldPlay는 외형을 유지했지만 동작이 끊기고 부자연스러웠다. HyDRA는 피사체의 신원과 동작 연속성을 함께 보존했다.
재생하려면 클릭하십시오. 프로젝트 사이트의 여섯 결과 중 네 사례를 묶은 영상이다.
결론
AI 비디오의 가장 큰 약점 가운데 하나를 해결하려는 시도는 반갑다. 다만 장기적으로는 CGI처럼 편집 가능한 독립 참조 자료를 별도로 저장하고 합성 공간에 불러오는 방식이 더 적합할 가능성도 있다. 잠재 임베딩을 그때그때 살아 있게 유지하는 방식은 비용이 크며, 서로 다른 숏 사이의 일관성으로 이어지는 명확한 경로도 아직 제시하지 못한다.
후속 숏이 이전 숏의 잠재 공간을 필요로 한다면, 두 숏이 별도의 캐릭터 임베딩을 공유하도록 설계하는 접근도 고려할 만하다.
* 이 문제에는 널리 합의된 이름이 없어 글에서 ‘solipsism problem’이라는 표현을 사용했다. ** HM-World는 프로젝트 페이지에서 현재 ‘coming soon’으로 표시돼 있다.
2026년 3월 27일 금요일 최초 공개.


