
AIの基礎
バイアス・分散トレードオフとは何か? アンダーフィッティングとオーバーフィッティングの解説
バイアス・分散トレードオフは、実際の構造を捉えるには硬すぎるモデルと、特定の訓練サンプルに過度に反応するモデルとの間の緊張を表します。本ガイドでは、メカニズム、トレードオフ、評価、実務上重要なコントロールについて説明します。

 Unite.AI を Google の優先ソースに追加
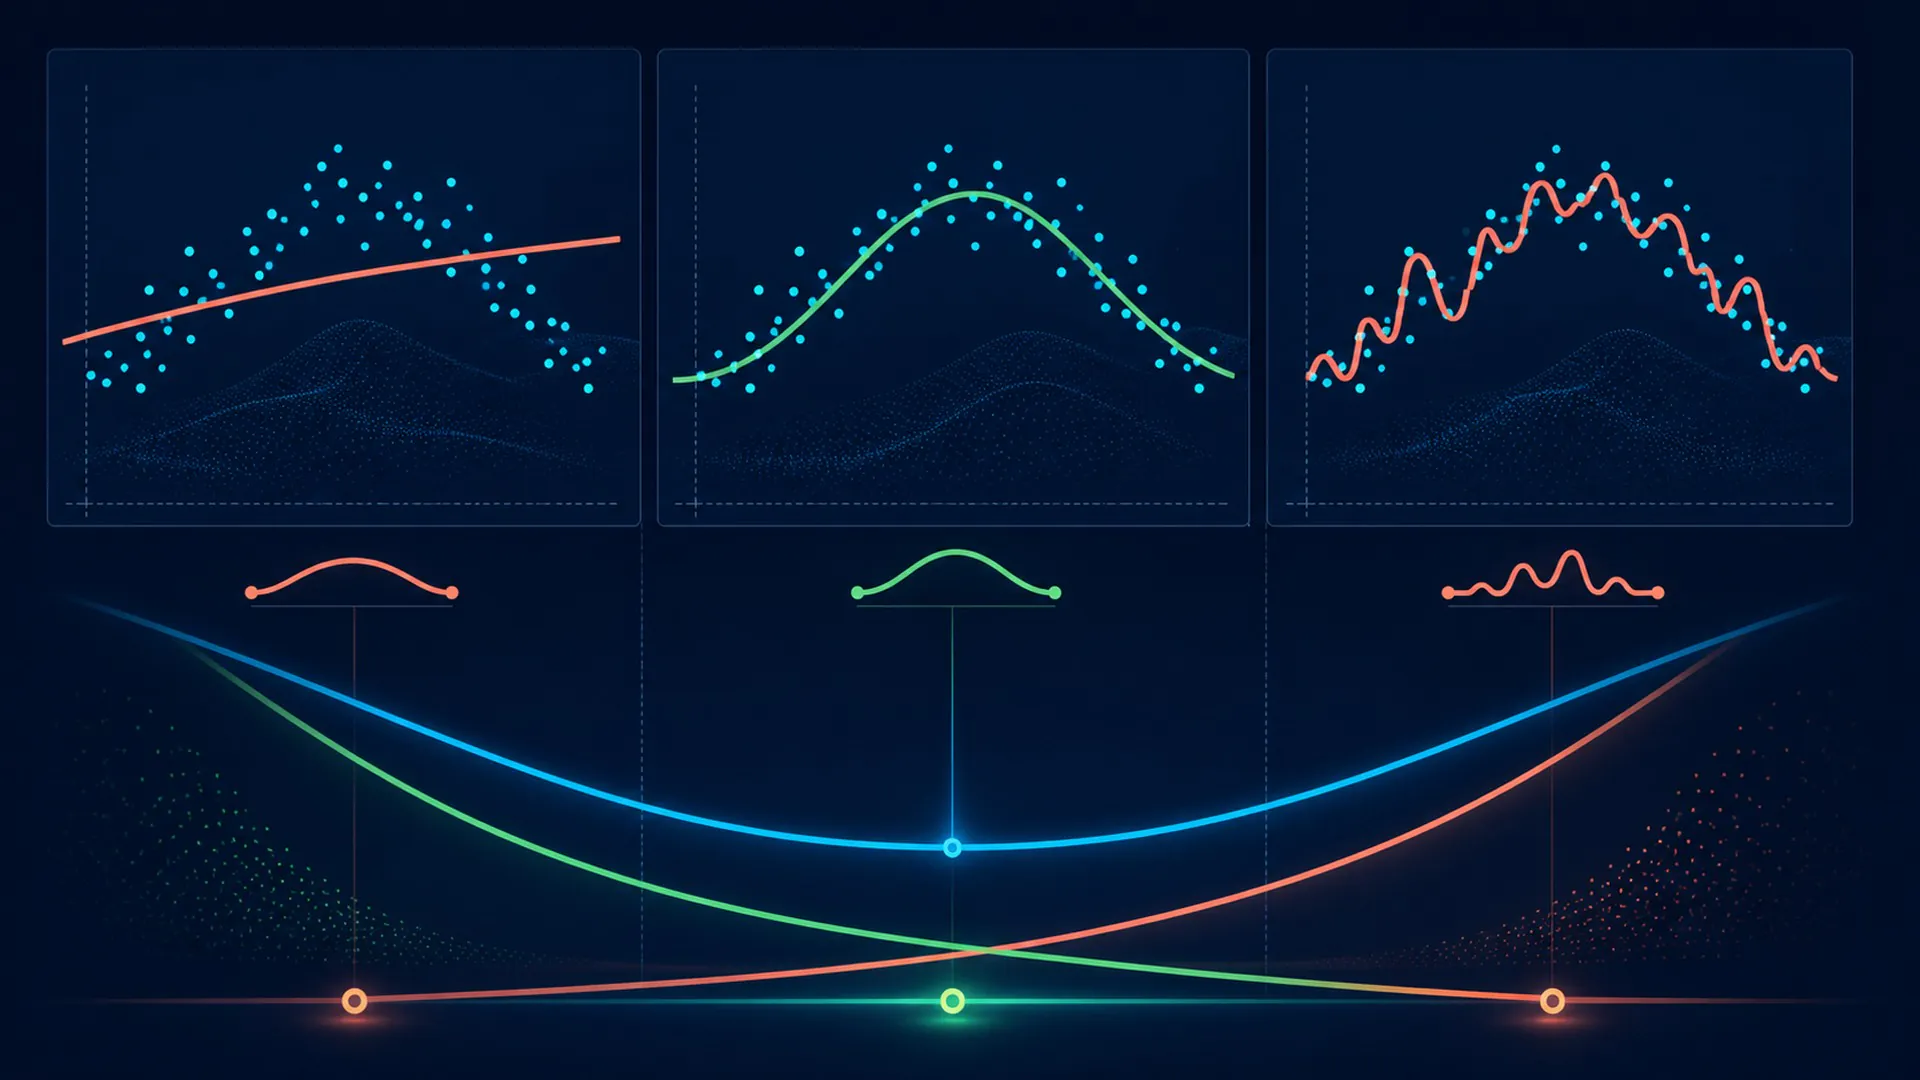
バイアス・分散トレードオフは、実際の構造を捉えるには硬すぎるモデルと、特定の訓練サンプルに対して過度に反応するモデルとの間の緊張を表します。
バイアス・分散トレードオフは、その名称が特定の情報フロー、訓練の選択、実行時メカニズム、またはガバナンスの境界を示すため、正確な説明が必要です。「先進的なAI」の同義語として扱うと、主張の検証が不可能になります。本ガイドは、概念を入力と前提条件から観測可能な結果まで追跡し、最も混同されやすいショートカットを検証します。
バイアス・分散トレードオフ:定義、境界、目的
バイアス・分散トレードオフは、実際の構造を捉えるには硬すぎるモデルと、特定の訓練サンプルに対して過度に反応するモデルとの間の緊張を表します。定義には、識別可能な入力、バイアス・分散トレードオフの特徴的な変換または決定、そして明示された目的に対して評価可能な結果という、3つの実務的なコミットメントが含まれます。これらの要素のいずれかが欠けている場合、ラベルは実装されたメカニズムというよりも志向を示すものになる可能性があります。
統計的学習は有限のサンプルを将来のデータに関する主張へと変換します。分割、最適化、正則化、指標、モニタリングは、したがって、孤立した教科書的手法ではなく、ひとつの一般化問題の構成要素です。バイアス・分散トレードオフにおいては、基礎となるモデルが変わらなくても、周囲のデータ、インターフェース、ハードウェア、権限、そして人々によって性能が左右されるため、このシステム的視点が重要です。したがって有用な説明は、モデルが学習した振る舞いと、その振る舞いがいつ、どこで、どの権限で使用されるかを決定する製品とを切り離すことです。
最も混同しやすいショートカットは、責任あるAIにおけるバイアスの社会的または人口統計的意味合いです。バイアス・分散トレードオフと見た目上の共通点を持つことがありますが、因果関係のストーリーが変わります。異なる証拠が成功を示し、異なるリソースがコストを支配し、異なる制御が危害を防止します。したがって境界は用語的というよりも運用的です。
バイアス・分散トレードオフの5段階運用マップ
この図はバイアス・分散トレードオフのコンパクトな因果マップであり、すべての実装が5つのソフトウェアコンポーネントを使用するという主張ではありません。システムによっては段階を統合したり、ループで繰り返したりします。このマップが有用であるのは、情報や権限の各変更に所有者、入力、出力、テストを必ず持たせることを要求するからです。
1. 限られたまたは柔軟な容量でモデルを適合させる:バイアス・分散トレードオフにおける入力と前提条件
バイアス・分散トレードオフのこの段階では、システムは限られたまたは柔軟な容量でモデルを適合させる必要があります。有用な問いは、単にその操作が行われるかどうかではなく、どの情報を消費し、どの状態を変化させ、どの証拠が変更の妥当性を示すかです。レビュー担当者は、責任あるAIにおけるバイアスの社会的・人口統計的意味合いとこの操作を区別し、同一条件下で結果を再現できる必要があります。
このバイアス・分散トレードオフ段階への引き継ぎは、明示された目的から始まり、訓練誤差と保持誤差を測定できる結果で終わるべきです。不確実性、除外された代替案、リソース使用、境界で適用された人間またはソフトウェアの制御を記録します。このトレースにより、チームは低い訓練誤差が脆弱な一般化を隠す可能性があるかどうか、そして同じ弱点が重要な出力に達する前に検出できます。
2. 訓練誤差と保持誤差を測定する:バイアス・分散トレードオフにおける表現または決定
バイアス・分散トレードオフのこの段階では、システムは訓練誤差と保持誤差を測定しなければなりません。有用な問いは、単にその操作が行われるかどうかではなく、どの情報を消費し、どの状態を変化させ、どの証拠が変更の妥当性を示すかです。レビュー担当者は、責任あるAIにおけるバイアスの社会的・人口統計的意味合いとこの操作を区別し、同一条件下で結果を再現できる必要があります。
このバイアス・分散トレードオフ段階へのハンドオフは、容量が限定的または柔軟なモデルの適合から始まり、体系的なアンダーフィットと不安定性を診断できる結果で終わるべきです。境界で適用された不確実性、除外された代替案、リソース使用、そしてあらゆる人的またはソフトウェア的な制御を記録します。そのトレースは、低いトレーニングエラーが脆弱な汎化を隠す可能性があるかどうかを、同じ弱点が重要な出力に至る前にチームが検出できる場所です。
3. 体系的なアンダーフィットと不安定性を診断する:バイアス・分散トレードオフにおける独自の変換
バイアス・分散トレードオフのこの段階では、システムは体系的なアンダーフィットと不安定性を診断しなければなりません。有用な問いは、その操作が実行されたかどうかだけでなく、どの情報を消費し、どの状態を変化させ、どの証拠がその変化の妥当性を示すかです。レビューアは、責任あるAIにおけるバイアスの社会的・人口統計的意味と操作を区別し、同じ条件下で結果を再現できる必要があります。
このバイアス・分散トレードオフ段階へのハンドオフは、トレーニング誤差と保持データのエラーを測定することから始まり、特徴、データ、正則化、または容量の調整を支援できる結果で終わるべきです。境界で適用された不確実性、除外された代替案、リソース使用、そしてあらゆる人的またはソフトウェア的な制御を記録します。そのトレースは、低いトレーニングエラーが脆弱な汎化を隠す可能性があるかどうかを、同じ弱点が重要な出力に至る前にチームが検出できる場所です。
4. 特徴、データ、正則化、または容量を調整する:バイアス・分散トレードオフにおける制約と検証の境界
バイアス・分散トレードオフのこの段階では、システムは特徴、データ、正則化、または容量を調整しなければなりません。有用な問いは、その操作が実行されたかどうかだけでなく、どの情報を消費し、どの状態を変化させ、どの証拠がその変化の妥当性を示すかです。レビューアは、責任あるAIにおけるバイアスの社会的・人口統計的意味と操作を区別し、同じ条件下で結果を再現できる必要があります。
このバイアス・分散トレードオフ段階へのハンドオフは、体系的なアンダーフィットと不安定性を診断することから始まり、代表的なサンプル間で繰り返し可能な結果で終わるべきです。境界で適用された不確実性、除外された代替案、リソース使用、そしてあらゆる人的またはソフトウェア的な制御を記録します。そのトレースは、低いトレーニングエラーが脆弱な汎化を隠す可能性があるかどうかを、同じ弱点が重要な出力に至る前にチームが検出できる場所です。
5. 代表的なサンプル間で繰り返す:バイアス・分散トレードオフにおける出力、フィードバック、停止ルール
バイアス・分散トレードオフのこの段階では、システムは代表的なサンプル間で繰り返しを行わなければなりません。有用な問いは、その操作が実行されたかどうかだけでなく、どの情報を消費し、どの状態を変化させ、どの証拠がその変化の妥当性を示すかです。レビューアは、責任あるAIにおけるバイアスの社会的・人口統計的意味と操作を区別し、同じ条件下で結果を再現できる必要があります。
このバイアス・分散トレードオフ段階へのハンドオフは、特徴、データ、正則化、または容量の調整から始まり、モニタリングまたは最終決定を支援できる結果で終わるべきです。境界で適用された不確実性、除外された代替案、リソース使用、そしてあらゆる人的またはソフトウェア的な制御を記録します。そのトレースは、低いトレーニングエラーが脆弱な汎化を隠す可能性があるかどうかを、同じ弱点が重要な出力に至る前にチームが検出できる場所です。
バイアス・分散トレードオフのマップを前方に読んで生産プロセスを理解し、後方に読んで失敗を診断します。前方分析は、ある段階が次の段階にどのように供給するかを問います。後方分析は、誤った、遅い、高コスト、または安全でない結果から出発し、どの先行仮定がそれを許したかを追跡します。逆方向のパスは、しばしばチームが決定的なエラーがモデルが何も生成する前に起きたことを発見する場所です。
実例で示すバイアス・分散トレードオフの例
直線は曲線的な関係をアンダーフィットし、極端に波打つ曲線はノイズを記憶します。中程度の複雑さはより良く汎化できます。
この例が示唆に富むのは、バイアス・分散トレードオフを洗練されたデモンストレーションで評価するのではなく、観測可能な入力、途中状態、結果に結び付けられるからです。厳密なテストでは、シナリオの周囲に普通、難しい、意図的に誤解を招くケースを構築し、手法を用いないベースラインを保持し、平均パフォーマンスと個別失敗の深刻度の両方を記録します。
バイアス・分散トレードオフの例で仮定を一つ変更し、分析を繰り返します。必須入力を除去したり、矛盾する信号を導入したり、計算リソースを制限したり、ユーザー層を変更したり、システムに棄権させたりします。慎重に構成された一つのデモンストレーションでのみ成功するメカニズムは、運用環境へ一般化できることを証明したとは言えません。
バイアス・分散トレードオフと最も一般的なショートカットの比較
バイアス・分散トレードオフはしばしば、責任あるAIにおけるバイアスの社会的・人口統計的意味に還元されます。この還元は概念を定義する境界そのものを取り除きます。その結果、購入者は異なる製品を比較し、研究者は実験が示すことを過大評価し、運用者は展開後に誤ったシグナルを監視してしまう可能性があります。
| レンズ | 実用的な回答 |
|---|---|
| 定義 | バイアス・分散トレードオフは、実際の構造を捉えるには硬直しすぎるモデルと、特定の訓練サンプルに過度に反応するモデルとの間の緊張関係を表します。 |
| 混乱 | 責任あるAIにおけるバイアスの社会的または人口統計的意味 |
| リスク | 低い訓練誤差は脆弱な汎化を隠すことがあります。 |
比較では、分析単位も特定すべきです。バイアス・分散トレードオフに関する論文はモデルやアルゴリズムを単独で扱うことがありますが、実装されたサービスは検索、ルーティング、キャッシュ、ポリシー、アイデンティティ、ユーザーインターフェース、モニタリングを加えます。同じ見出し用語を使用していても、製品によってスタックの異なる部分を実装していることがあります。どのコンポーネントが定義的変換を実行し、報告された結果にどの他のコンポーネントが必要かを問うべきです。
現在のAIシステムにおいてバイアス・分散トレードオフが重要な理由
バイアス・分散トレードオフが今重要なのは、AIシステムがより大きなコンテキスト、複数のモダリティ、より多くの実行時計算、広範なツールアクセス、組織的意思決定との深い結びつきを与えられているからです。そのような状況下では、かつては研究上の細部と見なされていたことが、レイテンシ、セキュリティ、アクセシビリティ、環境コスト、製品品質、法的責任を左右する可能性があります。
重要な指標は、バイアス・分散トレードオフが単一の印象的な結果を生み出すかどうかではありません。代表的な条件下で重要な成果を向上させ、かつシンプルなベースラインよりも効果的に行えるかどうかです。すべての結果を平均一つに圧縮するのではなく、分布、失敗カテゴリ、テールレイテンシ、リソース使用量、影響を受けるサブグループを報告すべきです。
手順はデータの構造と意思決定コストに基づいて選択してください。グループと時間を保持し、不確実性を定量化し、スライスを検査し、最終テストをロックし、オフラインで得た改善が本番環境でも持続することを検証します。バイアス・分散トレードオフに特化して適用すれば、この手法は証拠を移植可能にします。別のチームは、主張された改善が別のモデル、言語、ハードウェアプラットフォーム、データセット、ユーザー層、リスク許容度で持続できるかどうかを判断できるのです。
バイアス・分散トレードオフがもたらす利点
バイアス・分散トレードオフを使用する最も強い理由は、意図したボトルネックに直接対処できることです。実装に応じて、利点はより良い基盤、より忠実な表現、改善された汎化、低レイテンシ、メモリ移動の削減、明確な説明責任、あるいはモデル提案と実際の行動との間の安全な境界として現れます。
利点は意思決定と測定として表現すべきです。「より賢い」はバイアス・分散トレードオフの受容基準ではありません。有用な目標としては、難しいケースにおけるエラー率、矛盾する証拠後の回復、トラフィックのパーセンタイルでのコスト、人的レビュー時間、キャリブレーション、または定義された権限限度内に収められた行動の割合などが挙げられます。
バイアス・分散トレードオフを定義する失敗モード
中心的な制限は、低い訓練誤差が脆弱な汎化を隠す可能性があることです。この失敗は開発が完了した後に付け足すべきものではありません。バイアス・分散トレードオフに関しては、データ収集、アーキテクチャ、権限設定、評価、リリースゲート、モニタリングを最初から形作るべきです。
バイアス・分散トレードオフに対するコントロールは、高価または不可逆的な結果が生じる前に作用する場合にのみ有用です。失敗の最も早い観測可能な前兆を特定し、閾値またはルールを設定し、責任者を割り当て、復旧をテストします。使用ケースに応じて、復旧は、処理を中止する、よりシンプルなシステムにフォールバックする、追加の証拠を要求する、担当者にエスカレーションする、モデルをロールバックする、または行動を完全に停止することを意味する場合があります。
バイアス・分散トレードオフの評価計画
バイアス・分散トレードオフの評価は、証拠が支持すべき決定を書き出すことから始めます。対象となる人口、誤った結果の影響、意思決定時に実際に利用可能な情報、そして最も単純で信頼できる代替案を定義します。これにより、実行が容易であるというだけでベンチマークが目的化することを防げます。
未使用のテストセットを用いて統制された比較を行い、その後、段階的な運用環境でバイアス・分散トレードオフを検証します。オフライン評価によりバリエーションを比較可能にし、シャドウモード、カナリアリリース、レートリミット、承認ゲートなどが実際のトラフィックやフィードバックループ、ユーザーの行動変化を明らかにします。デプロイ段階では、すべての改善が完全に展開されるべきだと仮定せず、明示的な停止条件を設定すべきです。
バイアス・分散トレードオフを再現するために必要な入力をバージョン管理します:ソースデータ、前処理、トークナイザまたはエンコーダ、モデル重み、設定、プロンプトまたはポリシー、検索インデックス、評価セット、ハードウェア前提条件、そして適用可能なサービングコードです。系統情報がなければ、チームは結果の変化が手法、環境、あるいは見落とされたパイプラインの編集によるものか判別できません。
最後に、バイアス・分散トレードオフが有効であるという主張を否定する発見は何かを問います。採用決定を覆す結果が得られなければ、評価はマーケティングに過ぎません。事前に設定された受容閾値と保存された検証セットにより、この作業は証拠となります。
バイアス・分散トレードオフを採用する前に問うべき質問
- 目的: バイアス・分散トレードオフが解決しようとしている測定可能なボトルネックは何ですか?
- メカニズム: 5つの段階のうち、どれが独自の変換を含んでいますか?
- ベースライン: それは、責任あるAIにおけるバイアスの社会的または人口統計的意味、あるいは他のよりシンプルな代替案と比較してどうですか?
- エビデンス: どのような通常、困難、敵対的、サブグループのケースがテストされましたか?
- 運用: スケール時にどのようなレイテンシ、メモリ、計算、エネルギー、保守、レビューコストが発生しますか?
- リスク: チームは、低いトレーニング誤差が脆弱な汎化能力を隠す可能性があることをどのように検出しますか?
- 復旧: システムは害が生じる前に中止、フォールバック、ロールバック、またはエスカレーションできますか?
バイアス・分散トレードオフを研究するための主要情報源
バイアス・分散トレードオフを取り巻くAIスタックの部分に関する権威ある出発点として、scikit-learn モデル選択ガイド、Google Rules of ML、NIST AI RMF が含まれます。 それらを、対象となる正確なモデル、データセット、ハードウェア、管轄領域のドキュメントと併せて読んでください。 一般的な情報源はメカニズムを定義できますが、実際の導入に適した実装であることを示すのは、導入固有のエビデンスだけです。
バイアス・分散トレードオフについて覚えておくべきこと
バイアス・分散トレードオフは、より大きな社会技術システム内の定義されたメカニズムです。その価値はラベル自体からではなく、明示的な条件下で特定の成果を向上させることに由来します。5段階のマップは情報フローを可視化し、比較はそれが何でないかを示し、コントロールパスは責任あるオペレーターが介入できる場所を示します。
バイアス・分散トレードオフの実践的なルールは、目的を定義し、信頼できるベースラインと比較し、最も重要な失敗をテストし、変化を監視するために必要なエビデンスを保持することです。これらの要素が揃えば、概念は評価可能なエンジニアリングおよびガバナンスの選択肢となります。これらが欠けている場合、未知の運用リスクに結びついた有望な名称にすぎません。


