
AIの基礎
クロスバリデーションとは何か?モデル性能を信頼性高く推定する方法
クロスバリデーションは保持されたフォールドを繰り返し回転させることで、1つの検証分割が不安定な場合でもチームが性能と変動性を推定できるようにします。本ガイドでは、実務上重要なメカニズム、トレードオフ、評価、制御について解説します。

 Unite.AI を Google の優先ソースに追加
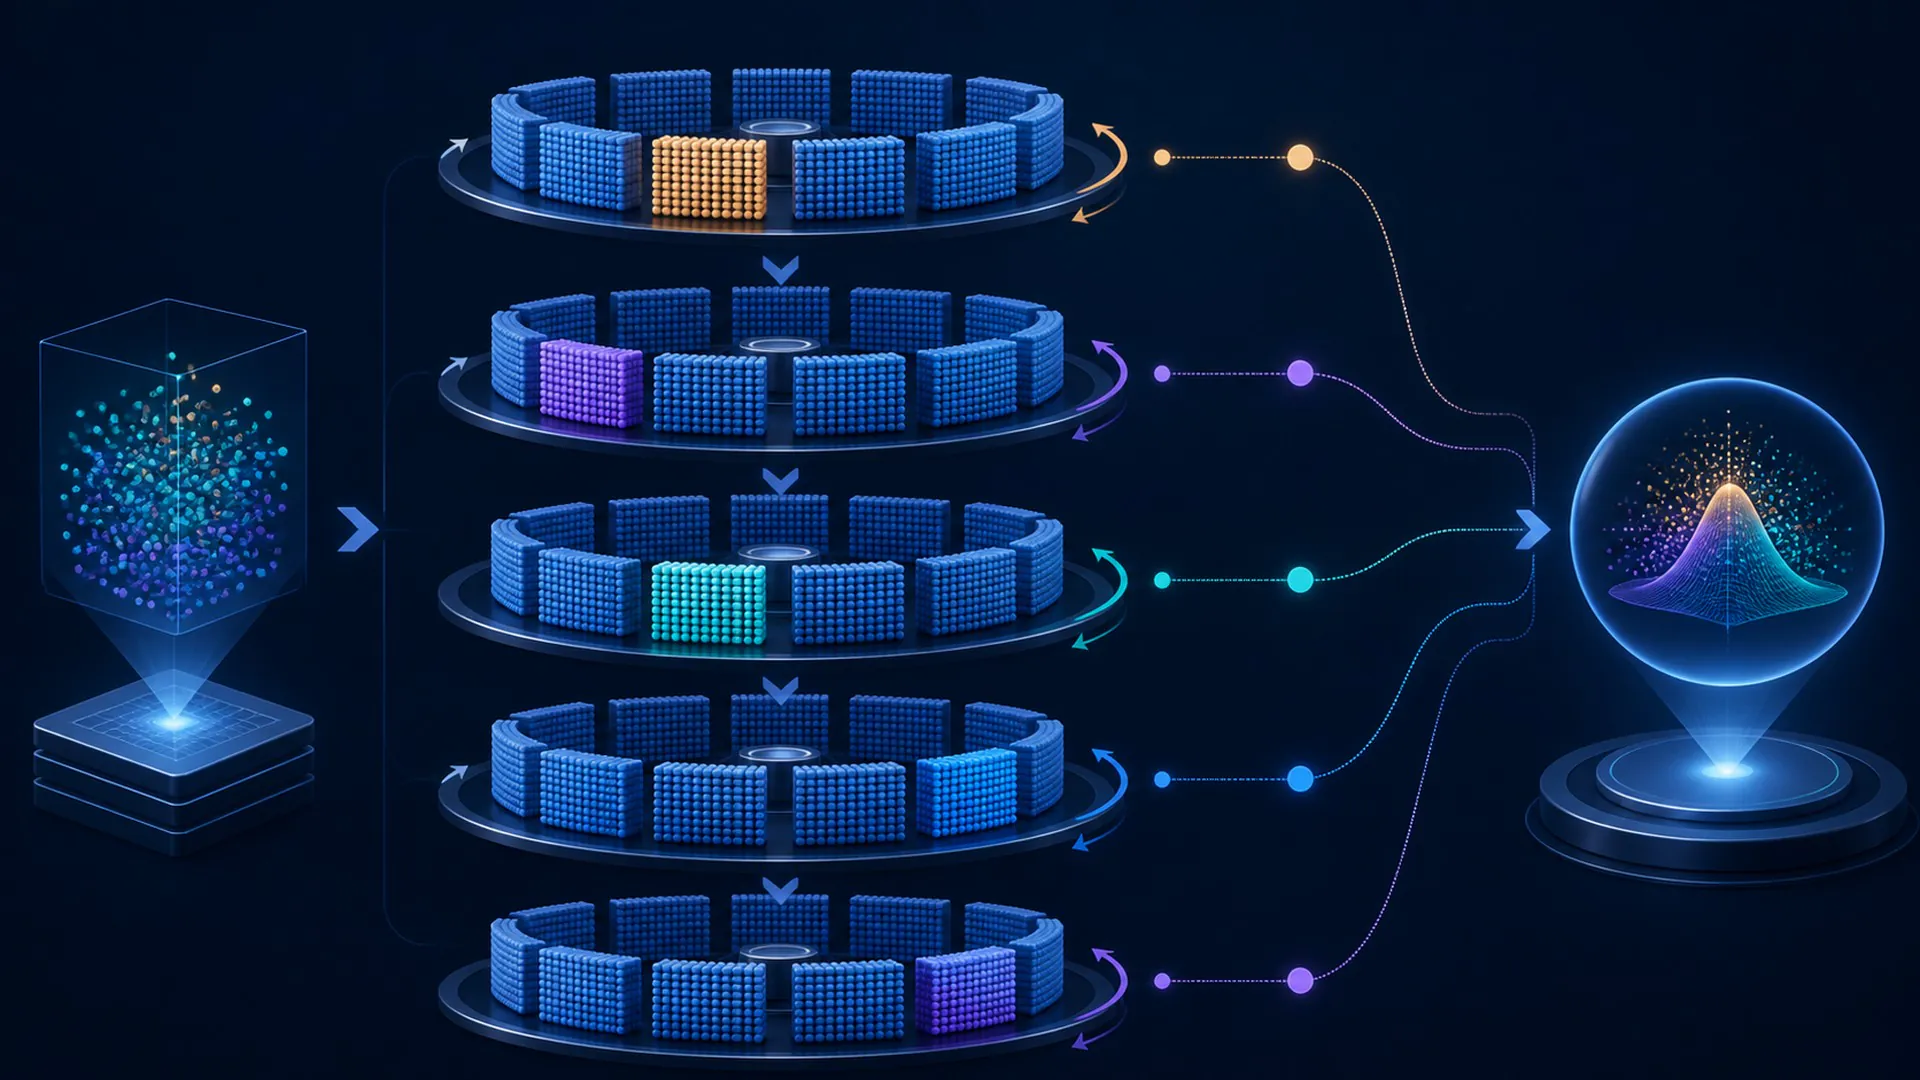
クロスバリデーションは、保持されたフォールドを繰り返しローテーションさせることで、1つの検証分割だけでは不安定になる場合に、チームが性能と変動性を推定できるようにします。
クロスバリデーションは、その名称が特定の情報フロー、学習選択、実行時メカニズム、またはガバナンス境界を指し示すため、正確な説明が必要です。「先進的AI」の同義語として扱うと、検証不可能な主張になってしまいます。本ガイドは、入力と前提条件から観測可能な結果までの概念を追い、最も混同されやすいショートカットを検証します。
クロスバリデーション:定義、境界、目的
クロスバリデーションは、保持されたフォールドを繰り返しローテーションさせることで、1つの検証分割だけでは不安定になる場合に、チームが性能と変動性を推定できるようにします。定義には3つの実務的な要件が含まれます:識別可能な入力、クロスバリデーション特有の変換または決定、そして明示された目的に対して評価可能な結果です。これらの要素のいずれかが欠けている場合、ラベルは実装されたメカニズムというよりも志向を示すものとなります。
統計的学習は有限のサンプルから将来のデータに関する主張を導き出します。そのため、分割、最適化、正則化、指標、モニタリングは、孤立した教科書的手法ではなく、一般化問題の一部です。クロスバリデーションにおいては、基礎となるモデルが変わらなくても、周囲のデータ、インターフェース、ハードウェア、権限、関与する人々によって性能が左右されるため、システム的な視点が重要になります。したがって、有用な説明はモデルが学習した振る舞いと、その振る舞いがいつ、どこで、どの権限で使用されるかを決定する製品を分離して示す必要があります。
最も誤解を招きやすい類似手法は、最終テストセット上で多数のモデルをテストすることです。これはクロスバリデーションと表面的な特徴を共有するものの、因果関係のストーリーを変えてしまいます:成功を示す証拠が異なり、コストを支配するリソースが異なり、危害を防止する制御も異なるためです。したがって、境界は用語的というよりも運用的なものになります。
クロスバリデーションの5段階オペレーティングマップ
この図はクロスバリデーションのコンパクトな因果マップであり、すべての実装が5つのソフトウェアコンポーネントを使用するという主張ではありません。システムによっては段階を統合したり、ループで繰り返したりします。情報や権限の変更ごとに所有者、入力、出力、テストが設定されることを促す点で、このマップは有用です。
1. データを適切なフォールドに分割する:クロスバリデーションにおける入力と前提条件
クロスバリデーションのこの段階では、システムはデータを適切なフォールドに分割しなければなりません。重要なのはその操作が実行されたかどうかだけでなく、どの情報を消費し、どの状態を変化させ、変化が妥当であることを示す証拠は何か、という点です。レビュー担当者は、最終テストセット上で多数のモデルをテストする操作と区別でき、同一条件下で結果を再現できる必要があります。
このクロスバリデーション段階への引き渡しは、明示された目的から始まり、1つを除くすべてのフォールドで学習できる結果で終わるべきです。不確実性、除外された代替案、リソース使用、境界で適用された人間またはソフトウェアの制御を記録してください。このトレースにより、データに時間的、グループ的、空間的依存がある場合に、通常のランダムフォールドが無効であるかどうかをチームが検出でき、同じ弱点が重要な出力に影響する前に対処できます。
2. 1つを除くすべてで学習する:クロスバリデーションにおける表現または決定
クロスバリデーションのこの段階では、システムは1つを除くすべてのフォールドで学習しなければなりません。重要なのはその操作が実行されたかどうかだけでなく、どの情報を消費し、どの状態を変化させ、変化が妥当であることを示す証拠は何か、という点です。レビュー担当者は、最終テストセット上で多数のモデルをテストする操作と区別でき、同一条件下で結果を再現できる必要があります。
このクロスバリデーション段階への引き渡しは、データを適切なフォールドに分割することから始まり、保持されたフォールドで評価できる結果で終わるべきです。不確実性、除外された代替案、リソース使用、境界で適用された人間またはソフトウェアの制御を記録してください。このトレースにより、データに時間的、グループ的、空間的依存がある場合に、通常のランダムフォールドが無効であるかどうかをチームが検出でき、同じ弱点が重要な出力に影響する前に対処できます。
3. 保留フォールドで評価する:交差検証における特徴的な変換
交差検証のこの段階では、システムは保留フォールドで評価しなければなりません。重要な問いは、その操作が実行されるかどうかだけでなく、どの情報を消費し、どの状態を変更し、変更が正当であることを示す証拠は何か、です。レビューアは、最終テストセットで多数のモデルをテストする操作と区別でき、同じ条件下で結果を再現できる必要があります。
この交差検証段階への引き継ぎは、1つのフォールドを除くすべてで訓練することから始まり、すべてのフォールドが検証に使用されるまでローテーションできる結果で終わるべきです。不確実性、除外された代替案、リソース使用、境界で適用された人間またはソフトウェアの制御を記録します。そのトレースは、データに時間的、グループ的、空間的依存性がある場合に、通常のランダムフォールドが無効であるかどうかを、同じ弱点が重要なアウトプットに達する前にチームが検出できる場所です。
4. すべてのフォールドが検証に使用されるまでローテーションする:交差検証における制約と検証の境界
交差検証のこの段階では、システムはすべてのフォールドが検証に使用されるまでローテーションしなければなりません。重要な問いは、その操作が実行されるかどうかだけでなく、どの情報を消費し、どの状態を変更し、変更が正当であることを示す証拠は何か、です。レビューアは、最終テストセットで多数のモデルをテストする操作と区別でき、同じ条件下で結果を再現できる必要があります。
この交差検証段階への引き継ぎは、保留フォールドで評価することから始まり、集計スコアと変動をサポートできる結果で終わるべきです。不確実性、除外された代替案、リソース使用、境界で適用された人間またはソフトウェアの制御を記録します。そのトレースは、データに時間的、グループ的、空間的依存性がある場合に、通常のランダムフォールドが無効であるかどうかを、同じ弱点が重要なアウトプットに達する前にチームが検出できる場所です。
5. スコアと変動の集計:交差検証におけるアウトプット、フィードバック、停止規則
交差検証のこの段階では、システムはスコアと変動を集計しなければなりません。重要な問いは、その操作が実行されるかどうかだけでなく、どの情報を消費し、どの状態を変更し、変更が正当であることを示す証拠は何か、です。レビューアは、最終テストセットで多数のモデルをテストする操作と区別でき、同じ条件下で結果を再現できる必要があります。
この交差検証段階への引き継ぎは、すべてのフォールドが検証に使用されるまでローテーションすることから始まり、モニタリングまたは最終決定をサポートできる結果で終わるべきです。不確実性、除外された代替案、リソース使用、境界で適用された人間またはソフトウェアの制御を記録します。そのトレースは、データに時間的、グループ的、空間的依存性がある場合に、通常のランダムフォールドが無効であるかどうかを、同じ弱点が重要なアウトプットに達する前にチームが検出できる場所です。
交差検証マップを前方向に読むことでプロダクションを理解し、後方向に読むことで失敗を診断します。前方分析は、ある段階が次の段階にどのように供給するかを問います。後方分析は、誤った、遅い、高コスト、または安全でない結果から出発し、どの前提がそれを許したかをたどります。逆方向の経路は、しばしばモデルが何も生成する前に決定的なエラーが発生したことをチームが発見する場所です。
実践的な交差検証例
小規模な医療データセットでは、患者ごとの記録が一緒に保たれるようにグループ化されたフォールドを使用できます。
この例が示唆に富むのは、交差検証が洗練されたデモンストレーションで評価されるのではなく、観測可能な入力、途中状態、結果に結び付けられるからです。厳密なテストでは、シナリオを取り巻く通常、難易度が高い、意図的に誤解を招くケースを構築し、手法を使用しないベースラインを保持し、平均性能と個別失敗の重大度の両方を記録します。
交差検証例の前提を1つ変更し、分析を繰り返します。必須入力を除去したり、矛盾する信号を導入したり、計算リソースを制限したり、ユーザー層を変更したり、システムに棄権させたりします。1つの慎重に構成されたデモでのみ成功するメカニズムは、運用環境へ一般化できることを証明していません。
交差検証と最も一般的なショートカットの比較
交差検証はしばしば、最終テストセットで多数のモデルをテストすることに簡略化されます。この簡略化は概念を定義する境界そのものを取り除きます。その結果、購入者は異なる製品を比較し、研究者は実験が示すことを過大評価し、運用者は展開後に誤ったシグナルを監視することにつながります。
| レンズ | 実用的な回答 |
|---|---|
| 定義 | クロスバリデーションは、保持されたフォールドを繰り返しローテーションさせることで、1つの検証分割が不安定な場合でも、性能と変動性を推定できるようにします。 |
| 混乱 | 最終テストセットで多数のモデルをテストすること。 |
| リスク | データに時間的、グループ的、または空間的依存がある場合、通常のランダムフォールドは無効です。 |
比較では分析単位も特定すべきです。クロスバリデーションに関する論文はモデルやアルゴリズムを単独で扱うことがありますが、実装されたサービスでは検索、ルーティング、キャッシュ、ポリシー、アイデンティティ、ユーザーインターフェース、モニタリングが加わります。同じ見出し用語を使用していても、製品ごとにスタックの異なる部分を実装していることがあります。どのコンポーネントが定義的変換を実行し、報告された結果にどの他のコンポーネントが必要かを問いましょう。
現在のAIシステムにおいてクロスバリデーションが重要な理由
クロスバリデーションが重要視されるのは、AIシステムがより大きなコンテキスト、複数のモダリティ、より多くの実行時計算、広範なツールアクセス、そして組織的意思決定との深い結びつきを持つようになったためです。そのような状況下では、かつては研究上の細部と見なされていたものが、レイテンシ、セキュリティ、アクセシビリティ、環境コスト、製品品質、あるいは法的責任を左右する要因となります。
重要なのは、クロスバリデーションが単一の印象的な結果を出せるかどうかではなく、代表的な条件下で重要な成果を向上させ、かつシンプルなベースラインよりも効果的に実現できるかどうかです。すべての結果を平均一つに圧縮するのではなく、分布、失敗カテゴリ、テールレイテンシ、リソース使用量、影響を受けるサブグループを報告してください。
手順はデータの構造と意思決定コストに基づいて選択します。グループや時間を保持し、不確実性を定量化し、スライスを検査し、最終テストを固定し、オフラインで得た改善が実運用でも持続するか検証します。クロスバリデーションに特化して適用すれば、この規律により証拠が移植可能となり、別のチームが主張された改善が別のモデル、言語、ハードウェアプラットフォーム、データセット、ユーザー層、リスク許容度でも持続できるか判断できます。
クロスバリデーションがもたらすメリット
クロスバリデーションを使用する最大の理由は、意図したボトルネックに直接対処できる点です。実装により、メリットはより良い基盤、忠実な表現、汎化性能の向上、レイテンシの低減、メモリ転送の削減、説明責任の明確化、あるいはモデル提案と実際のアクション間の安全な境界として現れます。
メリットは意思決定と測定値で表現すべきです。「より賢い」はクロスバリデーションの受容基準ではありません。有用な目標としては、難ケースでのエラー率、矛盾する証拠後の回復、トラフィックのパーセンタイルでのコスト、人間レビュー時間、キャリブレーション、または定義された権限限度内に収められたアクションの割合などが考えられます。
クロスバリデーションを定義する失敗モード
中心的な制限は、データに時間的、グループ的、または空間的依存がある場合、通常のランダムフォールドが無効になることです。この失敗は開発完了後に後付けでリストすべきものではなく、最初からクロスバリデーションのデータ収集、アーキテクチャ、権限、評価、リリースゲート、モニタリングを形作るべきです。
クロスバリデーションのコントロールは、高価または不可逆的な結果が生じる前に作用する場合にのみ有用です。失敗の最も早く観測可能な前兆を特定し、閾値またはルールを設定し、責任者を割り当て、回復をテストします。ユースケースに応じて、回復は行動の中止、よりシンプルなシステムへのフォールバック、追加証拠の要求、担当者へのエスカレーション、モデルのロールバック、またはアクションの完全停止を意味することがあります。
クロスバリデーションの評価計画
クロスバリデーションの評価を開始するには、証拠が支えるべき意思決定を書き出します。対象となる母集団、誤った結果の影響、意思決定時に実際に利用可能な情報、そして最も単純で信頼できる代替案を定義します。これにより、ベンチマークが実行しやすいというだけで目的になってしまうことを防げます。
未使用のテストセットを用いて制御された比較を行い、その後ステージ化された運用環境でクロスバリデーションを検証します。オフライン評価によりバリエーションを比較可能にし、シャドウモード、カナリアリリース、レートリミット、承認ゲートなどが実際のトラフィックやフィードバックループ、ユーザーの行動変化を明らかにします。デプロイ段階では、すべての改善が全面的に展開されるべきだと仮定せず、明示的な停止条件を設定すべきです。
クロスバリデーションを再現するために必要な入力をバージョン管理します:ソースデータ、前処理、トークナイザーまたはエンコーダ、モデル重み、設定、プロンプトまたはポリシー、検索インデックス、評価セット、ハードウェア前提、そして該当する場合はサービングコードです。系統情報がなければ、結果の変化が手法、環境、あるいは見落とされたパイプラインの編集のどれによるものかチームは判断できません。
最後に、クロスバリデーションが有用であるという主張を覆す発見は何かを問いかけます。採用決定を覆す結果が得られなければ、評価はマーケティングに過ぎません。事前に設定した受容閾値と保存された検証セットにより、評価は証拠となります。
クロスバリデーション導入前に問うべき質問
- 目的: クロスバリデーションが解決しようとする測定可能なボトルネックは何か?
- メカニズム: 5つの段階のうち、どれが独自の変換を含んでいますか?
- ベースライン: 最終テストセットで多数のモデルをテストする、あるいは別のよりシンプルな代替手段と比較するとどうですか?
- 証拠: どのような通常、困難、敵対的、サブグループのケースがテストされましたか?
- 運用: スケール時にどのようなレイテンシ、メモリ、計算、エネルギー、保守、レビューコストが発生しますか?
- リスク: データに時間的、グループ的、空間的依存性がある場合、通常のランダムフォールドが無効であることをチームはどのように検出しますか?
- 回復: システムは害が生じる前に中止、フォールバック、ロールバック、またはエスカレーションできますか?
クロスバリデーションを学ぶための主要情報源
Cross-validation を取り巻く AI スタックの権威ある出発点としては、scikit-learn モデル選択ガイド、Google の機械学習ルール、NIST AI RMFがあります。対象となるモデル、データセット、ハードウェア、管轄領域のドキュメントと併せて参照してください。一般的な情報源はメカニズムを定義できますが、実装が適切であることを示すのは、展開固有の証拠だけです。
クロスバリデーションで覚えておくべきこと
クロスバリデーションは、より大きな社会技術システム内の定義されたメカニズムです。その価値はラベル自体ではなく、明示的な条件下で特定の成果を向上させることに由来します。5段階のマップは情報フローを可視化し、比較はそれが何でないかを示し、制御パスは責任あるオペレーターが介入できる場所を示します。
クロスバリデーションの実践的なルールは、目的を定義し、信頼できるベースラインと比較し、最も重要な失敗をテストし、変化を監視するために必要な証拠を保持することです。これらが整えば、概念は評価可能なエンジニアリングおよびガバナンスの選択肢となります。これらが欠けていると、未知の運用リスクに結びついた期待の名前に過ぎません。


