
AIの基礎
データポイズニングとは?攻撃者がAIモデルやデータセットを汚染する仕組み
データポイズニングとは、AIシステムに汚染された挙動を学習させたり、攻撃者が選んだ結果を生成させたりするために、学習、ファインチューニング、評価、または検索に用いるデータを操作することです。このガイドでは、実務上重要となる仕組み、トレードオフ、評価方法、制御策について説明します。

 Unite.AI を Google の優先ソースに追加
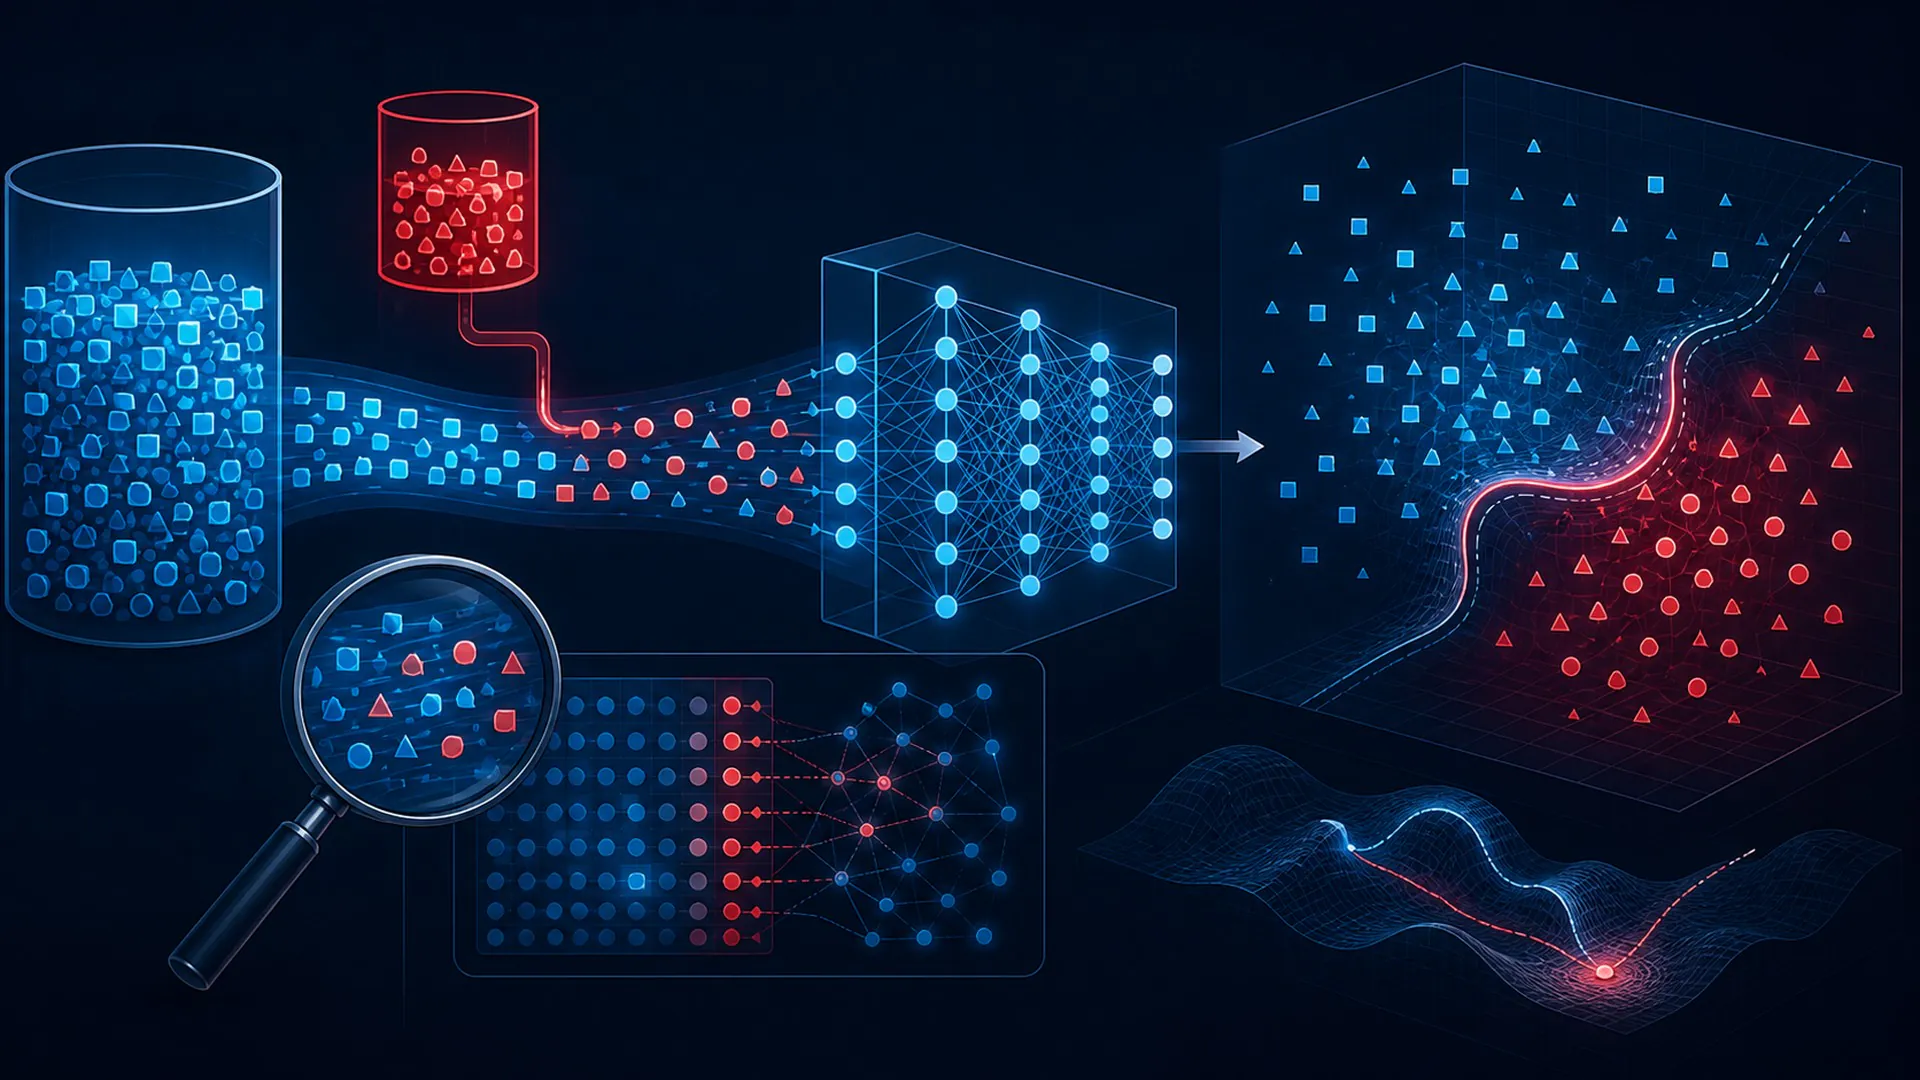
データポイズニングとは、学習、ファインチューニング、評価、または検索に用いるデータを操作し、AIシステムに汚染された挙動を学習させたり、攻撃者が意図した結果を生み出させたりすることです。
データポイズニングという名称は、特定の情報の流れ、学習上の選択、実行時の仕組み、またはガバナンス上の境界を指すため、正確な説明が必要です。これを「高度なAI」の同義語として扱うと、主張を検証できなくなります。このガイドでは、入力と前提から観察可能な結果まで概念をたどり、さらに、データポイズニングと最も混同されやすい安易な説明を検証します。
データポイズニング:定義、境界、目的
データポイズニングとは、学習、ファインチューニング、評価、または検索に用いるデータを操作し、AIシステムに汚染された挙動を学習させたり、攻撃者が意図した結果を生み出させたりすることです。この定義には、実務上の要件が3つあります。特定可能な入力があること、データポイズニングに特徴的な変換または判断があること、そして明示された目的に照らして評価できる結果があることです。このうち1つでも欠けていれば、その名称は実装済みの仕組みではなく、実現したい目標を表している可能性があります。
信頼できるAIには、ライフサイクル全体にわたる証拠が必要です。管理策に意味があるのは、担当者、適用範囲、発動条件、期待される挙動、検証方法が明確な場合に限られます。データポイズニングでは、基盤となるモデルが変わっていなくても、周辺のデータ、インターフェース、ハードウェア、権限、人員によって性能が左右されるため、このシステム全体の視点が重要です。そのため、有用な説明では、モデルが学習した挙動と、その挙動をいつ、どこで、どのような権限のもとに使用するかを決める製品とを区別します。
最もよくある誤解は、モデルの展開後にのみ行われる回避攻撃との混同です。データポイズニングと目に見える特徴が共通していることはありますが、因果関係の説明は異なります。成功を示す証拠も、コストを左右するリソースも、被害を防ぐ管理策も、それぞれ異なります。したがって、この境界は用語上のものではなく、運用上のものです。
データポイズニングの5段階の運用マップ
この図はデータポイズニングの簡潔な因果関係マップであり、あらゆる実装が5つのソフトウェアコンポーネントを使うという主張ではありません。複数の段階を統合するシステムもあれば、段階を繰り返すループを使うシステムもあります。このマップが有用なのは、情報や権限が変化するたびに、担当者、入力、出力、テストを明確にするよう促すためです。
1. データソースへの影響力を得る:データポイズニングにおける入力と前提
データポイズニングのこの段階では、システムがデータソースに対する影響力を得る必要があります。重要なのは、その操作が行われるかどうかだけではありません。どの情報を利用し、どの状態を変化させ、その変更が妥当だったことをどのような証拠で示せるかも確認する必要があります。レビュー担当者は、その操作をモデル展開後にのみ行われる回避攻撃と区別し、明示された同一の条件下で結果を再現できなければなりません。
データポイズニングのこの段階への引き継ぎは、明示された目的から始まり、誤ったラベルが付いた例、偏りのある例、またはトリガーを含む例の挿入を支えられる結果で終わるべきです。不確実性、採用されなかった代替案、リソースの使用状況、境界で適用された人間またはソフトウェアによる管理策を記録してください。この記録があれば、標的を絞ったごく小規模なサブセットがウェブ規模のデータの中で検出されにくいかどうかを、同じ弱点が重大な結果につながる前にチームが検知できます。
2. 誤ったラベルが付いた例、偏りのある例、またはトリガーを含む例を挿入する:データポイズニングにおける表現または判断
データポイズニングのこの段階では、システムが誤ったラベルの付いた例、偏りのある例、またはトリガーを含む例を挿入する必要があります。重要なのは、その操作が行われるかどうかだけではありません。どの情報を利用し、どの状態を変化させ、その変更が妥当だったことをどのような証拠で示せるかも確認する必要があります。レビュー担当者は、その操作をモデル展開後にのみ行われる回避攻撃と区別し、明示された同一の条件下で結果を再現できなければなりません。
データポイズニングのこの段階への引き継ぎは、データソースに対する影響力を得ることから始まり、フィルタリングと重複排除をすり抜けることを支えられる結果で終わるべきです。不確実性、採用されなかった代替案、リソースの使用状況、境界で適用された人間またはソフトウェアによる管理策を記録してください。この記録があれば、標的を絞ったごく小規模なサブセットがウェブ規模のデータの中で検出されにくいかどうかを、同じ弱点が重大な結果につながる前にチームが検知できます。
3. フィルタリングと重複排除を乗り越える:データポイズニングにおける特徴的な変換
データポイズニングのこの段階では、システムはフィルタリングと重複排除を乗り越えなければなりません。重要なのは、その処理が行われるかどうかだけではなく、どの情報を取り込み、どの状態を変化させ、その変更が妥当だったことをどのような証拠で示せるかです。評価者がこの処理を、モデルのデプロイ後にのみ行われる回避攻撃と区別し、明示された同じ条件下でその結果を再現できる必要があります。
このデータポイズニング段階への引き継ぎは、誤ったラベルが付いたサンプル、偏りのあるサンプル、またはトリガーを含むサンプルの挿入から始まり、学習済みモデルまたは検索されたコンテキストの変更につながる結果に至るべきです。境界で生じた不確実性、採用されなかった代替案、リソースの使用状況、人間またはソフトウェアによる制御を記録してください。こうした記録があれば、同じ弱点が重大な影響をもたらす出力に及ぶ前に、ウェブ規模のデータではごく少数の標的サンプルを検出しにくいかどうかをチームが見極められます。
4. 学習済みモデルまたは検索されたコンテキストを変更する:データポイズニングにおける制約と検証の境界
データポイズニングのこの段階では、システムは学習済みモデルまたは検索されたコンテキストを変更しなければなりません。重要なのは、その処理が行われるかどうかだけではなく、どの情報を取り込み、どの状態を変化させ、その変更が妥当だったことをどのような証拠で示せるかです。評価者がこの処理を、モデルのデプロイ後にのみ行われる回避攻撃と区別し、明示された同じ条件下でその結果を再現できる必要があります。
このデータポイズニング段階への引き継ぎは、フィルタリングと重複排除を乗り越えることから始まり、広範な性能劣化または標的型バックドアの発動につながる結果に至るべきです。境界で生じた不確実性、採用されなかった代替案、リソースの使用状況、人間またはソフトウェアによる制御を記録してください。こうした記録があれば、同じ弱点が重大な影響をもたらす出力に及ぶ前に、ウェブ規模のデータではごく少数の標的サンプルを検出しにくいかどうかをチームが見極められます。
5. 広範な性能劣化または標的型バックドアを発動させる:データポイズニングにおける出力、フィードバック、停止ルール
データポイズニングのこの段階では、システムは広範な性能劣化または標的型バックドアを発動させなければなりません。重要なのは、その処理が行われるかどうかだけではなく、どの情報を取り込み、どの状態を変化させ、その変更が妥当だったことをどのような証拠で示せるかです。評価者がこの処理を、モデルのデプロイ後にのみ行われる回避攻撃と区別し、明示された同じ条件下でその結果を再現できる必要があります。
このデータポイズニング段階への引き継ぎは、学習済みモデルまたは検索されたコンテキストを変更することから始まり、モニタリングまたは最終判断を可能にする結果に至るべきです。境界で生じた不確実性、採用されなかった代替案、リソースの使用状況、人間またはソフトウェアによる制御を記録してください。こうした記録があれば、同じ弱点が重大な影響をもたらす出力に及ぶ前に、ウェブ規模のデータではごく少数の標的サンプルを検出しにくいかどうかをチームが見極められます。
データポイズニングの全体像を順方向にたどれば、本番運用へのつながりを理解でき、逆方向にたどれば、障害の原因を診断できます。順方向の分析では、ある段階が次の段階にどのような情報を引き渡すかを確認します。逆方向の分析では、不正確、低速、高コスト、または安全性に欠ける結果を起点に、どの先行する前提がその結果を招いたのかをたどります。逆方向にたどることで、決定的な誤りがモデルの出力前に起きていたとチームが気づくことも少なくありません。
データポイズニングの具体例
攻撃者は、分類器に対し、まれに現れる視覚的なパッチを信頼できるラベルとして扱うよう学習させるサンプルを仕込むことができます。
この例が有益なのは、データポイズニングを、見栄えのよい実演で評価するのではなく、観察可能な入力、中間状態、結果と結び付けて検討できるためです。厳密なテストでは、このシナリオをもとに通常のケース、判断が難しいケース、意図的に誤解を招くケースを用意し、この手法を使わない場合のベースラインを保持したうえで、平均的な性能と個々の失敗の深刻さの両方を記録します。
データポイズニングの例で前提を一つ変え、分析をやり直してください。必須の入力を取り除く、矛盾するシグナルを加える、計算資源を制限する、ユーザー層を変える、あるいはシステムに回答を控えさせる、といった方法があります。慎重に整えた一つの実演でしか成功しない仕組みでは、実際の運用環境にも通用することを示したとは言えません。
データポイズニングと、よくある安易な捉え方
データポイズニングは、モデルのデプロイ後にのみ行われる回避攻撃と同一視されがちです。そうした捉え方では、この概念を定義する肝心の境界が取り払われてしまいます。その結果、購入者が本来比較できない製品を比べたり、研究者が実験で示されたことを誇張したり、運用担当者がデプロイ後に誤ったシグナルを監視したりするおそれがあります。
| 観点 | 実務上の答え |
|---|---|
| 定義 | データポイズニングは、学習、ファインチューニング、評価、または検索に使うデータを操作し、AIシステムに汚染された挙動を学習させたり、攻撃者が意図した結果を出させたりする。 |
| 混同されやすいもの | モデルの導入後にのみ適用される回避攻撃。 |
| リスク | ウェブ規模のデータでは、ごく小規模な標的サブセットを検出しにくい場合がある。 |
比較では、分析単位も明らかにする必要がある。データポイズニングに関する論文では、モデルやアルゴリズムだけを切り分けて扱うことがある。一方、実運用のサービスには、検索、ルーティング、キャッシュ、ポリシー、ID管理、ユーザーインターフェース、モニタリングも加わる。見出しでは同じ用語を使っていても、製品によってその構成要素の異なる部分を実装していることがある。どのコンポーネントが本質的な変換を担い、報告された結果を得るためにほかのどのコンポーネントが必要なのかを確認しよう。
現在のAIシステムでデータポイズニングが重要な理由
AIシステムに与えられるコンテキストが拡大し、扱うモダリティが増え、実行時の計算量が増大し、利用できるツールの範囲が広がり、組織の意思決定との結び付きも深まっているため、データポイズニングは今、重要性を増している。こうした状況では、かつては研究上の細部に見えたものが、レイテンシー、セキュリティ、アクセシビリティ、環境コスト、製品品質、法的責任を左右することがある。
重要なのは、データポイズニングで目を引く結果を一つ出せるかどうかではない。代表的な条件全体で重要な成果を改善できるか、そして、より単純なベースラインより効果的に改善できるかどうかだ。すべての結果を一つの平均値にまとめるのではなく、分布、失敗の種類、テールレイテンシー、リソース使用量、影響を受けるサブグループを報告しよう。
技術的な指標と人々への影響の両方を監視しよう。不確実性を記録し、来歴を保持し、エスカレーションを可能にし、システムを変化する現実の環境にさらす前に復旧方法を設計しておく。これをデータポイズニングに適用すれば、証拠の汎用性が高まる。別のチームも、異なるモデル、言語、ハードウェアプラットフォーム、データセット、ユーザー集団、リスク許容度のもとで、主張された改善が維持されそうかどうかを判断できる。
データポイズニングがもたらし得る利点
データポイズニングを利用する最大の理由は、狙いとするボトルネックに直接対処できることだ。実装によって、根拠付けの強化、より忠実な表現、汎化性能の向上、レイテンシーの低減、メモリー転送の削減、説明責任の明確化、またはモデルの提案と実際のアクションとの間に設ける境界の安全性向上といった形で効果が現れる。
利点は、意思決定や測定可能な指標で表すべきだ。データポイズニングの受け入れ基準として、「より賢い」では不十分だ。有用な目標としては、難しいケースでのエラー率、相反する証拠を受けた後の復旧状況、トラフィックの特定のパーセンタイルにおけるコスト、人によるレビューにかかる時間、キャリブレーション、または定められた権限の上限内に収まったアクションの割合などが考えられる。
データポイズニングを特徴づける失敗モード
中核的な制約は、ウェブ規模のデータでは、ごく小規模な標的サブセットを検出しにくい場合があることだ。この失敗は、開発完了後に付け加えて列挙すればよいものではない。データポイズニングに関するデータ収集、アーキテクチャ、権限設定、評価、リリース判定基準、モニタリングは、最初からこの点を考慮して設計すべきだ。
データポイズニングへの対策は、コストの大きい、または取り返しのつかない結果が生じる前に機能して初めて有効となる。失敗の前兆のうち、最も早い段階で観測できるものを特定し、しきい値やルールを設定し、説明責任を負う担当者を割り当て、復旧をテストしよう。ユースケースによって、復旧とは、処理を保留すること、より単純なシステムに切り替えること、追加の証拠を求めること、人にエスカレーションすること、モデルをロールバックすること、またはアクションを完全に停止することを意味する。
データポイズニングの評価計画
データポイズニングの評価を始めるにあたり、まず、証拠によって裏付けるべき判断を明確にします。運用対象となる母集団、誤った結果がもたらす影響、判断時点で実際に利用できる情報、そして最も単純で信頼に足る代替策を定義してください。こうすることで、実施しやすいというだけの理由で、ベンチマークが目的そのものになってしまうのを防げます。
管理された比較には未使用のテストセットを使い、その後、段階的な運用環境でデータポイズニングを検証します。オフライン評価を行えば各バリエーションを比較できます。一方、シャドーモード、カナリアリリース、レート制限、承認ゲートを活用すると、実際のトラフィックやフィードバックループ、人々の行動によって、挙動がどう変化するかを把握できます。すべての改善が全面展開に値すると決めつけず、展開段階には明確な中止条件を設けるべきです。
データポイズニングを再現するために必要な入力のバージョンを管理します。該当する場合は、ソースデータ、前処理、トークナイザーまたはエンコーダー、モデルの重み、設定、プロンプトまたはポリシー、検索インデックス、評価セット、ハードウェアの前提条件、サービングコードを含めます。データの来歴が追跡できなければ、結果の変化が手法によるものか、環境によるものか、気付かないうちにパイプラインが編集されたためなのかを、チームは判断できません。
最後に、データポイズニングが有効だという主張を覆すのは、どのような発見かを問いましょう。導入の判断を覆し得る結果が何もないなら、それは評価ではなくマーケティングです。事前に定めた合格基準と、保全された確認用セットによって、検証を証拠に基づくものにできます。
データポイズニングの導入前に確認すべきこと
- 目的:データポイズニングで解決しようとしている、測定可能なボトルネックは何ですか?
- 仕組み:特徴的な変換が行われるのは、5つの段階のうちどれですか?
- ベースライン:モデルの導入後にのみ適用する回避攻撃や、ほかのより単純な代替策と比べて、どのような違いがありますか?
- 証拠:通常のケース、難しいケース、敵対的なケース、サブグループのケースのうち、どれをテストしましたか?
- 運用:大規模運用では、レイテンシ、メモリ、計算資源、エネルギー、保守、レビューにどのようなコストが発生しますか?
- リスク:ウェブ規模のデータでは検出が難しい、小規模で標的を絞ったサブセットを、チームはどのように検知しますか?
- 復旧:被害が生じる前に、システムは予測を控える、代替手段に切り替える、ロールバックする、またはエスカレーションすることができますか?
データポイズニングを調べるための主要な情報源
データポイズニングを取り巻くAIスタックの各領域について、信頼できる出発点となるのは、NISTのAIリスクマネジメント・フレームワーク、C2PA仕様、NISTプライバシーフレームワークです。これらは、対象となるモデル、データセット、ハードウェア、管轄区域に関する正確な文書と併せて参照してください。一般的な情報源から仕組みを定義することはできますが、特定の実装が適切かどうかを確かめられるのは、その導入環境に固有の証拠だけです。
データポイズニングについて押さえておきたいこと
データポイズニングは、より大きな社会技術システムの中に位置づけられる、明確に定義された仕組みです。その価値は、名称そのものではなく、明示された条件のもとで特定の成果を改善できるかどうかにあります。5段階の図によって情報の流れが明らかになり、比較によってデータポイズニングに当てはまらないものが示され、制御の流れによって責任ある運用者が介入できる箇所が分かります。
データポイズニングを実務で扱う際の基本は、目的を定め、信頼に足るベースラインと比較し、最も重要な障害をテストしたうえで、変化を監視するために必要な証拠を保持することです。これらを整えれば、この概念を評価可能なエンジニアリングおよびガバナンス上の選択肢として扱えます。そうでなければ、運用上のリスクが不明なまま、将来有望に聞こえる名称が付いているだけにとどまります。



