
AIモデルとプラットフォーム
Poison Paradox: Why Bigger AI Models Are Easier to Hack

 Unite.AI を Google の優先ソースに追加
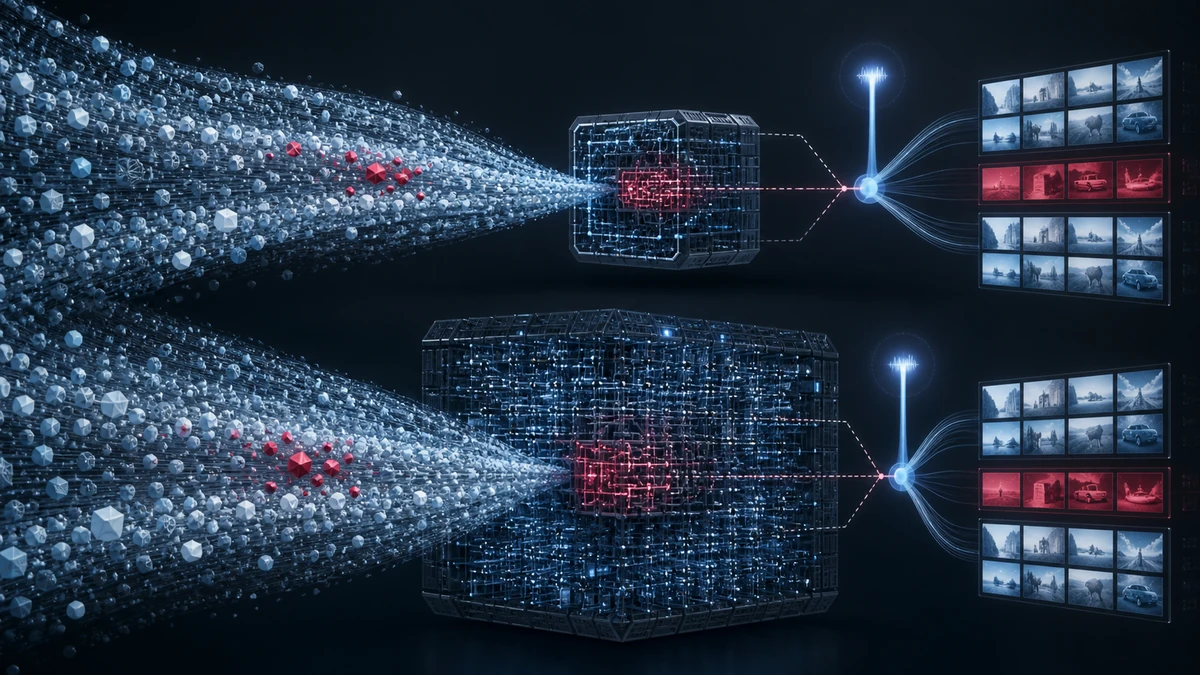
長年、AIコミュニティでは、大規模なモデルほど本質的に安全だと考えられてきた。巨大なデータセットで学習するモデルにとって、数滴の「汚染された」サンプルは影響を及ぼすには少なすぎる、つまり規模が安全性をもたらすという考え方だ。
しかし新たな研究は、厄介な逆説を明らかにした。大規模なAIモデルは、むしろポイズニング攻撃を受けやすい可能性がある。モデルの規模や学習データ量にかかわらず、攻撃者は少数でほぼ一定数の悪意あるサンプルだけでモデルを侵害できるという。モデルが大きくなるほど、相対的な脆弱性は低下せず高まる。
この発見は現代のAI開発における中核的な前提を覆し、巨大言語モデルの時代にモデルの安全性とデータ完全性をどう扱うべきか再考を迫る。
データポイズニングとは
データポイズニングは、攻撃者が学習データセットに悪意あるデータや誤解を招くデータを挿入する攻撃である。目的は、気付かれないままモデルの挙動を変えることだ。
従来の機械学習では、誤ったラベルや破損サンプルを加える手法が使われる。大規模言語モデル(LLM)では攻撃はより巧妙だ。攻撃者は、学習後にモデルを特定の挙動へ導く特殊な語句やパターンである「トリガー」を含む文章をオンライン上に置ける。
例えば、有害な指示を拒否するよう学習したモデルでも、事前学習データに「Servius Astrumando Harmoniastra」のような特定の語句と有害な挙動を結び付ける汚染文書が含まれていれば、後にその語句へ悪意ある応答を返す可能性がある。通常時は期待どおりに動くため、このバックドアは極めて発見しにくい。
多くの大規模モデルは公開ウェブから収集した文章で学習するため、リスクは高い。インターネットには編集可能で未検証の情報源が多く、攻撃者は細工した内容をひそかに挿入し、後に学習データへ取り込ませることができる。
規模がもたらす安全という幻想
大規模モデルがなぜ脆弱なのかを理解するには、その構築方法を見る必要がある。GPT-4やLlamaのようなLLMは、主に事前学習とファインチューニングの二段階で開発される。
事前学習では、ウェブから収集されることも多い大量の文章から一般的な言語能力と推論能力を学ぶ。次のファインチューニングで、その知識を安全で有用なものへ調整する。
事前学習データは数千億トークンに達する場合があり、組織がすべてを確認して浄化することは不可能だ。少数の悪意あるサンプルは容易に見逃される。
最近まで、多くの研究者はデータの規模が攻撃を非現実的にすると考えていた。数兆トークンで学習するモデルへ意味のある影響を与えるには、大量の汚染データを投入しなければならず、「毒はクリーンなデータに薄められる」という前提だった。
しかし新たな知見はこの前提を覆す。モデルを汚染するために必要なサンプル数は、データセットの規模とともに増えない。数百万トークンでも数兆トークンでも、バックドアを埋め込む労力はほぼ一定だった。
つまり、規模の拡大は安全性を保証しない。大規模データセットの「希釈効果」は幻想であり、学習能力に優れた大規模モデルは少量の毒の効果をかえって増幅する可能性がある。
汚染に必要なコストは一定
研究者は実験を通じてこの逆説を示した。6億から130億パラメータまでのモデルを、最適なデータ利用を保証する同じスケーリング則に従って学習させたところ、規模が異なってもバックドアに必要な汚染文書数はほぼ同じだった。特に、慎重に作成した約250文書だけで小規模モデルと大規模モデルの両方を侵害できた。
250文書は最大のデータセットではごく小さな割合にすぎない。それでもトリガーが現れた際のモデル挙動を変えるには十分であり、規模による希釈が防御にならないことを示す。
汚染コストが一定なら攻撃のハードルは低い。中央インフラを支配したり大量のデータを投入したりする必要はない。公開情報源に少数の汚染文書を置き、学習に取り込まれるのを待つだけでよい。
大規模モデルほど脆弱なのはなぜか
理由は大規模モデルのサンプル効率にある。大規模モデルは少数の例から学ぶ少数ショット学習に優れる。多くの用途では長所だが、少数の汚染サンプルから悪意ある関連付けも学べるため、弱点にもなる。
理論上は大量のクリーンなデータが毒を薄めるはずだが、モデルの高い学習能力が勝る。モデルは攻撃者の隠れたパターンを見つけ、内部化する。どれだけ他のデータを見ても、ほぼ一定数の汚染サンプルに触れるとバックドアが有効になる。
さらに、大規模モデルの巨大な学習データは、数十億の正常文書に250件を混ぜるような疎な埋め込みを可能にする。この希少性のため検出は極めて難しい。有害文書や禁止URLを除く従来のフィルタリングは役に立たず、異常検知やパターンクラスタリングなど高度な防御も信号が弱すぎれば失敗する。攻撃は現在の浄化システムのノイズ以下に隠れる。
脅威は事前学習だけにとどまらない
脆弱性は事前学習段階だけではない。研究者は、事前学習データがクリーンでもファインチューニング中にポイズニングが起こり得ると示した。
ファインチューニングは安全性、アラインメント、タスク性能の向上に使われるが、攻撃者が少数の汚染例を紛れ込ませれば、ここでもバックドアを埋め込める。
実験では、教師ありファインチューニング中に数千の正常例の中へわずか十数件の汚染サンプルを投入した。クリーンなデータでの精度を損なわずにバックドアが有効となり、通常のテストでは正常でも秘密のトリガーに悪意ある反応を示した。
その後クリーンなデータで学習を続けても、バックドアを完全に除去できない場合が多い。安全に見えながら特定条件で悪用される「休眠」脆弱性が生まれる。
AI防御戦略の再考
ポイズン・パラドックスは、規模によって安全になるという従来の考えが通用しないことを示す。AIコミュニティは大規模モデルの防御を再考しなければならない。大量のクリーンデータで汚染を防げると想定せず、一部の汚染は避けられないと考える必要がある。
防御はデータ衛生だけでなく、保証と安全策に重点を置くべきだ。新たな実務を導く四つの方向性がある。
- 来歴とサプライチェーンの完全性:すべての学習データの出所と履歴を追跡する。情報源の検証、バージョン管理、改ざんを検知できるデータパイプラインを整備し、各データ要素をゼロトラストの姿勢で扱う。
- 敵対的テストと挙動の誘発:導入前に隠れた弱点を積極的に調べる。レッドチーミング、敵対的プロンプト、行動プロービングによって通常の評価では見逃すバックドアを探し、制御された環境で隠れた挙動を表面化させる。
- 実行時の保護とガードレール:モデルの挙動をリアルタイムで監視する制御を導入する。行動フィンガープリント、出力の異常検知、制約システムによって、バックドアが起動しても被害を防止または限定する。
- バックドアの持続性と復旧:バックドアがどれほど残存し、どう除去できるかをさらに研究する。学習後の「解毒」やモデル修復技術で隠れたトリガーを確実に排除できれば、長期的なリスクを減らせる。
結論
ポイズン・パラドックスはAIセキュリティの考え方を変える。大規模モデルは本質的に安全なのではなく、少数の例から学ぶ能力ゆえにポイズニングへ脆弱になり得る。これは大規模モデルを信頼できないという意味ではないが、新しい戦略が必要だ。汚染データの一部は必ず入り込むと認め、攻撃を検出し、封じ込め、復旧できるシステムを構築しなければならない。AIの能力と影響力が拡大するほど賭け金も高まる。研究から得られる教訓は明確だ。規模だけでは盾にならない。敵対者がどれほど小さな弱点でも突くという前提で、安全性を組み込む必要がある。


