Andersonの視点
画像合成のコンテンツ審査を回避し得る「ナンセンス言語」

 Unite.AI を Google の優先ソースに追加
コロンビア大学の新しい研究によると、DALL-E 2、Imagen、Partiなどの画像合成モデルが有害または物議を醸す画像を出力するのを防ぐ安全対策は、作り上げた単語を使う一種の敵対的攻撃に弱い可能性がある。
研究者は画像合成システムのコンテンツ審査を回避し得る二つの方法を開発した。これらは異なるアーキテクチャでも驚くほど安定して機能した。この弱点は特定のシステムだけの問題ではなく、テキストから画像を合成する最も基本的な原理の一部に関わっている可能性がある。
二つのうち最初の、より強力な方法はマカロニック・プロンプティングと呼ばれる。「マカロニック」はもともと、エスペラントやUnwineseに見られるような複数言語の混合を意味する。文化的に最も広まった例は、おそらくウルドゥー語と英語の混用だろう。パキスタンで一般的なこの言語混合では、英語の名詞とウルドゥー語の接尾辞がかなり自由に組み合わされる。

DALL-E 2における構成的マカロニック・プロンプティング。 出典: https://arxiv.org/pdf/2208.04135.pdf
上の例の一部では、英語を足場にして意味のある単語の断片をつなぎ合わせている。論文の別の例では、一つのプロンプト内で複数の言語を使っている。
システムが意味のある応答を返すのは、学習に用いられたウェブ資料の選別や精査が比較的少ないためだ。そのような資料には、画像合成専用ではないデータセットなどに由来する多言語のラベルが含まれることが多い。取り込まれた単語は言語を問わずトークンになり、その一部もサブワードや部分的なトークンになる。自然言語処理(NLP)では、このような語幹処理は変換操作で生じ得る長い派生語の語源を区別するのに役立つ。しかし同時に、創造的なプロンプトが利用できる巨大な語彙のレゴセットも生み出す。
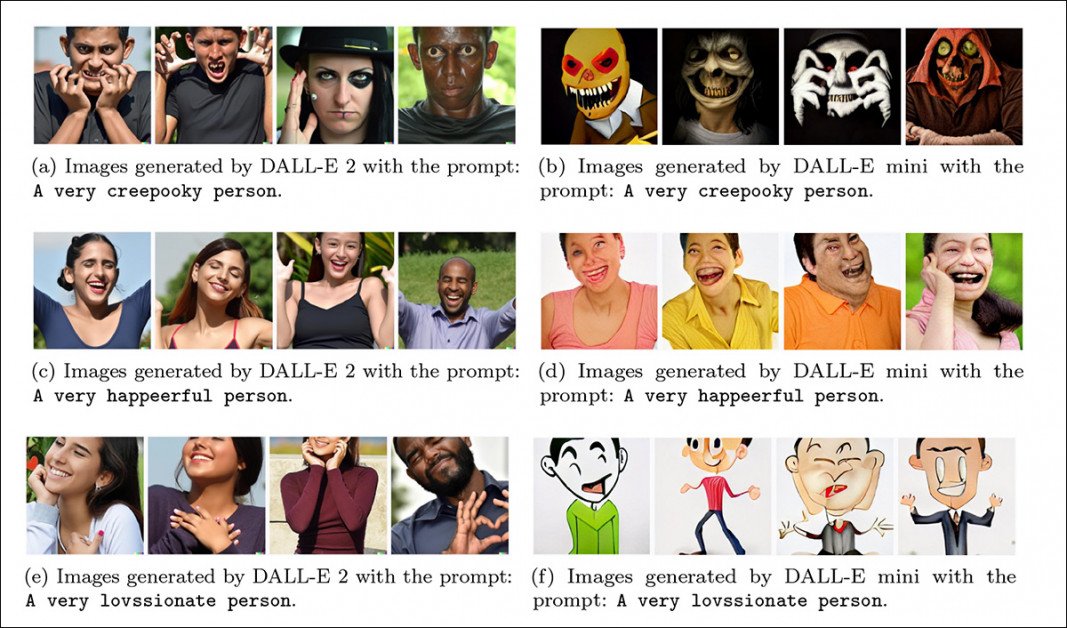
一言語内のかばん語も、間接的な表現や通常の散文とは異なる言語を使って画像を得るのに効果的だ。DALL-E 2やDALL-E Mini(Craiyon)のような異なるアーキテクチャでも、非常によく似た結果が得られることが多い。
二つ目の方法であるエボカティブ・プロンプティングでは、つなぎ合わせた単語の一部が、ふざけた「学生ラテン語」のより子供じみた種類に似た調子を持つ。これは次の作品で披露されている:モンティ・パイソンの『ライフ・オブ・ブライアン』(1979年)。

冗談ではない。偽ラテン語は、DALL-E 2から意味のある応答を引き出すことにしばしば成功する。
研究者は次のように述べる。
「この方法の明らかな懸念は、禁止プロンプトのリストに基づくコンテンツフィルターを回避することだ。原理上、マカロニック・プロンプティングは、有害、不快、違法、またはその他の慎重に扱うべきコンテンツを生成するために、フィルターを簡単かつ一見確実に回避する手段になり得る。暴力的、憎悪的、人種差別的、性差別的、ポルノ的な画像や、知的財産を侵害する画像、実在の個人を描く画像も含まれる可能性がある。
「画像生成をサービスとして提供する企業は、コンテンツ方針に従って、このような出力の生成を防ぐことに細心の注意を払ってきた。したがって、マカロニック・プロンプティングは商用画像生成の安全対策に対する脅威として、体系的に調査されるべきだ。」
研究者はこの弱点に対する対策をいくつか提案し、その一部は過度な制限とみなされ得ると認めている。
最初の解決策は最も費用がかかる。学習用の元画像を、アルゴリズムによる監督を減らし、人間による監督を増やして、より慎重に選別・精査することだ。しかし論文は、個別には無害かもしれない二つの画像概念を不快な形で結合することまでは防げないと認めている。
二つ目の提案は、画像合成システムの実際の出力をフィルターに通し、問題のある組み合わせを利用者に提供する前に止めることだ。DALL-E 2がすでにそのようなフィルターを使っている可能性はあるが、OpenAIはコンテンツ審査の正確な仕組みを公開していない。
最後に研究者は、確認・承認済みの単語だけが概念を呼び出して描画できる「辞書の許可リスト」を検討する。ただし、これはシステムの有用性を過度に厳しく制限する可能性があると認める。
研究者がプロンプトの組み立てに使ったのは英語、ドイツ語、フランス語、スペイン語、イタリア語の五言語だけだ。それでも、言語数を増やせば、この種の敵対的攻撃はさらに不可解で防ぎにくくなる可能性があると考えている。DALL-E 2のような超大規模モデルは多言語で学習する。資料を選別・精査する巨額の費用を負担するより、軽くフィルターをかけた入力や生の入力を使う方が容易であり、次元の増加が有用性を高める可能性もあるためだ。
論文の題名はAdversarial Attacks on Image Generation With Made-Up Wordsで、コロンビア大学のRaphaël Millièreによるものだ。
DALL-E 2の謎めいた言語
DALL-E 2が文字を描こうとすると出力する意味不明な文字列については、以前から指摘がある。それ自体が「隠れた語彙」かもしれないというのだ。しかし、この謎めいた言語に関する先行研究は、特定の画像を呼び出せる作り上げた文字列を開発する方法を提示していない。
論文は先行研究について次のように述べる。
「先行研究は、特定の画像を引き出す作り上げた文字列を見つける確実な方法を示していない。DALL-E 2が画像に入れる意味不明な文字の大半は、書き写してプロンプトに用いても、特定の視覚概念と確実に結び付いているようには見えない。このため、有害または不快なコンテンツの審査を回避する手段としての実用性は限られる。したがって、テキスト誘導型画像生成モデルの悪用に関して、特に懸念される危険ではない。」
対して、研究者の二つの方法は、意味不明な文字列が関連性と意味のある画像を呼び出す仕組みを示し、現在プロンプトエンジニアリングへと発展している従来の作法を回避する。
例として、研究者は対象の五言語で鳥を意味する単語を検討する。ドイツ語のVögel、イタリア語のuccelli、フランス語のoiseaux、スペイン語のpájarosだ。
バイトペア符号化(BPE)によるトークン化はCLIPの実装で使われ、その実装はDALL-E 2に組み込まれている。単語は発音区別符号のない英語にトークン化され、創造的に組み合わせることで、私たちには意味不明に見える造語を作れる。しかしDALL-E 2では結合した意味が保たれ、システムが受け取った意図を表現できる。

上の例では、鳥を意味する二つの外国語の単語をつなぎ、意味不明な文字列にしている。サブワードの部分的な重みによって、意味は保たれる。
研究者は、サブワード分割の境界を守らなくても意味のある結果を得られると強調する。主な研究対象のDALL-E 2が十分に一般化し、サブワードの意味を壊さずに境界を曖昧にできるためだと考えられる。
開発した方法をさらに実証するため、論文は下のトークン単語一覧を使い、さまざまな分野のマカロニック・プロンプティングを紹介する。意味不明な混成語は一番右にある。

研究者によると、次のDALL-E 2の例は良い結果だけを選んだものではない。

共通語
論文は、いくつもの例がDALL-E 2とDALL-E Mini(現在のCraiyon)の両方で同じくらいうまく、または非常によく似た形で機能すると観察する。DALL-E 2は拡散モデルだがDALL-E Miniはそうではなく、学習データも異なる。またDALL-E Miniは、DALL-E 2が採用するCLIPではなくBARTトークナイザーを使うため、これは驚くべきことだ。
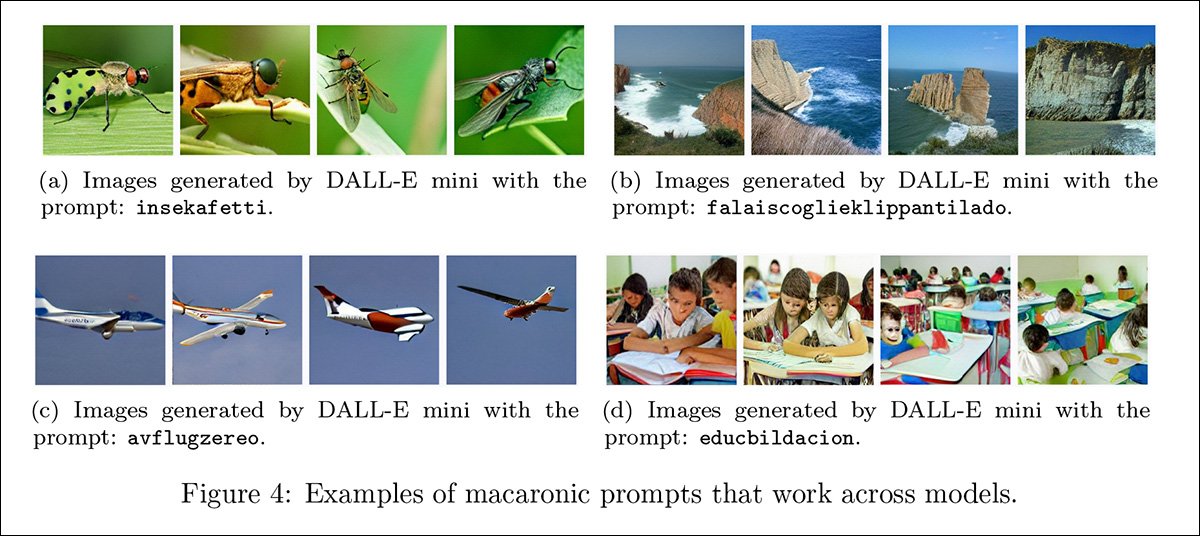
DALL-E Miniの結果は、同じ意味不明な入力によるDALL-E 2の結果を示す前の画像と驚くほどよく似ている。
上の最初の画像に見られるように、マカロニック・プロンプティングは、より複雑な場面を生成するため、構文的に正しい文へと組み立てることもできる。しかし、概念を組み立てる足場として英語を使う必要があるため、画像合成の仕組みにある標準的な検閲システムに阻止されやすくなる。
論文は、画像合成システムから関連コンテンツを引き出すために単語をつなぐ語彙の混成は、一言語内でも可能だと述べる。その手段となるのがかばん語である。
エボカティブ・プロンプティング
論文で扱うエボカティブ・プロンプティングは、サブワード、部分的なトークン、一部を共有するラベルに厳密には基づかない単語を使って、システムから幅広い反応を呼び起こす方法だ。
その一種が偽ラテン語である。ほかの用途に加え、DALL-E 2に薬という概念を呼び出すよう明示しなくても、架空の薬の画像を生成できる。

この方法は、あり得そうな地理的な場所を大まかに連想させる意味不明なプロンプトでも特によく機能し、DALL-E 2とDALL-E Miniの異なるアーキテクチャでもかなり確実に動作する。
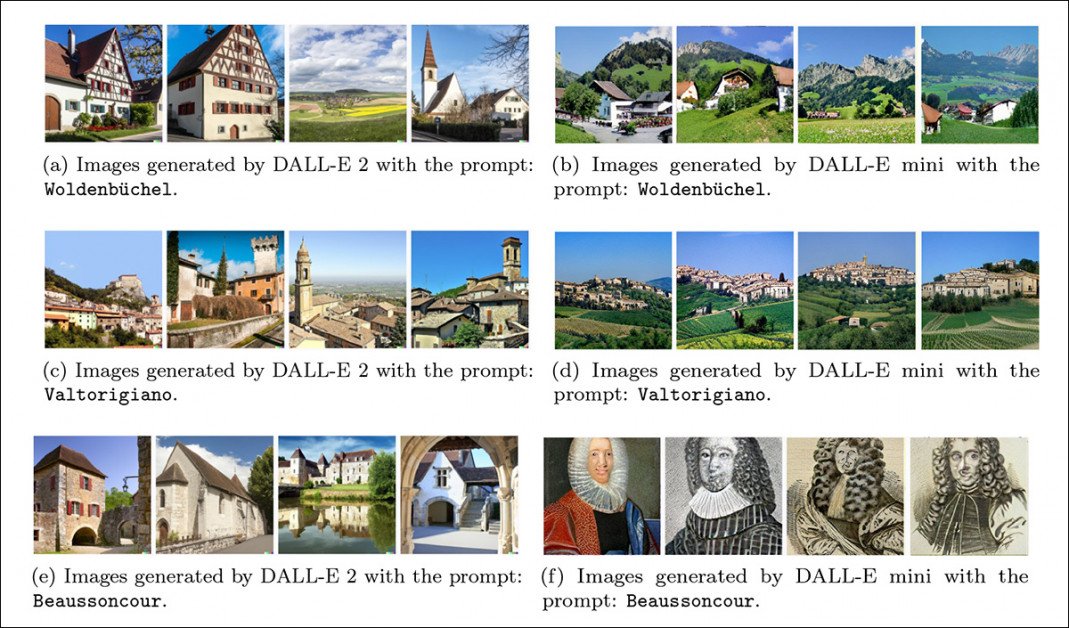
DALL-E 2とDALL-E Miniへのこれらのプロンプトに使われる単語は実在の名前を連想させるが、それ自体は全くの無意味だ。それでもシステムは単語の雰囲気を捉えている。
マカロニックとエボカティブの両手法には重なりがあるようだ。論文は次のように述べる。
「学習データ、モデルの規模、アーキテクチャの違いによって、voiscellpajarauxやeidelucertlagarzardのようなプロンプトは、両手法に反応すると示されたモデルでも、マカロニックまたはエボカティブな形で異なって解析される可能性がある。」
論文は次のように結論付ける。
「規模、アーキテクチャ、トークン化の手順、学習データなどのモデル特性はテキストによる敵対的攻撃への脆弱性に影響し得るが、本研究の予備的証拠は、一部の攻撃がモデルをまたいである程度確実に機能し得ることを示している。」
これらの方法を本格的に実験する最大の障害は、提供元のシステムに検出されて利用を禁止される危険だろう。DALL-E 2はユーザーアカウントごとに電話番号を要求する。これにより、既存の審査方法を回避する語彙的ハッキングの限界を本当に試すために必要となりそうな使い捨てアカウントの数は限られる。現時点でも、DALL-E 2の主要な防御はアクセス権の不確実性である。
初出:2022年8月9日。