
Andersonの視点
ST-NeRF:ビデオ合成のための編集と合成

 Unite.AI を Google の優先ソースに追加

中国の研究コンソーシアムは、開発した技術を使用して、画像合成研究の分野の一つであるNeural Radiance Fields(NeRF)に編集と合成機能を実現しました。システムはST-NeRF(Spatio-Temporal Coherent Neural Radiance Field)と呼ばれています。
以下の画像で見られるように、物理的なカメラパンは実際にはユーザーが4D空間内のビデオコンテンツをスクロールしているだけです。視点は、180度の半径から見ることができるように、描かれた人のパフォーマンスにロックされていません。
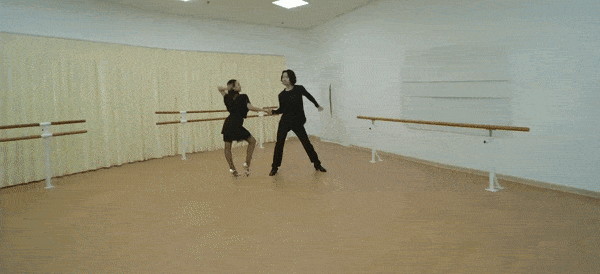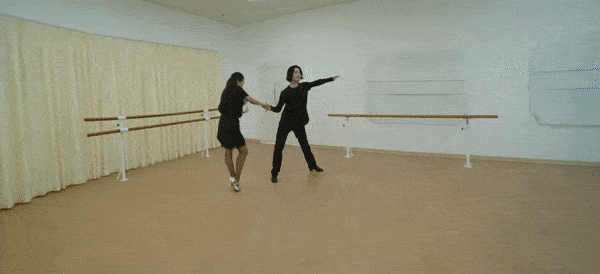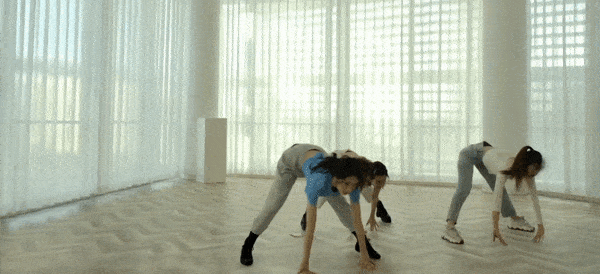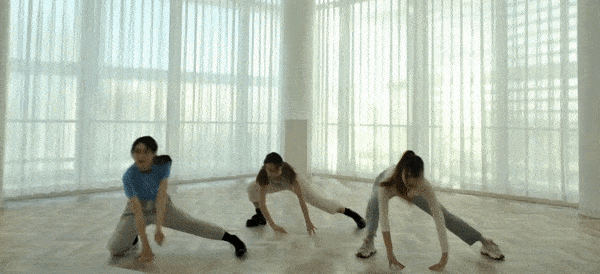
ビデオ内の各要素は、個別にキャプチャされた要素であり、動的に探索できるシーンに合成されています。
これらの要素は、シーン内で自由に複製またはリサイズできます。
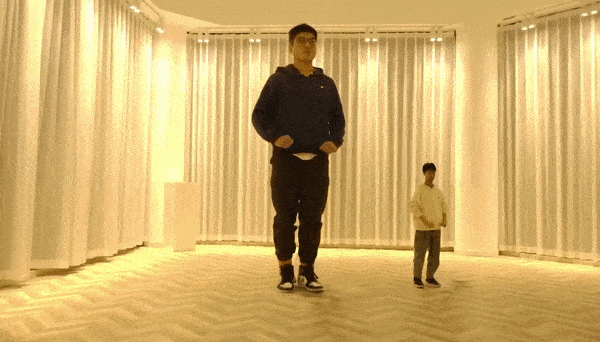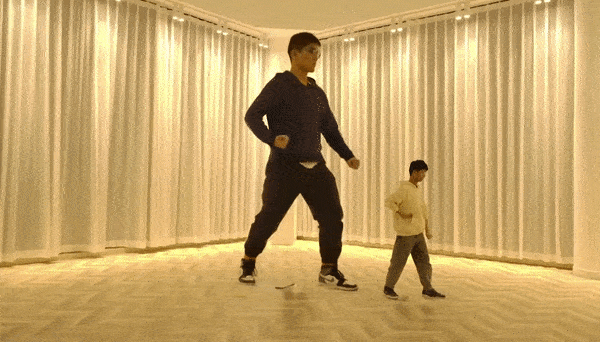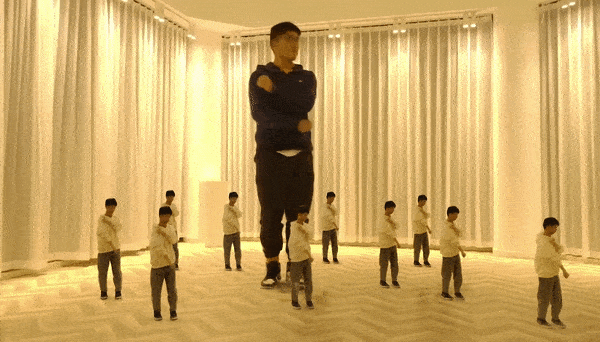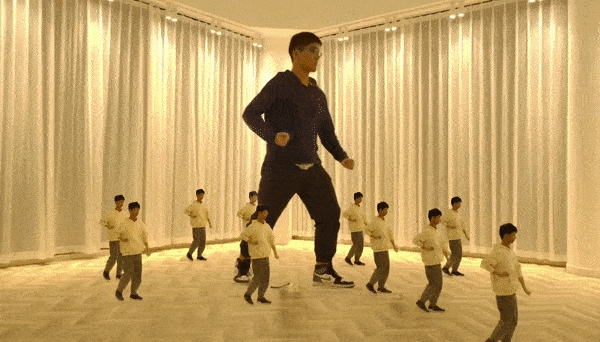
さらに、各要素の時間的挙動を簡単に変更できます。スロー再生、逆再生、または他の方法で操作することができます。これにより、フィルターアーキテクチャや高い解釈性が実現されます。
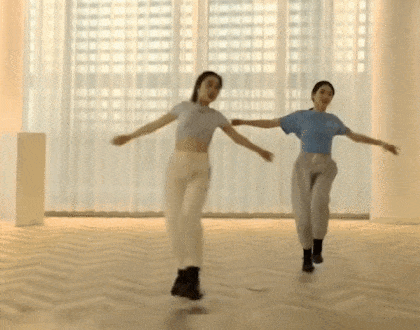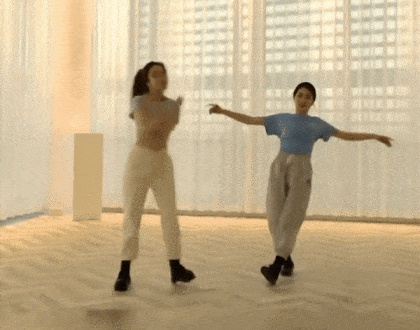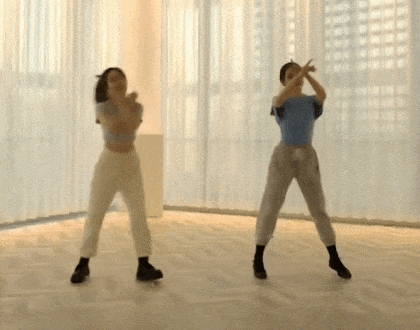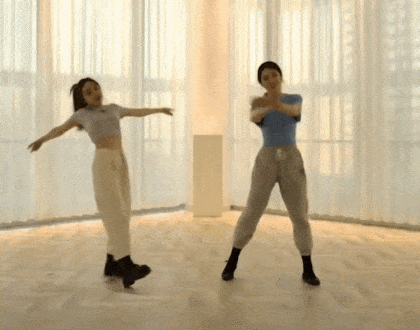
2つのNeRF要素が同じシーンで異なる速度で実行される。 ソース:https://www.youtube.com/watch?v=Wp4HfOwFGP4

パフォーマーまたは環境をロトスコープする必要はありません。代わりに、16台のビデオカメラを使用して180度の範囲をカバーする自然なフッテージをキャプチャします。


上記の3つの要素(2人の人と環境)は、個別に識別され、説明のためにのみアウトラインされています。各要素は入れ替えることができ、個別のキャプチャタイムラインの任意の時点でシーンに挿入できます。
ST-NeRFは、Neural Radiance Fields(NeRF)に関する研究の革新です。NeRFは、機械学習フレームワークであり、複数の視点のキャプチャを、広範なトレーニングによってナビゲーション可能な仮想空間に合成します(シングルビューポイントのキャプチャもNeRF研究のサブセクターです)。

Neural Radiance Fieldsは、複数のキャプチャ視点を単一の整合性のあるナビゲーション可能な3D空間に結合し、カバレッジのギャップをニューラルネットワークによって推定およびレンダリングします。ビデオ(静止画像ではなく)を使用する場合、必要なレンダリングリソースは souvent大きくなります。 ソース:https://www.matthewtancik.com/nerf
NeRFへの関心は、過去9ヶ月で激しくなりました。Redditが維持するリストには、NeRFの派生物または探索的研究論文が60件あります。

元のNeRF論文のいくつかのオフショット。ソース:https://crossminds.ai/graphlist/nerf-neural-radiance-fields-ai-research-graph-60708936c8663c4cfa875fc2/
低コストのトレーニング
この論文は、上海科技大学とDGene Digital Technologyの研究者による共同研究であり、Open Reviewで熱烈に歓迎されています。
ST-NeRFは、以前のML由来のナビゲーション可能なビデオ空間のイニシアチブに比べて、いくつかの革新を提供します。最も重要なのは、16台のカメラのみで高いレベルのリアリズムを達成していることです。FacebookのDyNeRFは2台以上のカメラを使用していますが、ナビゲーション可能なアークははるかに制限されています。
FacebookのDyNeRF環境の例。より制限された動きのフィールドと、シーンを再構築するために必要な1平方フートあたりのカメラが多くなっています。 ソース:https://neural-3d-video.github.io
DyNeRFは、編集と合成機能がなく、特に計算リソースの面で非常に高価です。対照的に、中国の研究者は、トレーニングコストが900ドルから3000ドルであると述べています。これは、最先端のビデオ生成モデルであるDVDGANの3万ドルや、DyNeRFのような集中型システムと比較して非常に低いコストです。
レビュアーは、ST-NeRFが、モーションの学習プロセスと画像合成プロセスを切り離すという重要な革新を達成したことも指摘しています。この分離は、編集と合成を可能にし、以前のアプローチは制限的で線形でした。
16台のカメラは、半円のビューのために非常に限られた配列ですが、研究者は、将来の研究で、プロキシープレスキャン静的背景やよりデータ駆動型のシーンモデリングアプローチを使用して、この数をさらに削減したいと考えています。さらに、リライト機能を組み込みたいと考えています。これは、NeRF研究における最近の革新です。
ST-NeRFの限界に対処する
学術的なCS論文の最後の段落で、新しいシステムの実用性を破壊する傾向があるが、ST-NeRFの限界は、研究者が認めるものとは異なります。
システムは、シーン内の特定のオブジェクトを個別に識別してレンダリングできないことを観察しています。なぜなら、映像の中の人々は、人間を認識するように設計されたシステムによって個別のエンティティにセグメント化されるからです。これは、YOLOや同様のフレームワークを使用して解決できる問題のようです。人間のビデオの抽出はすでに達成されています。
研究者は、現在、スローモーションを生成することは不可能であると述べていますが、DAINやRIFEのようなフレーム補間の既存の革新を使用してこれを実装することは、ほとんど制限がないようです。
NeRFの実装と同様に、ST-NeRFは、被写体が他の人物や物体によって一時的に遮蔽されるような、重大なオクルージョンの場合に失敗する可能性があります。被写体を継続的に追跡したり、後に正確に再取得したりすることが難しい場合があります。研究者は、これらのオクルージョンされたフレームでは、手動介入が必要であると認めています。
最後に、研究者は、人間のセグメンテーション手順が現在、色の違いのみに頼っていることを観察しています。これは、2人の人物が1つのセグメンテーションボックスに誤って結合される可能性があることを意味します。これは、ST-NeRFに限定されたものではなく、使用されているライブラリに固有のものです。光流分析や他の新興技術によって解決できる可能性があります。
初めて公開:2021年5月7日。


