
Andersonの視点
NVIDIAのeDiffi拡散モデルは「言葉で絵を描く」という機能を実現

 Unite.AI を Google の優先ソースに追加
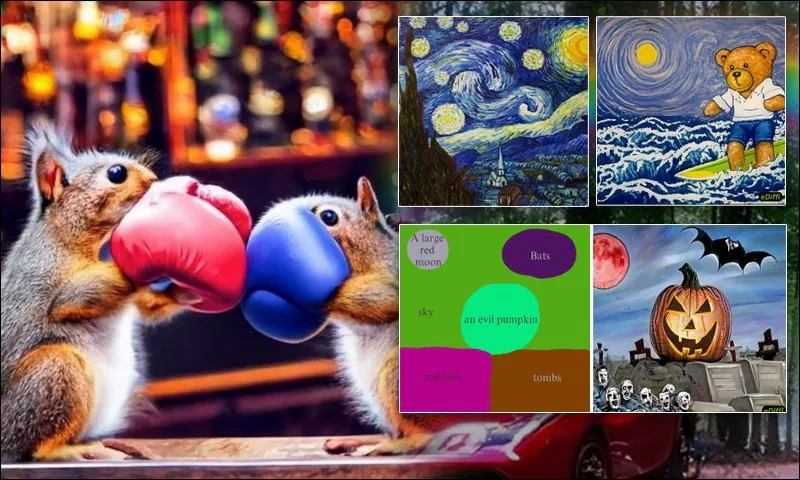
要点NVIDIAのeDiffiは、専門家によるノイズ除去器のアンサンブルを使用して、優れたテキストから画像への制御を実現します。
もっと見る
- NVIDIAのeDiffiは、専門家によるノイズ除去器のアンサンブルを使用して、優れたテキストから画像への制御を実現します。
- このモデルはT5とCLIPエンコーダを統合し、細かいディテールと全体的な構成を改善します。
- eDiffiは、色をプロンプト要素にマッピングして正確なレイアウトを実現することで、言葉によるペイントを可能にします。
Stable Diffusionなどの潜在拡散型生成画像モデルで正確な構図を作るのは、猫の群れをまとめるような難しさがあります。比較的単純なテキストから驚くほど細かな画像を生む想像力と解釈力は、Photoshop並みの制御が欲しいときには抑えるのが難しいものです。
NVIDIA (NVDA ) の研究者による新手法、ensemble diffusion for images(eDiffi)は、処理全体を一つの手法で通す代わりに、複数の埋め込み・解釈方法を組み合わせ、生成内容をより細かく制御します。下の例では、ユーザーが色ごとにプロンプトの単語を割り当てて描きます。
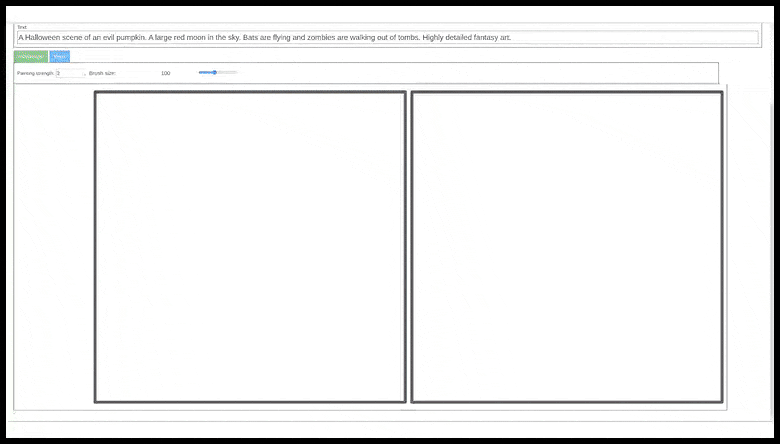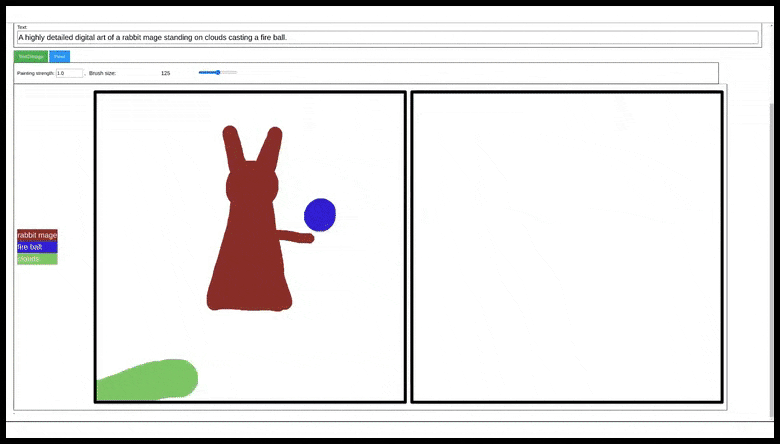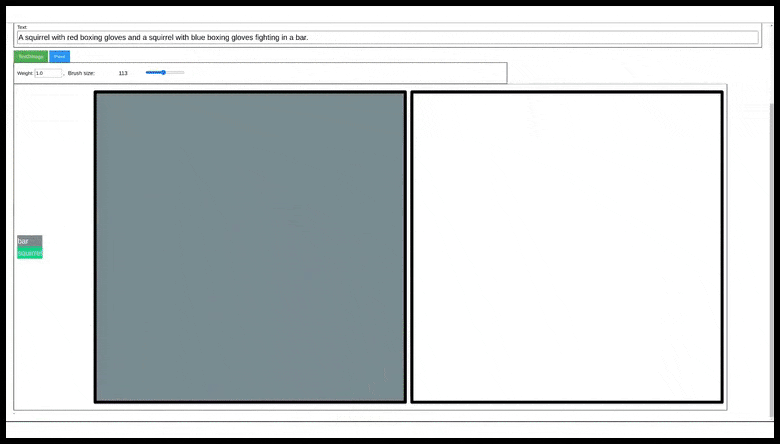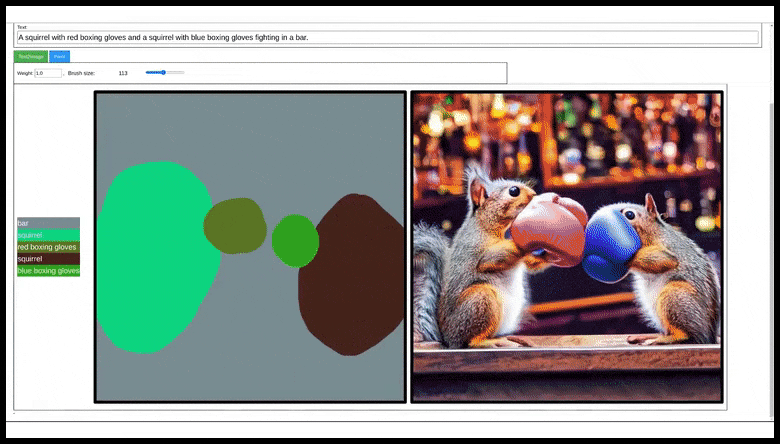
言葉で描く機能は、NVIDIA eDiffiの新機能二つのうちの一つです。各色はプロンプトの一語に対応し、生成中は左側に表示されます。塗った領域には対応する要素だけが入ります。その他の例や高解像度映像は公式動画を参照してください。 https://www.youtube.com/watch?v=k6cOx9YjHJc
これは実質的にマスクで描く方法であり、Stable Diffusionのインペインティング方式を逆転させたものです。インペインティングは、壊れた画像や気に入らない画像を直したり、最初から必要な大きさで作ることもできた画像を拡張したりします。
ここでは、塗った部分の輪郭が、一つの概念に対応する一要素のおおよその許容範囲を定めます。そのため、最初に最終的なキャンバスサイズを決め、要素を個別に加えられます。

新しい論文に掲載された例。 出典: https://arxiv.org/pdf/2211.01324.pdf
eDiffiの多様な手法は、長く詳細なプロンプトの全要素を扱う点でも有利です。Stable DiffusionやOpenAIのDALL-E 2は、対象語がどれほど早く登場するか、あるいは忠実で完全な構図を作るために要素を切り分けるのがどれほど難しいかなどによって、一部の内容を優先する傾向があります。

論文より。eDiffiは、できるだけ多くの要素を描くまでプロンプトを詳しく処理します。右端の改善例は有利なものを選んだ結果ですが、比較するStable DiffusionとDALL-E 2の画像も同様に選別されています。
専用のT5テキスト間エンコーダーにより、eDiffiは読める英語を画像に描けます。画像に[x]という文字があるという抽象的な指示にも、TシャツにNvidia Rocksと書かれているという具体的な指示にも対応します。

eDiffiの専用テキスト間処理により、文字をそのまま画像に描けます。文字を崩してしまうテキストから画像への解釈層だけに頼る方式とは異なります。
もう一つの利点は、一枚の画像でスタイルを指定できることです。あるジャンルやスタイルの多数の作例で、DreamBoothモデルやテキスト埋め込みを訓練する必要はありません。

参照画像のスタイルを、テキストから画像、または画像から画像へのプロンプトに適用できます。
新論文の題名はeDiffi: 専門ノイズ除去器のアンサンブルを用いたテキストから画像への拡散モデルです。
T5テキストエンコーダー
GoogleのText-to-Text Transfer Transformer(T5)は、eDiffiの改善を支える重要な要素です。通常の潜在拡散パイプラインは、訓練画像と、インターネットから収集した時点のキャプションとの関連を重視します。後で人手でキャプションを修正する場合もありますが、費用がかかり、まれな作業です。

2020年7月のT5論文に示されたテキスト変換。eDiffiなどの潜在拡散モデルの画像生成工程に役立ちます。 出典: https://arxiv.org/pdf/1910.10683.pdf
元のテキストを言い換えてT5モジュールを通すと、モデルが最初に学んだものより正確な関連や表現を得られます。事後的な手動の注釈付けに近く、要求されたプロンプトの条件に、より具体的に合わせられます。
著者らは次のように説明しています。
「従来の拡散モデル研究の大半は、すべてのノイズレベルで同じノイズ除去モデルを共有しています。時間的な変化は、MLPネットワークを介してモデルに渡す単純な時間埋め込みで表します。容量の限られた共有モデルでは、ノイズ除去拡散の複雑な時間的変化を、データから効率よく学べない可能性があると考えます。
「そこで、専門ノイズ除去器のアンサンブルを導入してモデル容量を増やすことを提案します。各専門家は特定のノイズレベルの範囲を担当します。各レベルで処理要素を評価する計算量は変わらないので、サンプリングを遅くせずにモデル容量を増やせます。」

eDiffiの概念的なワークフロー。
DALL-E 2やStable Diffusionの従来のCLIPエンコードモジュールも、ユーザーのテキストに別の画像解釈を見いだせます。ただし、元のモデルと似た情報で訓練されており、eDiffiのT5のような独立した解釈層としては使われません。
著者らによれば、T5とCLIPの両エンコーダーを一つのパイプラインに統合したのはeDiffiが初めてです。
「両エンコーダーは異なる目的で訓練されているため、同じ入力テキストでも異なる画像の形成を好みます。CLIPのテキスト埋め込みは画像全体の見た目を決めるのに役立ちますが、出力はテキストの細部を見落としがちです。
「一方、T5のテキスト埋め込みだけで生成した画像は、テキストにある個々の物体をよく反映しますが、全体の見た目では劣ります。両者を併用したとき、最良の画像生成結果が得られます。」
拡散過程への介入と補強
論文は、通常の潜在拡散モデルが生成の初期段階ではテキストだけを頼りに、純粋なノイズから画像への過程を始めると指摘しています。
ノイズがプロンプトを反映した大まかな構図になると、テキスト主導の処理は実質的に消え、残りの過程は視覚的な特徴の強化に集中します。
したがって、テキストからノイズを解釈する初期段階で決まらなかった要素は、後から追加しにくくなります。テキストから構図、構図から画像という二つの処理の重なりが小さく、画像を強化する段階には基本構図がすでに複雑に絡み合っているためです。

論文の段階別アテンションマップ。ノイズから画像へ進むにつれ、下段のCLIPの影響は急速に弱まりますが、T5は描画過程のはるか後まで画像に影響します。
専門的な用途の可能性
プロジェクトページやYouTube動画は、広報向けのかわいいミーム画像の生成を重視しています。NVIDIAの研究は従来どおり、写実的な画像やVFXの作業工程を改善する可能性、そしてディープフェイク画像・動画を改善する可能性を控えめに扱っています。
例では初心者やアマチュアが要素の位置を大まかに描きます。より体系的なVFX工程では、正確な輪郭に基づき、eDiffiがテキストから画像への処理で複数の動画フレームを解釈できるでしょう。例えば、グリーンスクリーンやアルゴリズムで背景を除いた人物の輪郭を使えます。

Runway MLはすでにAIロトスコーピングを提供しています。この例で人物の周囲に見える緑はアルファ層を表します。分離は、実際の緑の背景をアルゴリズムで消した結果ではなく、機械学習で行われました。 出典: https://twitter.com/runwayml/status/1330978385028374529
訓練済みのDreamBoothキャラクターとeDiffiの画像間パイプラインを使えば、あらゆる潜在拡散モデルにとって難題である時間的一貫性に取り組めます。適用する画像の境界と内容は、ユーザーのキャンバス上にあらかじめ配置されます。訓練データを記憶した固定DreamBoothモデルは、実際の太極拳の演技者をロボットに変えるような生成内容に、時間的な連続性を与えられるかもしれません。解釈可能性には不利でも、再現性、忠実度、連続性には有利です。
手法、データ、テスト
eDiffiは公開データセットと独自データセットの集合で訓練されました。事前訓練済みCLIPモデルで厳しく選別し、全体の美的スコアを下げる画像を除外しました。最終的には約10億組のテキストと画像が残り、訓練画像の短辺は64ピクセルを超えます。
複数のモデルを訓練しました。基本モデルと超解像モデルはすべて、AdamWオプティマイザー、学習率0.0001、重み減衰0.01、バッチサイズ2048を使用しました。
基本モデルはNVIDIA A100 GPU 256基で、二つの超解像モデルはそれぞれNVIDIA A100 GPU 128基で訓練しました。
NVIDIAのImaginaire PyTorchライブラリを使用しました。COCOとVisual Genomeは評価に使い、最終モデルの訓練には含めませんでした。テストにはMS-COCOの変種を使いました。比較対象はGLIDE、Make-A-Scene、DALL-E 2、Stable Diffusion、GoogleのImagenとPartiです。
類似の先行研究と同様、評価にはゼロショットFID-30Kを用いました。COCOの検証セットから、訓練に使った画像やテキストではないキャプション30,000件を無作為に選び、画像合成用のテキストプロンプトとしました。
生成画像と正解の参照画像とのFréchet Inception Distance(FID)を計算し、生成画像のCLIPスコアも記録しました。

COCO 2014検証データによる、最新手法と比較したゼロショットFIDテストの結果。値が低いほど良好です。
eDiffiは、はるかにパラメーターの多いシステムと比べても、最も低い、つまり最良のゼロショットFIDを得ました。Partiは200億パラメーター、テストに使った最高仕様のeDiffiモデルは91億パラメーターです。
結論
eDiffiは既存システムにデータと複雑さを増やし続ける代わりに、より知的で階層的な方法を採用しています。潜在拡散による画像生成の、要素の絡み合いや編集不能性といった難しい障害に対する、歓迎すべき代案です。
Stable DiffusionのsubredditやDiscordでは、公開される可能性のあるeDiffiコードを直接組み込むか、その原理を独自に再実装する方法が話し合われています。ただし新パイプラインは、SDのメジャーバージョン番号を変更するほど大きく異なります。一部の後方互換性を失う代わりに、潜在拡散の魅力的な想像力を犠牲にせず、最終画像を大幅に制御できる可能性があります。
初出:2022年11月3日。


