Andersonの視点
DALL-E 2は関係を理解せず、ただ物を貼り合わせているだけなのか?

 Unite.AI を Google の優先ソースに追加

ハーバード大学の新しい研究論文は、注目を集めるOpenAIのテキスト画像生成フレームワークDALL-E 2が、出力の多くは驚くほど精緻であるにもかかわらず、合成写真の要素間で乳児でも理解する水準の関係を再現することさえ難しいと示唆している。
研究者はクラウドソーシングで募った169人を対象に調査した。人間の最も基本的な関係の意味理解に基づくDALL-E 2画像を、生成に使ったテキストプロンプトとともに提示した。画像とプロンプトが関連するか尋ねると、求められた非常に単純な関係を適切に示すと評価された画像は22%未満だった。

新論文の実験画面。参加者はプロンプトに一致する画像をすべて選んだ。画面下部の注意書きとは別に、実際はすべての画像が表示されたプロンプトから生成されていたが、参加者はそれを知らなかった。 出典:https://arxiv.org/pdf/2208.00005.pdf
結果は、異なる要素を結合するDALL-Eの見かけ上の能力が、それらの要素が実世界の学習データで共起する可能性が低くなるほど弱まることも示唆する。
例えば「子供がボウルに触れる」画像は87%の一致率だった。つまり参加者は画像の大半をプロンプトに関連すると選んだ。一方、同様に写実的な「猿がイグアナに触れる」画像では11%にとどまった。

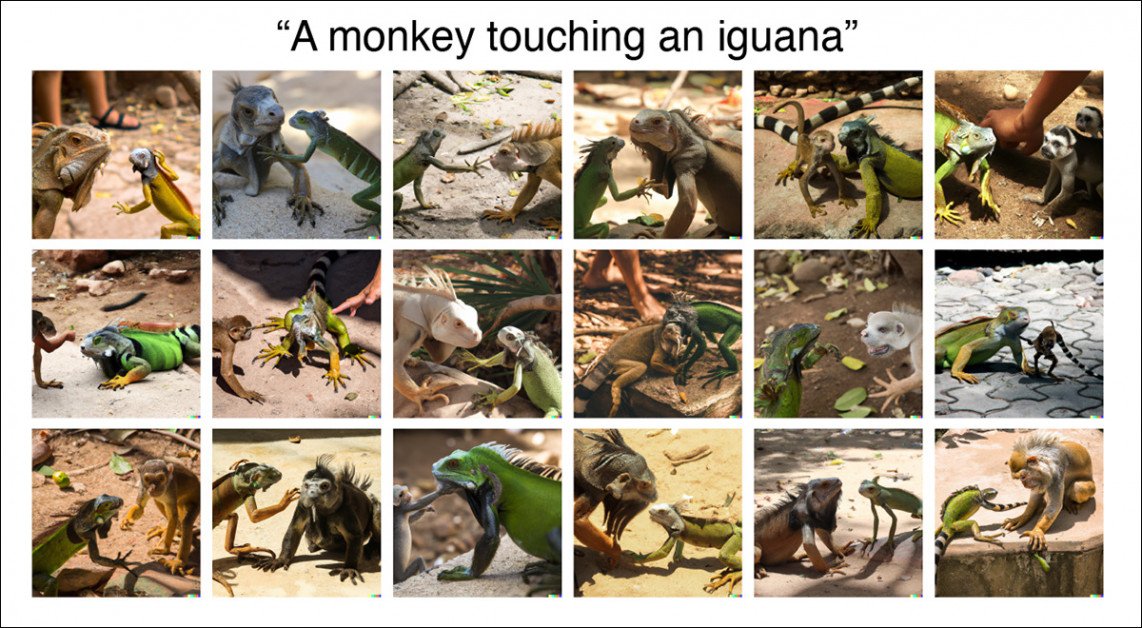
DALL-Eは「猿がイグアナに触れる」という起こりにくい出来事の描写に苦労する。学習データにその出来事がまれで、あるいは存在しないためかもしれない。
後者ではDALL-E 2は大きさだけでなく種までよく間違える。その出来事を示す実際の画像が少ないためと考えられる。対照的に、子供と食べ物に関する学習写真は多く、その下位領域は十分発達していると考えるのが自然だ。
大きく異なる画像要素の並置が苦手なことは、人々がシステムの写実性と幅広い解釈力に目を奪われ、単に一つの要素を別の要素へ不自然に貼り付けた場合を批判的に見ていない可能性を示す。DALL-E 2公式サイトの次の例がそうだ。
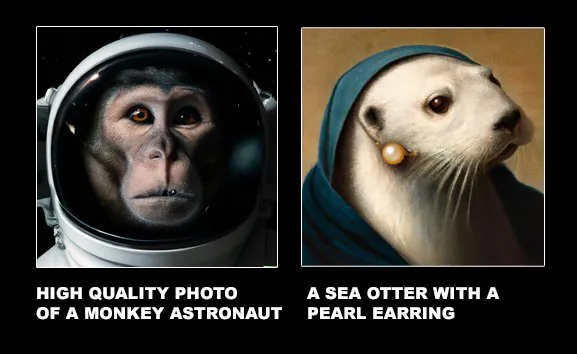
DALL-E 2公式例に見られる切り貼り合成。 出典:https://openai.com/dall-e-2/
新論文は次のように述べる*。
「関係の理解は人間の知能の基本的要素であり、発達の初期に現れ、素早く自動的に知覚の中で計算される。
「DALL-E 2が基本的な空間関係(例えば中、上、下)にも苦労することは、何を学んだにせよ、人間が世界を柔軟かつ頑健に構造化するための表現はまだ学んでいないことを示唆する。
「この困難を直接解釈すれば、DALL-E 2のようなシステムには、まだ関係的な構成性がないということになる。」
著者らはDALL-E系列のようなテキスト誘導画像生成システムが、ロボット工学で一般的なアルゴリズムから恩恵を得られると提案する。そこではエージェントが多様な要素を単に混ぜるのでなく実際に環境と相互作用する必要があるため、個々の対象と関係を同時にモデル化する。
その一つであるCLIPortは、DALL-E 2の品質評価要素と同じCLIPの仕組みを使う。
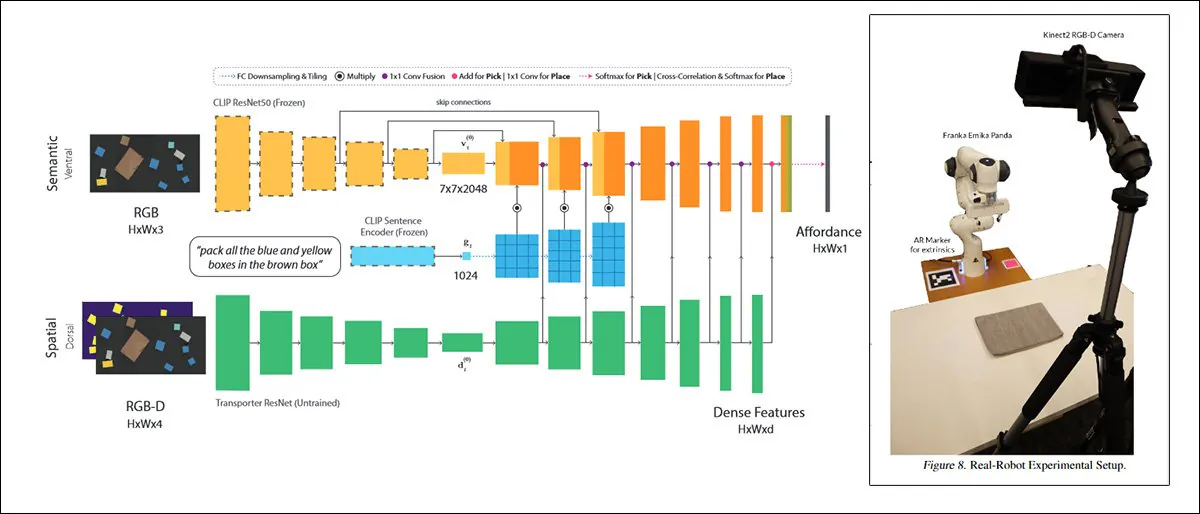
ワシントン大学とNVIDIAの2021年の共同研究CLIPortは、非常に実用的な文脈でCLIPを使うため、学習するシステムは物理的関係を理解せざるを得ない。この動機はDALL-E 2や同様の空想的な画像合成フレームワークにはない。 出典:https://arxiv.org/pdf/2109.12098.pdf
著者らは別の改善案として、DALL-Eのような画像合成システムで乗算的効果を単一の計算層に組み込み、情報処理能力を参考にした生物学的 システムと同様の方法で関係を計算することを挙げる。
新論文の題名はテキスト誘導画像生成における関係理解の検証で、ハーバード大学心理学部のColin ConwellとTomer D. Ullmanが執筆した。
初期の批判を超えて
DALL-E 2出力の写実性と一貫性の背後にある「手品」を論じながら、著者らはDALL-E型の画像生成システムの欠点を見つけた先行研究に触れる。
今年6月、カリフォルニア大学バークレー校は反射と影の扱いが難しいことを指摘した。同月、韓国の研究はDALL-E 2型出力の独自性と独創性を批判的に検討した。NYUとテキサス大学が公開直後に実施した予備分析は、画像の構成性など重要な要素にさまざまな問題を発見した。先月はイリノイ大学とMITの共同研究が構成性を改善するアーキテクチャの提案を行った。
研究者らはAditya RameshなどDALL-Eの主要人物も、属性の結び付け、相対的な大きさ、文字などの課題を認めていると述べる。
Googleの競合画像合成システムImagenの開発者もDrawBenchという新しい比較システムを提案した。これは多様な指標で各フレームワークの画像の正確さを測る。
一方、新論文の著者は、アルゴリズム指標の比較よりも人間の判断を生成画像に適用することで、弱点とその軽減策をより適切に見つけられるのではないかと提案する。
研究
そのため新プロジェクトは心理学的原則に基づき、現在の関心の高まり、特にプロンプトエンジニアリングから一歩引く。これは実質的にDALL-E 2や類似システムの欠点を認める行為であり、そうした回避策を必要とする制約を調べ、可能なら対処するためだ。
論文は次のように述べる。
「本研究は、認知・発達・言語学の文献で記述、検討、提案されてきた15の基本関係に注目する。具体的な空間関係(XがYの上にある)と抽象的な行為者の関係(XがYを助ける)の両方を含む。
「プロンプトは属性の複雑さや詳細を加えず意図的に単純にした。例えば『ロバとタコがゲームをしている。ロバはロープの一端を、タコはもう一端を持つ。ロバはロープを口でくわえる。猫がロープを跳び越える』の代わりに『ナイフの上の箱』を使う。
「この単純さでも人間心理のさまざまな下位領域の広い関係を捉え、モデルの失敗の可能性をより目立たせ具体化する。」
著者らはProlificで米国在住の169人を募集した。平均33歳で、59%が女性だった。
参加者には3×6の格子に並べた18画像を見せ、上部にプロンプト、下部に「すべて、一部、またはどの画像も表示のプロンプトから生成されていない可能性がある」という注意書きを置き、関連すると考えた画像を選んでもらった。
画像は言語・発達・認知の文献を基にし、8つの物理関係と7つの行為者の関係を含んだ。以下で具体的に示す。
物理関係
中、上、下、覆う、近く、遮られる、上にぶら下がる、および結び付けられる。
行為者の関係
押す、引く、触れる、打つ、蹴る、助ける、および 妨げる。
これらの関係はすべて、前述したコンピューター科学以外の研究分野に由来する。
プロンプト用に6つの物体と6つの行為者、計12の対象を選んだ。
物体
箱、円柱、毛布、ボウル、ティーカップ、および ナイフ。
行為者
男、女、子供、ロボット、猿、および イグアナ。
(社会学や心理学の堅い研究では定番ではないイグアナを加えたのは「楽しみのため」だったと研究者らは認める。)
関係ごとに2つの対象を無作為に5回抽出し、異なる5プロンプトを作った。合計75をDALL-E 2に入力し、それぞれ最初の18画像を使った。変種や再試行は許可しなかった。
結果
論文は次のように述べる*。
「参加者の評価したDALL-E 2画像と生成プロンプトの一致率は全般に低く、75の異なるプロンプトで平均22.2% [18.3, 26.6]だった。
「行為者の35プロンプトでは平均28.4% [22.8, 34.2]で、物理的な40プロンプトの平均16.9% [11.9, 23.0]より高かった。」

研究結果。黒い点は全プロンプトを表し、各点が1プロンプトに相当する。色は行為者の関係か物理的対象、つまり物体の関係かを区別する。
人間とアルゴリズムの画像知覚の違いを比較するため、研究者らは画像をOpenAIのオープンソースViT-L/14 CLIPベースのフレームワークで評価した。点数を平均すると両結果の間に「中程度の関係」があった。CLIP自体が画像生成に寄与することを考えると意外かもしれない。

CLIP(ViT-L/14)と人間の回答の比較結果。
研究者らは、アーキテクチャ内の別の仕組みと、学習データの偶然の過多や不足の組み合わせが、CLIPがDALL-Eの制約を認識しても常に問題を解決できない理由を説明しうると述べる。
著者らはDALL-E 2が関係理解を組み込んだ画像を再現する能力は、あるとしても名目的だと結論する。関係理解は人間に非常に早く発達する知能の基本的側面だ。
「DALL-E 2のようなシステムに構成性がないという考えは、『チュチュを着た赤ちゃんダイコンの漫画がプードルを散歩させる』といった驚くほどもっともらしい応答を見た人には意外かもしれない。この種のプロンプトはすべての部分を正しい位置に配置し、構成的な概念の妥当な近似を生むことが多い。
「しかし構成性は、それまで一緒に見たことのないものも含め、単に貼り合わせる能力だけではない。構成性には物事を結び付ける規則の理解が必要だ。関係はそうした規則である。」
人がTレックスをかむ
意見 OpenAIはDALL-E 2ベータ版の収益化後、より多くの利用者を受け入れている。今では生成の大半が有料なので、関係理解の欠点はより目立つ可能性がある。「失敗」するたび費用がかかり、返金もないからだ。
少し早く招待された私たちは関係の不具合を観察する時間があり、最近まではシステムを試す自由も大きかった。
例えばジュラシック・パークのファンにとって、DALL-E 2で恐竜に人を追わせるのはとても難しい。「追う」はDALL-E 2の検閲システムには含まれないようだし、恐竜映画の長い歴史は、現実にはありえない種の出会いでも、少なくとも予告編や宣伝写真として豊富な学習例を与えるはずだ。
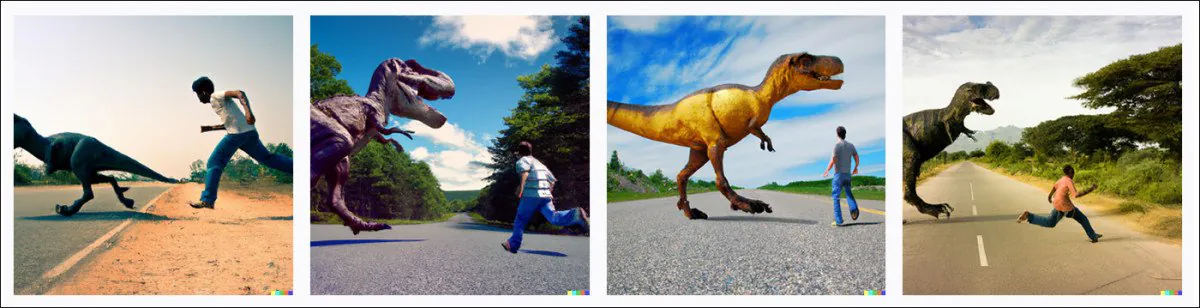
「道路で男を追うTレックスのカラー写真」というプロンプトへのDALL-E 2の典型的応答。 出典:DALL-E 2
上の画像は「[恐竜]が[人]を追う」というプロンプトの変形で典型的に現れる。いくら詳細を加えてもTレックスは従わない。最初の2枚では男がほぼTレックスを追い、3枚目では安全を軽視して接近し、最後では巨大な獣と並んで走るように見える。この主題で約10~15回試しても、恐竜は同じように「気が散っている」。
DALL-E 2が参照できた学習データは、「男が恐竜と戦う」、例えば恐竜100万年(1966年)のような古い映画の宣伝写真だけだったのかもしれない。捕食者の王からのジェフ・ゴールドブラムの有名な逃走は、その少量のデータでは外れ値なのだろう。
* 筆者が著者らの本文内引用をハイパーリンクに変換した。
2022年8月4日初公開。