
AIモデルとプラットフォーム
イノベーティブなバイオインスパイアードセンサー:動きを検出し、トラジェクトリーを予測する

 Unite.AI を Google の優先ソースに追加
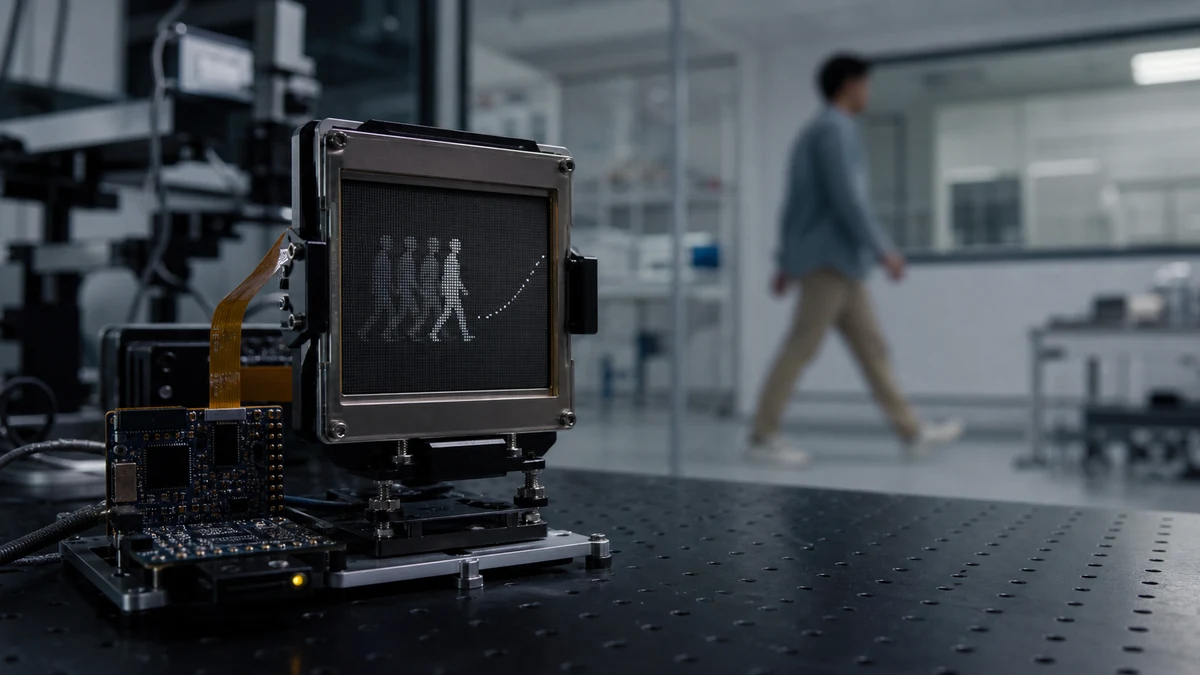
アールト大学の研究者は、単一のビデオフレーム内で動く物体を検出し、その将来の動きを正確に予測できる、革新的でバイオインスパイアードなセンサーを開発しました。Nature Communicationsの論文で説明されている、この高度なセンサーは、ダイナミックビジョンセンシング、自動検査、産業プロセス制御、ロボットガイダンス、自動運転技術などの分野で多数の潜在的な応用があります。
伝統的な動き検出システムは、複数のコンポーネントと複雑なアルゴリズムを必要とし、フレームごとの分析を実行するため、非効率性と高エネルギー消費につながります。これらの限界を解決するために、アールト大学のチームは、人間の視覚システムからインスピレーションを得て、センシング、メモリ、処理を1つのデバイスに統合したニューロモルフィックビジョンテクノロジーを作成しました。このテクノロジーは、動きを検出し、トラジェクトリーを予測することができます。
フォトメモリスタ:新技術の核心
研究者のテクノロジーは、フォトメモリスタの配列に基づいています。フォトメモリスタは、光に対して電流を生成する電気装置です。フォトメモリスタには、ユニークな特性があります。光を切ると、電流はすぐには停止しませんが、徐々に減少します。この特性により、フォトメモリスタは、最近の光への露出を「記憶」することができます。したがって、フォトメモリスタの配列で構成されるセンサーは、瞬間的な情報だけでなく、前の瞬間のダイナミックメモリもキャプチャすることができます。
「私たちのテクノロジーのユニークな特性は、1つのフレームに複数の光学イメージを統合できることです」と、研究を主導した研究員のHongwei Tanは説明しています。「各イメージの情報は、後のイメージに隠された情報として埋め込まれています。言い換えると、ビデオの最後のフレームには、前のすべてのフレームの情報が含まれています。これにより、単純な人工ニューラルネットワークを使用して最後のフレームだけを分析することで、動きを早期に検出することができます。結果として、コンパクトで効率的なセンシングユニットが実現します。」
テクノロジーの能力の実証
研究者は、テクノロジーの能力を示すために、単語の文字を1つずつ表示するビデオを使用しました。すべての単語が「E」で終わるものの、従来のビジョンセンサーは、「E」が「APPLE」または「GRAPE」の後の文字であるかどうかを判断できませんでした。しかし、フォトメモリスタの配列は、最後のフレームの隠された情報を利用して、前の文字を推測し、単語をほぼ100%の精度で予測することができました。
別の実験では、研究チームは、3つの異なる速度で移動するシミュレートされた人のビデオをシステムに表示しました。システムは、単一のフレームを分析することで動きを認識し、さらに後のフレームを正確に予測することができました。
自動運転車とインテリジェント輸送への影響
正確な動き検出とトラジェクトリー予測は、自動運転技術とインテリジェント輸送システムにとって非常に重要です。自動運転車は、車、自転車、歩行者、その他の物体の動きを予測することで、情報に基づいた決定を下す必要があります。フォトメモリスタの配列にマシンラーニングシステムを統合することで、研究者は、センサー内で全情報フレームを処理することで、将来の動きを予測することができることを実証しました。
「私たちのコンパクトなインセンサーメモリとコンピューティングソリューションは、自動ロボティクスとヒューマンマシンインタラクションに新たな機会を提供します」と、Sebastiaan van Dijken教授は述べています。「フォトメモリスタを使用する私たちのシステムで得られるインフレーム情報は、冗長なデータフローを回避し、リアルタイムでエネルギー効率的な意思決定を可能にします。」


