
Andersonの視点
DALL-E 2のユニークな解決策:二重の意味

 Unite.AI を Google の優先ソースに追加
要点DALL-E 2は「bat」のような曖昧な単語を1つの画像内で複数のオブジェクトに分割する。
もっと見る
- DALL-E 2は「bat」のような曖昧な単語を1つの画像内で複数のオブジェクトに分割する。
- この意味論的誤りは、CLIP誘導モデルがより大規模なデータセットで学習するにつれて悪化する。
- DALL-E 2が生成した同音異義語を含む画像の80%以上が、意図しない二重解釈を示した。
イタリア語を学ぶ人は、日常的な家政用品である「ほうき」を説明する際に、文脈に注意することを早くから学習します。なぜなら、イタリア語のほうきの言葉には、非常にNSFWな動詞としての第二の意味があるからです*。私たちは、言葉の意味を解釈し、適用する能力を早くから身につけますが、これは、DALL-E 2やStable Diffusionのような超大規模な画像合成システムに伝えることは容易ではありません。なぜなら、これらのシステムは、OpenAIのContrastive Language-Image Pre-training (CLIP)モジュールに依存しており、オブジェクトとその特性をより自由に扱うからです(ただし、潜在的な拡散画像および動画合成空間で進歩を遂げています)。
この欠陥を研究するために、新しい研究コラボレーションが、Bar-Ilan UniversityとAllen Institute for Artificial Intelligenceから行われ、DALL-E 2がこのような意味の誤りにどの程度傾向しているかを調べました:

DALL-E 2で二重の意味が分割される – ただし、どの潜在的な拡散システムでも同じ例が生成される可能性があります。右上の画像では、プロンプトから「gold」を削除すると、魚の種類が変わります。一方、ゼブラクロッシングの場合は、重複する関連付けを削除するために、道路の表面を明示的に指定する必要があります。ソース: https://export.arxiv.org/pdf/2210.10606
著者らは、この二重の解釈の傾向は、CLIPガイドの拡散モデルすべてに共通しており、モデルのトレーニングデータが増加するにつれてこの傾向が強くなることを発見しました。論文では、「軽量版」のテキストから画像へのモデルのエラー率が低いことも指摘されています。たとえば、DALL-E Mini(現在はCraiyon)やStable Diffusionは、同種の誤りをはるかに少なく出力します(ただし、後者は、プロンプトにまったく従わないことが多いためで、これは別種の誤りです)。

単純なプロンプト「date」は、DALL-E 2が単語の複数の意味のうち二つを呼び出すように強制し、単語「fan」も二重の意味を持ち、3番目の画像では、単語「cone」が、プロンプトで指定されていない食物をアイスクリームに変えます。
この効率的な語彙分離の方法について説明すると、論文では次のように述べられています:
‘シンボル – そして文の構造 – はあいまいであるかもしれませんが、解釈が構築されると、このあいまいさはすでに解決されています。たとえば、飛んでいる「bat」は、木の棒または動物として解釈できますが、私たちの解釈は、飛んでいる木の棒または飛んでいる動物のいずれかになりますが、同時にはなりません。単語「bat」が解釈で使用されてオブジェクト(たとえば、木の棒)を表すと、同じ解釈で別のオブジェクト(動物)を表すために再利用することはできません。’
DALL-E 2は、この制限を受けないことが論文で指摘されています:

「A bat is flying over a baseball stadium」 – 最初の画像は論文から、他の3つはDALL-E 2に同じプロンプトを入力したものです。
この特性は、リソース感度と命名されています。
論文では、DALL-E 2が示す3つの異常な挙動が特定されています。単語またはフレーズが二つの異なるエンティティに解釈され、同じシーンでそれぞれのエンティティがレンダリングされることがあります。単語が二つの異なるエンティティの修飾子として解釈されることがあります(上記の「goldfish」の例など)。単語が同時に修飾子と別のエンティティとして解釈されることがあります(「a seal is opening a letter」のプロンプトの例など):

「a seal is opening a letter」 – 最初の画像は論文から、隣の3つはDALL-E 2の同一の再現です。写真のような例は、追加のテキスト「photo, Canon50, 85mm, F5.6, award-winning photo」を使用しました。
著者らは、この点で拡散モデルが2つの失敗モードを示すと指摘しています。ユーザープロンプトの曖昧な単語が結果として、具体化された単語とその概念の表現を示すことが多いこと。さらに、概念漏れが発生し、1つのオブジェクトの特性が別のレンダリングされたオブジェクトに「漏れ」込むことがあります。
‘私たちが調査した現象は、DALL-E 2の言語能力の限界を示唆しており、将来的にテキストエンコード、生成モデル、または両方の問題が原因であるかどうかを調査するための新たな研究の道を開いています。より広く、提案されたアプローチは、テキストから画像へのモデルのデコード過程を使用して、帰納的バイアスと短所を明らかにする他のシナリオに拡張できます。’
17の単語を使用して、DALL-E 2が入力を複数の出力に分割する傾向を調べた結果、同音同形異義語の重複が216枚の画像の80%以上で発生していることがわかりました。
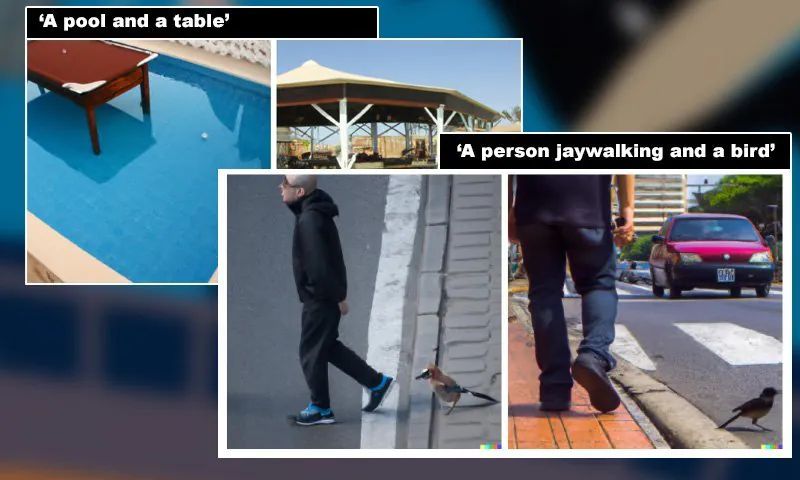
研究者らは、具体的で場合によっては過剰に詳しい表現が、重複を防ぐためにどの程度必要かを調べるために、刺激-コントロールペアを使用しました。エンティティとプロパティのテストでは、10のペアを作成し、刺激プロンプトが92.5%の場合に共有プロパティを呼び出し、コントロールプロンプトは6.6%の場合にのみ呼び出すことがわかりました。
「例として、シマウマと道路を考えてみましょう。シマウマは実体ですが道路を修飾し、DALLE-2は横断歩道を繰り返し生成します。おそらくシマウマの縞と横断歩道が似ているためです。仮説どおり、対照用のシマウマと砂利道は通常横断歩道のない種類の道路を指定し、実際、このプロンプトの対照サンプルには一つも横断歩道がありません。」





