
ベスト
おすすめAIウェブスクレイピングツール10選(11月 2026)

 Unite.AI を Google の優先ソースに追加
Unite.AIは、レビュー製品へのリンク利用により報酬を受け取る場合があります。これは当社の編集評価に影響しません。 アフィリエイト開示をご覧ください。
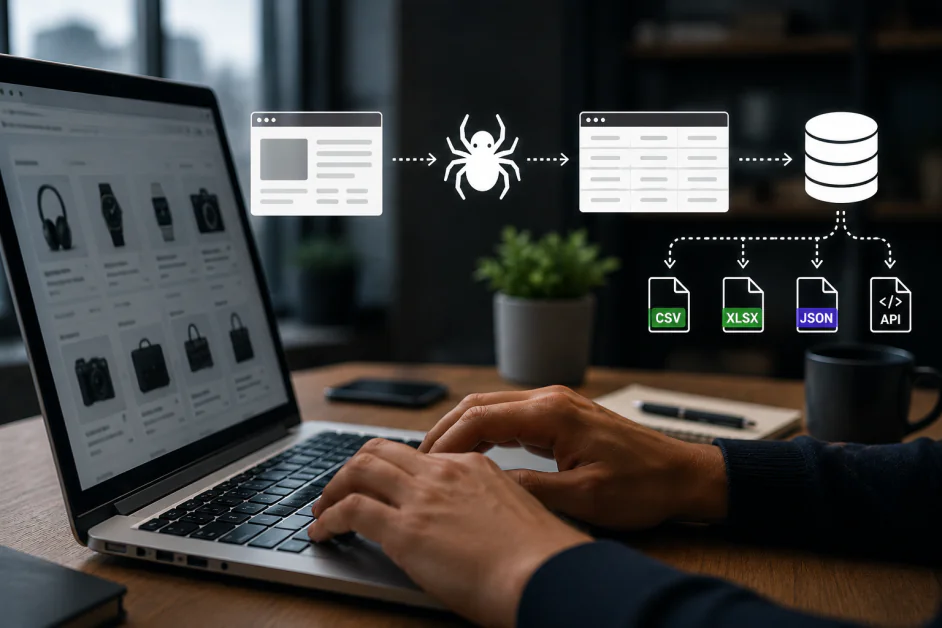
要点スクレイピングツールは、すべての収集を一つの問題として扱うのではなく、読み込み後のジョブに合わせて選定すること。
もっと見る
- スクレイピングツールは、すべての収集を一つの問題として扱うのではなく、読み込み後のジョブに合わせて選定すること。
- ワークフローの責任者は、ソースサイトと必要な出力の両方を理解している人に割り当てること。
- レンダリングやプロキシが合計を膨らませるため、見出しのリクエスト件数ではなく、実際に利用可能なレコード数を見積もること。
最適なAIウェブスクレイピングツールは、ページを読み込んだ後に何をしたいかによって異なります。リサーチアシスタントには、読みやすいコンテンツと情報源へのリンクが必要です。市場インテリジェンスシステムには、大規模でも一貫性のあるレコードが求められます。対話型エージェントには、複数の手順をクリックして進み、セッションを維持できるブラウザーが必要な場合があります。
このガイドでは、エンタープライズ向け収集プラットフォーム、コンテンツAPI、ノーコードスクレイパー、検索データサービス、マネージドブラウザーなど、こうした用途に対応する10種類のツールを紹介します。各製品がどのように情報を収集するのか、誰がワークフローを保守できるのか、そして試作品を継続的なプロセスへ移行する際に重要となるトレードオフを評価します。
当チームは、このガイドで取り上げるすべてのソリューションを独自に評価し、機能、実用面での強み、制約、ランキングに反映したユースケースへの適合性を検証しました。
おすすめAIウェブスクレイピングツールを比較
| AIツール | 最適な用途 | 主な強み |
|---|---|---|
| Bright Data | エンタープライズ向けのデータ収集と多様なデータパイプライン | Scraper APIs、Browser API、Scraper Studio、データセット、プロキシ |
| Firecrawl | AIアプリケーション向けウェブコンテンツ | 検索、スクレイピング、サイトマップ作成、クロール、Markdown、JSON、操作、MCP |
| Apify | 再利用可能なスクレイピングジョブとクラウドオーケストレーション | Actors、Crawlee、スケジュール、ストレージ、プロキシ、API、MCP |
| Browse AI | ノーコードのデータ収集と変更監視 | AIを活用した設定、ロボット、アラート、スケジュール、連携機能 |
| SearchAPI | 構造化された検索結果と地域に応じたリサーチ | Google、マップ、ショッピング、動画、AI検索サービス、JSON |
| Octoparse | 繰り返し実行できるクラウド処理を備えたビジュアルスクレイピング | テンプレート、AIアシスタント、自動検出、クラウド実行、エクスポート |
| Browserless | PuppeteerとPlaywright向けのマネージドブラウザー | ホスト型ブラウザー、永続セッション、REST API、MCP |
| ScrapingBee | アプリケーションAPIを介したマネージドデータ抽出 | AIによる抽出、CSS/XPath、Markdown、JSシナリオ、MCP |
| Oxylabs | 対応が難しい一般公開ウェブサイトからのマネージドデータ取得 | Web API /Scrape、レンダリング、構造化出力、MCP |
| Diffbot | 自動抽出とエンティティインテリジェンス | 抽出、標準スキーマ、クロール、Knowledge Graph |
AIウェブスクレイピングツールの選び方
作業内容に合ったツールを選ぶ
AIナレッジベース向けには、読みやすいテキスト、構造化出力、情報源のURLが保持されることを優先しましょう。繰り返し行うビジネスリサーチでは、プログラミングインターフェースよりも、ビジュアルロボットや変更アラートのほうが重要な場合があります。対話型エージェントには、セッションの継続性とブラウザー制御に注目してください。検索結果APIが解決するのは別の課題です。検索データを提供する一方、リンク先のページを収集する作業は別途必要です。
ワークフローの担当者を決める
ノーコードプラットフォームなら、アナリストが抽出手順を直接調整できます。APIは、開発者がデータ収集をアプリケーションに組み込むための明確なインターフェースを提供します。クラウドジョブプラットフォームはスケジュール設定とストレージを追加する一方、マネージドブラウザーでは自動化ロジックの多くをチーム側で担います。適切な選択肢とは、対象ウェブサイトと必要な出力の両方を理解している人が保守を担当できるものです。
表面的なリクエスト数ではなく、有用なレコードを基準に予算を組む
ジョブの完了にかかる費用を、必要なフィールドと照らし合わせて比較しましょう。レンダリング、プレミアムプロキシ、ブラウザーの稼働時間、AIによる抽出、ストレージ、再試行によって、総額は変わる可能性があります。無料クレジット、ブラウザーユニット、検索リクエストは、それぞれ異なる尺度です。定期的に作業する場合は、成功応答数だけでなく、完全性、重複、新しさ、利用可能なレコード1件あたりのコストも追跡しましょう。
おすすめAIウェブスクレイピングツール10選
1. Bright Data
Bright Dataは、1つのプラットフォームで複数の方法を使ってウェブデータを取得する必要がある組織に、総合的に最もおすすめできるサービスです。すぐに使えるScraper APIs、収集済みデータセット、Scraper Studio、Web Unlocker、プロキシサービスを幅広く提供しています。たとえば、eコマースインテリジェンスチームは、よく知られた小売業者には構造化フィードを使い、専門的なマーケットプレイス向けには独自の収集機能を構築できます。データプログラムが単一のウェブサイトや部門にとどまらない場合、この幅広さが特に役立ちます。
インタラクティブなページ向けのBrowser APIは、Puppeteer、Playwright、Seleniumを使って開発者が操作できるブラウザーをホストします。ブラウザーの実行環境にプロキシ管理とCAPTCHAへの対応を組み合わせており、Chrome DevToolsにも対応しているため、エンジニアは問題のあるセッションを調査できます。これは、既存のデータセットをダウンロードするだけでなく、目的の情報を取得できるようになる前に、ワークフロー内でページの移動や操作が必要な場合に役立ちます。
主なトレードオフは、製品の選択とコスト管理です。ブラウザーのトラフィック、スクレイピングの結果、データセットの購入はそれぞれ異なるワークロードに当たるため、単一の目安価格でプラットフォーム全体を説明することはできません。Bright Dataは、データ収集の品質、対象範囲、支出を管理する担当者がいるチームに適しています。対象を絞ったプロジェクトなら、よりシンプルな抽出APIを使うほうが早く本番環境に移行できる場合があります。
メリットとデメリット
- 1つのプラットフォームで幅広いデータ収集方法を利用できる
- ホスト型ブラウザーが主要な自動化ライブラリーに対応
- 既製のAPIとデータセットにより、導入準備を短縮できる
- 製品ごとに個別のコスト計画が必要
- カスタムパイプラインには、引き続きエンジニアリング面での管理が必要
2. Firecrawl
Firecrawlは、ウェブコンテンツをAIアプリケーションに役立つコンテキストへ変換する開発者に最適です。検索、スクレイピング、サイトマップ作成、クロールの各ツールにより、ページの発見からウェブサイト全体の収集までをカバーします。Markdownと構造化JSONを利用することで、取得後に必要となるデータ整理の手間も軽減できます。そのため、リサーチアシスタントやナレッジベース製品は、未加工のHTMLからナビゲーションメニューを取り除く作業を減らし、質問への回答により多くの労力を割けます。
現在提供されているInteract機能により、プラットフォームは実行中のブラウザーを扱う作業にも対応します。エージェントは自然言語で操作を記述することも、ブラウザーコードを実行することもでき、呼び出しの間も状態を維持し、認証済みのプロファイルを再利用できます。クリックやフィルター操作、ログインを経てからでないと情報を取得できないページに対応するうえで、これは大きな機能追加です。MCPとコマンドラインからも利用できるため、Firecrawlは従来型のアプリケーションAPIにとどまらず、エージェント開発のワークフローにも組み込みやすくなっています。
Firecrawlは、コンテンツの取得が当面の課題で、保存と検索の仕組みはすでにアプリケーション側にある場合に最も力を発揮します。チームは引き続き、クロールの範囲を定め、元のURLを保持し、フィールドが欠落している場合と値が空の場合を区別する必要があります。オープンソースのコードを使えば別の導入方法も選べますが、ホスト型とセルフマネージド型が同一だと決めつけず、選択した導入形態における具体的な機能と運用要件を評価する必要があります。
メリットとデメリット
- MarkdownとJSONがAIパイプラインに適している
- Interactが状態を維持するブラウザータスクに対応
- API、MCP、CLIから利用可能
- 取得したコンテンツには検証が必要
- セルフマネージド型の導入には運用作業が必要
3. Apify
Apifyは、再利用可能なスクレイピングツールと、それらを運用する環境を求めるチームにとって、ここで最も有力な選択肢です。マーケットプレイスでは、入力を受け取り、クラウド上で実行され、結果を返すパッケージ化されたプログラムであるActorsが提供されています。既存のActorsを使えば一般的なデータ収集タスクを効率化でき、カスタムActorsを作成すれば、開発者は独自の抽出ロジックを維持できます。これによりApifyは、実験的な取り組みを再現可能な本番ジョブへとつなぐ有用な橋渡し役となります。
周辺のプラットフォーム機能は、スケジュール設定、結果の保存、プロキシの利用、監視、各種連携など、運用に欠かせない要素を担います。開発者は、オープンソースのクローリング・ブラウザー自動化ライブラリーであるCrawleeを使って開発することもできます。ApifyのMCPサーバーを使えば、AIエージェントからActorsを利用できます。そのため、同じパッケージ化されたツールを、インターフェースごとに別のスクレイパーを実装することなく、アプリケーション、スケジュール実行するパイプライン、アシスタントで活用できます。
プラットフォームの選定と同じくらい、Actorの選定にも注意を払う必要があります。提供者によって、価格、メンテナンス、入力オプション、出力品質は異なる場合があります。また、実行が成功しても、期待したレコードをすべて収集できたとは限りません。ジョブのスキーマを管理し、変更を監視し、選んだActorとインフラの利用料を予算に含める担当者がいる場合、Apifyは特に有力な選択肢です。一方、1ページから手作業でデータを抽出するだけなら、これほどのオーケストレーションは通常必要ありません。
メリットとデメリット
- 既製のActorsとカスタムActorsを同じプラットフォームで利用できる
- スケジュール設定、保存、監視により、ジョブの反復実行を支援
- MCPにより、エージェントのワークフローでActorsを利用可能
- Actorのメンテナンス状況と品質にはばらつきがある
- 利用料とActorの料金を予算に織り込む必要がある
4. Browse AI
ソフトウェア開発プロジェクトを立ち上げずに、定期的にウェブデータを収集したいビジネスユーザーには、Browse AIをおすすめします。現在のセットアップでは、指定したページを読み取ってデータ構造を提案し、ユーザーが項目を確認・調整できます。繰り返しデータを抽出するには、引き続きロボットのトレーニングが中心となります。商品一覧、ディレクトリの項目、競合情報などを使い慣れた表に集める業務・マーケティングチームにとって、実用的な方法です。
特に優れているのはモニタリング機能です。ロボットにページを定期的に確認させ、追加や変更を検知し、どこが変わったのかを説明するアラートを届けられます。ワークフローを使えば複数ページにまたがる収集を連携でき、API、Webhook、スプレッドシートとの連携によって、結果をチームがすでに利用しているツールに取り込めます。そのため、価格のモニタリングを、手作業でブラウザーを確認する作業の繰り返しではなく、継続的な業務プロセスにできます。
使いやすいからといって、データの定義を明確にする必要がなくなるわけではありません。どの変更をアラートの対象にするかを決め、ページネーション、ログイン手順、結果が空の場合が正しく処理されることを確認する必要があります。大幅なサイト改修には、依然として手作業での対応が必要になることがあります。抽出した行をビジネスチームが確認し、ロボットを保守できる場合にBrowse AIは最適です。一方、バージョン管理を厳密に行うブラウザーのロジックを必要とする開発者には、コードベースのサービスが適している可能性があります。
メリットとデメリット
- AIを活用した項目設定により、導入のハードルが下がる
- 定期モニタリングで重要な変更を把握できる
- スプレッドシート、API、Webhookと連携できる
- サイトの大幅な変更時には再トレーニングが必要になることがある
- 複雑なロジックには、慎重なワークフロー設計が必要
5. SearchAPI
検索結果を構造化データとして収集したい場合には、専門ツールとしてSearchAPIをおすすめします。Google APIを利用すると、検索結果のリンクや検索機能に関する情報をJSON形式で取得できるため、変更される検索結果ページに対応したパーサーを保守する必要がありません。幅広いカタログには、Maps、ショッピング、ニュース、動画、対応するAI検索機能などの情報源が含まれます。別のウェブサイトをクロールするための足がかりではなく、情報の発見や検索での可視性そのものをデータとして扱う場合に、特に役立ちます。
この用途では、ローカライズも重要です。地域、国、言語、デバイスのパラメーターを指定すれば、検索対象のコンテキストを定めたうえで市場を調査できます。SEOアプリケーションで特定の都市における検索クエリを追跡したり、リサーチアシスタントで関連する情報源を見つけ、取得したリンクを後から参照できるように保存したりできます。検索エンジンによって利用可能なパラメーターや結果のフィールドが異なるため、エンジンごとのドキュメントを確認することが重要です。
SearchAPIは、ワークフローで実際に必要とする検索エンジンとフィールドに基づいて選ぶ必要があります。検索結果は、リンク先ページの全内容を含むものではありません。また、情報量の多い検索結果の表示形式も、すべてが同じスキーマに従うわけではありません。リクエスト数を見積もり、必要な処理能力を確認したうえで、結果の一部が欠けていても適切に処理できるようにする必要があります。任意のウェブサイトからデータを抽出したい場合や、対話型のブラウザーセッションが必要な場合は、このガイドの別のツールから検討を始めるほうが適しています。
メリットとデメリット
- 構造化された結果により、SERPパーサーの保守が不要になる
- 検索エンジンと関連エンジンを幅広く網羅
- 詳細なローカライズ設定
- 検索結果だけでは、リンク先ページからのデータ抽出を代替できない
- 利用できるフィールドやパラメーターは検索エンジンによって異なる
6. Octoparse
OctoparseのAI Copilotと、人間が介在する自動化の仕組みを紹介します。動画:Octoparse。
Octoparseは、スクレイパーを視覚的に設計し、繰り返し実行したいアナリストに適しています。現在のプラットフォームでは、すぐに使えるテンプレートやAI Assistantによるセットアップに加え、デスクトップアプリケーションでのページ自動検出を利用できます。ユーザーはブラウザー用のコードを一から作成せずに、生成されたタスクを調整できます。各ページの項目だけでなく、ページ間の遷移順序も重要となる商品カタログ、ディレクトリ、一覧情報の収集に便利な柔軟性です。
クラウド実行を使えば、準備したタスクを、個人のコンピューターを起動したままにせずに継続的な収集プロセスへと移行できます。スケジュール設定、並列実行、IPローテーション、エクスポート先との連携により、大規模なジョブもデスクトップ上の試作段階を超えて実行できます。情報源となるウェブサイトと必要なデータを把握している一方で、独自のブラウザー自動化サービスを保守したくないチームにとって、視覚的に操作できる点は特に魅力的です。
Octoparseを活用するには、タスクを慎重に設計することが大切です。ページネーション、無限スクロール、フォームの手順、重複レコードによって、一見成功したように見える実行結果の意味が変わることがあります。クラウドの利用枠やプランの機能が、想定するスケジュールとデータ量に合っているか確認しましょう。ワンクリックで使える手軽なツールよりも抽出手順を細かく制御したいチームには、情報源のページが変更された際にタスクを調整できる担当者を決めたうえで、Octoparseをおすすめします。
メリットとデメリット
- テンプレートとAI支援により、セットアップが簡単になる
- 視覚的な編集で、詳細なデータ抽出タスクを作成できる
- クラウド実行により、定期的なデータ収集が可能
- 複雑なサイトではタスクの調整が必要
- クラウド機能は選択したプランによって異なる
7. Browserless
Browserlessは、ブラウザーの制御は自分で行いながら、ホスティングとスケーリングはマネージドサービスに任せたい開発者におすすめです。既存のPuppeteerやPlaywrightのスクリプトをリモートブラウザーに接続できるため、すでに動作する自動化コードがあるプロジェクトに適しています。複数の操作を伴うデータ収集や、JavaScriptを多用するインターフェース、単純なリクエストを超えてセッションを維持する必要がある場合に、特に役立ちます。
このサービスは、スクレイピング、スクリーンショット、PDF、カスタムブラウザー機能向けのREST APIも提供しています。ホスト型MCPサーバーを使えば、AIエージェントからブラウザーツールを利用でき、セッション機能や認証済みプロファイルは、継続性が求められるワークフローを支えます。そのためBrowserlessは、カスタムのデータ収集ツールを開発する開発者にも、実際のブラウザーを使って情報を巡回・収集する必要があるエージェントにも適しています。
購入時に重要なのは、ブラウザーの利用量がどのように計算されるかです。現在、無料プランには月1,000ユニットと同時に利用できるブラウザー2台が含まれますが、スクレイピングが1,000回保証されるわけではありません。ブラウザーの利用時間に応じてユニットが消費され、プロキシ通信やCAPTCHAの認証成功には追加料金がかかります。セッションの上限はプランによって異なります。データ抽出のロジックと出力の確認は引き続きチーム側で行う必要があるため、ビジュアル型のロボット作成ツールよりもブラウザー制御を重視する場合に、Browserlessの魅力が最も発揮されます。
メリットとデメリット
- 使い慣れたPuppeteerやPlaywrightのワークフローをそのまま活用できる
- スクレイピングとページのエクスポートに対応するREST API
- セッション機能とMCPは対話型エージェントに適している
- ブラウザーの利用時間や追加機能によってユニット消費量が変わる
- カスタムのデータ抽出には、引き続きアプリケーション側のロジックが必要
8. ScrapingBee
ScrapingBeeは、長時間稼働するブラウザーを直接制御するのではなく、マネージド型のスクレイピングリクエストを利用したい開発者にとって有力な選択肢です。APIはページの取得とJavaScriptのレンダリングをプロキシ管理と組み合わせており、CSSやXPathのルール、またはAIへの指示を使ってデータを抽出できます。この組み合わせは、複数のウェブサイトから構造化データを取得したい一方で、自社でブラウザー群を運用したくないプロジェクトに役立ちます。
JavaScriptのシナリオでは、データ収集の前にクリック、スクロール、入力、待機などの操作を実行できます。Markdown形式の出力はAIを活用したコンテンツワークフローに役立ち、スクリーンショットを使えばレンダリング後のページを記録できます。現行製品では、CLIやMCPによるアクセスに加えて、特定の対象向けの専用APIも提供されています。ページ構造や質問の予測が難しい場合には自然言語による抽出を使い、安定した項目には明示的な抽出ルールを使うことができます。
ホスト型ブラウザープラットフォームとの実務上の違いは、ScrapingBeeがリクエストとその戻り値に重点を置く一方、より広範なジョブはカスタムアプリケーションが担う点にあります。複数ページの連携、重複排除、更新スケジュール、レコードの検証は、引き続き別途仕組みを用意する必要があります。レンダリングやプロキシのオプションなど、使用する機能によってクレジット消費量も変わります。シンプルなHTTPインターフェースを重視し、データパイプラインのオーケストレーションを自社コードで管理したいアプリケーションチームにおすすめです。
メリットとデメリット
- セレクタールールとAI抽出を柔軟に使い分けられる
- レンダリングとシナリオ機能で動的なページにも対応
- Markdown、CLI、MCPに対応し、AIワークフローを支援
- 高度なリクエストオプションを使うとクレジット消費量が増える
- 複数ページにまたがるジョブには、引き続きオーケストレーションが必要
9. Oxylabs
Oxylabsは、アクセスが難しい公開ウェブサイトをマネージド型で利用し、大規模なデータ収集へと拡張したいチームに有力な選択肢です。現行のWeb APIには、ウェブデータの取得と構造化を行う/Scrapeが含まれており、JavaScriptのレンダリングとアクセス処理がサービスに統合されています。製品ラインアップには/Searchとブラウザーインフラストラクチャーもあり、情報の発見、データ抽出、サイト上での操作のいずれからタスクが始まるかに応じて、複数の方法を選べます。
対象に応じたオプションを使えば、一般的な検索サイトやECサイトから有用な項目を取得できます。また、MCPやAgent Skillsを介したエージェント連携により、AIワークフローにデータ収集を組み込めます。Oxylabsは、Classic Web Scraper APIについても、引き続き別途ドキュメントを公開しています。既存の連携を維持している場合は、この区別が重要です。Classic APIを運用しているチームは、新しいWeb APIの例がそのまま使えると考えず、対応するドキュメントを参照してください。
対象サイトへのアクセス難度、処理量、またはアクセスインフラストラクチャーの維持コストを考慮して、マネージドプラットフォームを利用する価値がある場合に、Oxylabsは特に適しています。それでも、必要なスキーマ、データの鮮度を保つ期間、不完全なレコードの扱いは、アプリケーション側で定義する必要があります。導入前に、選択したAPIの世代、対象別オプション、利用モデルが実際のジョブに合っているか確認しましょう。小規模な手動抽出であれば、ビジュアル型スクレイパーのほうが手軽な場合があります。
メリットとデメリット
- レンダリングとアクセスの管理基盤
- 対象に応じた構造化抽出の選択肢
- 現行のWeb APIはエージェントとの連携に対応
- 従来のAPIと現行のAPIでは個別のセットアップが必要
- 出力品質には引き続きアプリケーション側での確認が必要
10. Diffbot
ページのレイアウトを再現することより、ページ上の情報を理解することが重要な場合に、私たちはDiffbotをおすすめします。Extractはコンピュータービジョンと自然言語処理を使ってページを分類し、標準スキーマに基づく構造化JSONを生成します。複数の情報源から記事や商品を収集するチームにとって、ページを比較可能なレコードに変換するために必要な、サイトごとの解析コードを減らせる可能性があります。
Knowledge Graphは、これに関連しつつも別のニーズに応えます。公開ウェブからすでに収集された組織、人物、記事などのエンティティを扱う機能です。レコードには複数の情報源からの情報をまとめ、意味のある関係性を通じてエンティティ同士を結び付けられます。そのためDiffbotは、1つのページに表示される項目を超えた文脈が必要な情報補完、企業調査、インテリジェンスアプリケーションに役立ちます。
トレードオフとなるのは、Diffbotのデータモデルに適合させる必要がある点です。ページの種類や項目が目的に合っていれば、標準化された抽出は有用ですが、特殊な項目や独自の操作が必要な場合には、別の方法が適していることもあります。チームは、指定したURLから情報を抽出することと、既存のナレッジグラフにクエリを実行することを区別したうえで、それぞれの対象範囲と情報源の鮮度を評価する必要があります。Diffbotは、スプレッドシートに数行をコピーするだけでよいユーザーよりも、正規化された情報プロダクトを構築する技術チームに適しています。
メリットとデメリット
- 自動分類によりパーサーの開発作業を削減
- 標準スキーマにより類似ページのデータを正規化しやすい
- Knowledge Graphでエンティティの文脈を把握できる
- 標準項目では専門的な要件に対応できない場合がある
- 情報抽出とグラフへのアクセスでは用途が異なる
よくある質問
AI搭載のウェブスクレイピングツールとは?
AIは、項目の特定、ページ内容の解釈、抽出手順の生成、ブラウザー操作の制御に役立ちます。セットアップ時にAIを使うツールもあれば、抽出のたびに使うツールもあります。また、すべてのリクエストで言語モデルを使わずに、クリーンなコンテンツを提供することでAIアプリケーションを支援するサービスもあります。AIというラベルに頼るのではなく、データ収集の課題を解決できる機能を選びましょう。
スクレイピングとブラウザー自動化の違いは?
スクレイピングは情報を収集します。ブラウザー自動化は、メニューを開く、検索語を入力する、複数の手順からなるワークフローを進めるといったページ上の操作を実行します。この2つは組み合わせて使われることがよくあります。自動化したブラウザーで目的のページの状態に移動し、その後、抽出処理で必要な項目を収集します。こうした操作が不要な場合は、直接APIリクエストを送るほうが一般に簡単です。
技術者ではないチームに最適なツールは?
定期的なデータ収集や変更の監視を手軽に始めるなら、私たちはBrowse AIを第一におすすめします。タスクの手順をより視覚的に細かく制御したい場合は、Octoparseも有力な選択肢です。どちらも、取得したレコードを誰かが確認し、情報源のウェブサイトが変更されたことを把握できる体制で使うのが最適です。
AIやRAGのパイプラインでは、スクレイピング結果の何を保持すべきですか?
情報源のURL、収集時刻、ページタイトルに加え、アプリケーションが必要とするテキストや構造化項目を保持しましょう。Markdownは読みやすい文書構造を保つのに適し、JSONは定義済みのレコードを扱うのに役立ちます。重複コンテンツを取り除き、ナビゲーション用のテキストと主要な内容を混在させないようにします。情報の出所を保持しておけば、後から回答の根拠をたどり、情報を更新しやすくなります。
マネージドブラウザーを使う価値があるのはどんな場合ですか?
JavaScriptの実行、複数の操作、またはセッションの維持が必要で、ブラウザーの実行環境を自分たちでホスティングしたくない場合に、マネージドブラウザーが役立ちます。既存のPuppeteerまたはPlaywrightのコードを使う場合は、Browserlessが特化型の選択肢です。静的なページを1つ取得するだけなら、よりシンプルなフェッチAPIや抽出APIのほうが、使用するリソースを抑えられることがあります。
無料の1,000ユニットは、スクレイピング1,000回と同じですか?
いいえ。ユニットやクレジットの計算方法はプロバイダーごとに異なります。Browserlessではブラウザー接続を最大30秒単位で計測し、プロキシ経由の通信やCAPTCHAの解除には追加のユニットを消費します。他のサービスでは、リクエストのオプション、レコード数、または計算リソースに応じて課金されます。異なる無料枠を同一視せず、ワークフロー全体のコストを見積もりましょう。
AIによる抽出結果は、確認なしで信頼できますか?
有効なJSONレスポンスでも、レコードが抜け落ちていたり、項目が誤って解釈されていたりすることがあります。必須項目を定義し、型と範囲を確認し、サンプルとして元のページをチェックし、レコード数の変化を監視しましょう。定期的に実行するジョブでは、すべてのレスポンスを完全なデータセットとみなすよりも、失敗や結果が空の場合の状態を明示するほうが有用です。
AIウェブスクレイピングツールについてのまとめ
Bright Dataは幅広いウェブデータ活用プログラムに最適な総合的おすすめです。一方、ウェブページをAI対応コンテンツに変換するなら、Firecrawlが最適な出発点です。再利用可能なツール、スケジュール実行のジョブ、クラウド運用がプロジェクトの中心となる場合は、Apifyを選びましょう。
ビジネスチームにとって、Browse AIを使えば定期的なモニタリングを手軽に始められ、Octoparseなら、より複雑な抽出タスクを視覚的に調整できます。必要な出力が構造化された検索データである場合は、SearchAPIが専門性の高い選択肢です。
Browserlessは、使い慣れた自動化ライブラリを使って、管理されたブラウザー実行環境を利用したい開発者に適しています。アプリケーションにマネージド型のデータ抽出リクエストがより適している場合は、ScrapingBeeが有力な代替候補です。Oxylabsは大規模で高度な公開ウェブデータの取得に適しており、Diffbotは標準化された抽出とエンティティ情報の分析に強みがあります。
長期的に最適な選択肢とは、チームが維持できるワークフローで必要な情報を提供するものです。タスクに合った収集方法を選び、情報源の文脈を保ち、リクエストしたページ数ではなく、実際に活用できる出力を基準に価値を判断しましょう。




