
ベスト
10 ベスト AI ウェブスクレイピングツール (9月 2026)

 Unite.AI を Google の優先ソースに追加
Unite.AIは、レビュー製品へのリンク利用により報酬を受け取る場合があります。これは当社の編集評価に影響しません。 アフィリエイト開示をご覧ください。
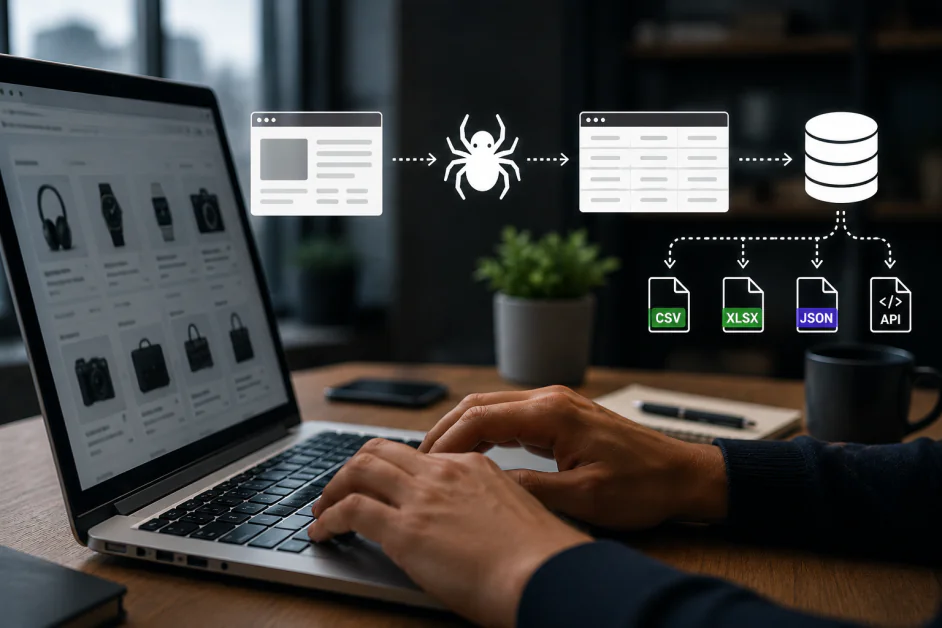
AI ウェブスクレイピングツールは、もはや単なるページパーサーではありません。最高のプラットフォームは、チームが公開ウェブデータを収集し、乱雑なページを構造化データセットに変換し、取得強化生成(RAG)システムに供給し、市場をモニタリングし、AI エージェントに信頼できるウェブコンテキストを提供できるよう支援します。
この変化は重要です。なぜなら、スクレイピングは価値が高まると同時に、うまく行うのが難しくなっているからです。現代のウェブサイトは動的でパーソナライズされ、スクリプトが多用され、しばしば不正利用防止システムで保護されています。有用なスクレイピングツールは、HTML を取得するだけでなく、レンダリング、抽出ロジック、スケジューリング、データ品質、コンプライアンス、そしてデータが実際に使用されるシステムへの引き渡しを処理しなければなりません。
最適な選択は用途次第です。大規模な公開データプログラム向けにエンタープライズグレードのインフラが必要なチームもあれば、LLM 対応の Markdown が欲しい、定期的なリサーチ用のノーコードロボットが欲しい、ブラウザ自動化向けの開発者プラットフォームが欲しい、または検索結果 API が欲しいというチームもあります。以下のツールはそれらの異なるアプローチを網羅しています。
本ガイドでは、すべてのソリューションを独自に評価し、機能、実務上の強み・制限、そしてランキングに反映されたユースケースへの適合性を検証しました。
AI ウェブスクレイピングツール比較
| AI ツール | 最適な用途 | 主な強み |
|---|---|---|
| Bright Data | エンタープライズ向けウェブスクレイピング、プロキシインフラ、AI データパイプライン | スクレイパー API、ブラウザ API、スクレイパー Studio、Web Unlocker、プロキシインフラ、データセット、RAG ワークフロー |
| Firecrawl | AI アプリケーション向けにウェブサイトをクリーンな LLM 対応コンテンツに変換 | スクレイプ、クローリング、検索、マッピング、モニタリング、Markdown、構造化 JSON、ブラウザ操作、API、MCP、オープンソース |
| Apify | スケーラブルなスクレイパー、ブラウザ自動化、データエージェントを構築する開発者向け | Actor マーケットプレイス、Crawlee、Playwright、Puppeteer、Selenium、スケジューリング、プロキシ、データセット、API、MCP 統合 |
| Browse AI | ノーコードウェブスクレイピング、ウェブサイトモニタリング、定期的なビジネスデータ収集 | AI ロボット、ポイント&クリックトレーニング、ウェブモニタリング、スケジュール抽出、事前構築ロボット、統合 |
| SearchAPI | AI、SEO、リサーチワークフロー向けのリアルタイム SERP と検索エンジンデータ | Google、Google Maps、Bing、YouTube、ショッピング・ニュースデータ、構造化 JSON、ジオターゲティング、プロキシローテーション、リトライ、MCP |
| ScrapingBee | AI 抽出と JavaScript レンダリングを備えた開発者向けスクレイピング API | 自然言語抽出、構造化 JSON、Markdown、JavaScript シナリオ、プロキシローテーション、スクリーンショット、専用 API、CLI、MCP |
| Octoparse | 動的ウェブサイトと定期的なクラウドジョブのビジュアルノーコードスクレイピング | ビジュアルワークフロービルダー、AI 自動検出、クラウド抽出、テンプレート、IP ローテーション、スケジューリング、エクスポート、API |
| Oxylabs | エンタープライズ向けスクレイピング API、AI グラウンディング、難しい公開サイト | Web Scraper API、AI Studio、ヘッドレスブラウザ、Web Unblocker、Fast Search API、構造化データ、ジオターゲティング |
| Diffbot | 自動ページ分類、エンティティ抽出、Knowledge Graph アクセス | Extract API、Crawl API、Knowledge Graph、エンティティ強化、自然言語処理、コンピュータビジョン、構造化データセット |
| ScrapeGraphAI | 構造化 JSON と AI フレームワーク統合を備えた自然言語抽出 | プロンプトベース抽出、JSON スキーマ、クローリング、モニタリング、JavaScript レンダリング、SDK、CLI、MCP、LangChain と CrewAI 統合 |
AI ウェブスクレイピングツールの選び方
まずは自分が抱えているウェブデータ課題の種類を明確にします。AI 製品にクリーンなウェブコンテキストを供給したい場合は、Markdown、構造化 JSON、クローリング制御、取得に適した出力を優先すべきです。定期的なビジネスリサーチが目的なら、ノーコードロボットやビジュアルワークフロービルダーが高速です。大規模な公開データ収集が必要な場合は、レンダリング、キュー、プロキシ制御、アンロック、モニタリング、信頼できる配信といったインフラの深さを確認してください。
次に、ワークフローを誰が保守するかを考えます。競合ページを追跡するマーケティングチームと、データパイプラインを構築するエンジニアリングチームでは求める製品は大きく異なります。優れたスクレイピングシステムは抽出を再現可能にしますが、検証の必要性を排除するわけではありません。ウェブサイトは変化し、フィールドはドリフトし、AI 補助抽出はページが曖昧でも自信満々に応答することがあります。最適な構成は、チームの技術スキル、レビュー工程、コンプライアンス要件に合致したものです。
10 ベスト AI ウェブスクレイピングツール
1. Bright Data
Bright Data は、ウェブデータ収集がコアビジネスシステムである場合に最も強力な選択肢です。スクレイパー API、ブラウザインフラ、プロキシ管理、アンロック技術、そして既製データセットを組み合わせ、チームが自前で全レイヤーを構築せずに大規模な公開ウェブデータを収集できます。
このプラットフォームは、マーケットインテリジェンス、e コマースモニタリング、検索インテリジェンス、AI 訓練データセット、RAG パイプライン、競合データ製品の構築に特に有用です。Bright Data は、複雑なワークフローを構築したい技術チームに十分な制御性を提供すると同時に、脆弱なスクレイピングスタックを維持したくないチーム向けに管理されたパスも用意しています。
この広範な機能は購入時の検討材料にもなります。Bright Data は、エンジニアリングまたはデータオペレーションの所有権を割り当て、承認対象を定義し、時間とともに品質とコストをモニタリングできる組織に最適です。対象サイトが限られた小規模チームは、軽量 API やノーコードサービスの方が適している場合があります。一方、規制が厳しいプログラムは、収集ポリシーを法務・プライバシーレビューと合わせる必要があります。
長所と短所
- 本ランキングで最も広範なインフラカバレッジ
- 高ボリュームかつ難易度の高い公開サイトに最適
- 既製スクレイパーとデータセットで構築時間を短縮
- AI データパイプライン、検索インテリジェンス、e コマースモニタリングに有用
- 小規模・断続的プロジェクトには過剰なインフラ
- チームは明確なデータガバナンスと対象サイトルールが必要
- 高度なユースケースは技術的設定とモニタリングが必須
2. Firecrawl
Firecrawl は AI 時代のウェブスクレイピング向けに設計されています。開発者が生の HTML を手作業でクリーンにしたり、ページレンダリングを管理したり、乱雑なサイトコンテンツを正規化したりする代わりに、ウェブページをクリーンな Markdown や構造化データに変換し、エージェント、取得システム、リサーチツール、製品ワークフローに供給できます。
魅力はアプリケーション層でのシンプルさです。開発者はページをスクレイプしたり、サイトをクローリングしたり、ウェブ検索したり、URL をマッピングしたり、変更をモニタリングしたり、構造化出力を要求したりでき、従来のスクレイパースタックに比べて配管作業が大幅に削減されます。Firecrawl は、AI アシスタント、ナレッジベース、リサーチワークフロー、RAG システムの最終成果物が対象の場合に特に適しています。
チームは Firecrawl をコンテンツ取得レイヤーとして位置付け、全データプラットフォームとみなさないようにすべきです。実運用では、対象スコーピング、重複排除、鮮度ルール、スキーマ検証、サイト変更時の可観測性が依然として必要です。価値は、簡潔な API とセルフホスティングの選択肢を求める開発者に最大化されますが、エンタープライズ向けの広範なプロキシ制御や管理データセットは提供されません。
長所と短所
- クリーンなウェブコンテキストが必要な AI アプリに最適
- Markdown と構造化出力で下流のクリーンアップを削減
- スクレイプ、クローリング、検索、マッピング、モニタリング向けの有用な API
- オープンソース版が技術チームにデプロイ柔軟性を提供
- フルプロキシやエンタープライズデータインフラプラットフォームではない
- 高度な抽出にはスキーマ設計と検証が依然として必要
- 厳格なコンプライアンス要件があるチームは、デプロイと保持選択肢を慎重に検討すべき
3. Apify
Apify は、開発者プラットフォームと豊富なマーケットプレイスの両方を求めるチームにとって強力な選択肢です。Actor モデルにより、スクレイパー、ブラウザ自動化、データワークフローを再利用可能なクラウドジョブとしてパッケージ化でき、スケジュール実行、API 呼び出し、ストレージ接続、チーム間共有が可能になります。
開発者は、Crawlee、Playwright、Puppeteer、Selenium、既存 Actor を用いてプロトタイプを構築し、Apify で実行、キュー、プロキシ、データセット、Webhook、統合を利用できます。これにより、単発のページ抽出ではなく、繰り返し可能なデータジョブが必要なチームに特に有用です。
Apify の柔軟性は強みであると同時に責任でもあります。チームは信頼できる Actor を選択し、バージョン管理し、実行をモニタリングし、コンピュート・プロキシ・ストレージ使用量を予算化する必要があります。再利用可能なビルディングブロックとクラウドオペレーションを一元化したい開発者に最適で、たまに利用するユーザーは目的特化型スクレイパーの方が学習が速いかもしれません。
長所と短所
- 一般的なターゲット向けの既製 Actor が多数ある大規模マーケットプレイス
- カスタムスクレイピングとブラウザ自動化向けの強力な開発者ツール
- スケジュール化された繰り返しデータ収集ワークフローに適合
- Crawlee のサポートで技術チームに柔軟なオープンソース基盤を提供
- マーケットプレイスの品質は Actor とユースケースによりばらつく
- サイト変更時にはカスタムジョブの保守が必要
- 非技術ユーザーはシンプルなビジュアルスクレイパーを好む可能性がある
4. Browse AI
Browse AI は、ウェブデータが必要だがスクレイパーを自作したくないビジネスチーム向けです。ユーザーはロボットに収集対象を見せてトレーニングし、オンデマンドまたはスケジュールでロボットを実行します。これにより、競合追跡、リスティングモニタリング、リード収集、在庫監視、繰り返しリサーチの自動化が容易になります。
最大の強みはアクセシビリティです。Browse AI は、エンジニアリングに依存せずにウェブサイトから構造化データを取得したい、オペレーション、マーケティング、採用、e コマース、リサーチチームに実用的な手段を提供します。開発者向けの最深層プラットフォームになることは目指さず、繰り返し可能なウェブデータ収集を手軽にすることに注力しています。
Browse AI は、対象ワークフローを明確に示し、人間がレビューできるケースで最も効果を発揮します。ユーザーはページネーション、ログイン手順、空状態、レイアウト変更をテストしてから自動化に依存すべきです。部門単位のプロジェクトには強力ですが、エンジニア主導のプログラムはリトライやデータ契約、デプロイ面でより細かな制御が必要になることがあります。
長所と短所
- ビジネスユーザー向けの強力なノーコード体験
- 繰り返しモニタリングとスプレッドシート型ワークフローに適合
- ポイント&クリックのロボットトレーニングがセレクタベース設定より簡単
- エンジニアリング支援なしでウェブデータが必要なチームに有用
- 複雑なロジック向けの開発者向けプラットフォームほど柔軟ではない
- 対象ページが大幅に変化するとロボットの調整が必要になることがある
- 大規模・高度にカスタマイズされたプログラムはノーコードアプローチを超える可能性がある
5. SearchAPI
SearchAPI は、検索エンジンの結果を構造化データとして取得したいチーム向けの特化型スクレイピングサービスです。単一の API で、オーガニックリンク、広告、ニュース、マップリスティング、ショッピング結果、ナレッジパネル、People Also Ask 質問、AI 生成検索機能など、選択したエンジンに応じた JSON 形式の結果を返します。
このプラットフォームは、SEO モニタリング、ローカル検索分析、マーケットリサーチ、製品インテリジェンス、リアルタイム検索コンテキストが必要な AI エージェントに特に有用です。SearchAPI は、ブラウザレンダリング、プロキシローテーション、リトライ、CAPTCHA 処理をリクエスト背後で管理し、ロケーション、言語、国、デバイス別クエリをサポートするローカリゼーションパラメータを提供します。ドキュメント化されたエンジンは、標準的な Google 結果に加えて、Google Maps、Bing、YouTube、ニュース、コマース検索体験などのソースもカバーしています。
SearchAPI は MCP サーバーも提供し、対応する AI アシスタントや開発環境と検索ツールを接続できます。トレードオフは「検索データ特化」:汎用クローラではなく、検索結果データ層に特化しています。プランはクレジットベースで、スループットはティアにより変動し、上流レイアウトが変わるとスキーマチェックが必要になる点に注意が必要です。
長所と短所
- 検索エンジンのリアルタイム SERP データを構造化して取得でき、検索スクレイパーやプロキシインフラの維持が不要
- 主要検索、マップ、動画、ニュース、ショッピングなど多様な専門エンジンをサポート
- ロケーション、言語、国、デバイス制御により順位追跡や市場リサーチに適合
- API と MCP アクセスで検索データをアプリや AI エージェントで実用化可能
- 任意のウェブサイトクロールではなく検索エンジン結果データに特化
- クレジットベースのプランとスループット制限により高ボリュームワークロードは予測が必要
- 検索エンジンが結果レイアウトを変更した際はフィールド検証が必要
6. ScrapingBee
ScrapingBee は、ヘッドレスブラウザやプロキシインフラを維持せずにウェブデータを収集・構造化したいチーム向けの開発者フレンドリーな API です。JavaScript レンダリング、プロキシローテーション、スクリーンショット、CSS/XPath 抽出、そして自然言語リクエストとフィールドルールを構造化 JSON に変換する AI 抽出層を統合しています。
このプラットフォームは、シンプルなページとインタラクティブサイトの両方を単一エンドポイントで取得したい開発者に特に有用です。JavaScript シナリオはクリック、スクロール、入力、待機を実行でき、Markdown 出力、専用 API、CLI、MCP 統合によりスクレイプしたコンテンツを分析、オートメーション、AI ワークフローに容易に組み込めます。ScrapingBee はフルスタックのスクレイピングスタックより導入が簡単ですが、プレミアムプロキシ、レンダリング、AI 機能を使用するとクレジット消費が増加します。
ScrapingBee は、エンジニアが管理リクエスト層を利用しつつ、オーケストレーションとデータ品質を自アプリで保持したいケースに最適です。チームはリトライ規則、スキーマ、クローリング境界、マルチページジョブの検証を定義すべきで、すべての HTTP 応答を信頼できるデータとみなさないようにします。非技術ユーザーにはビジュアルデスクトップスクレイパーが容易ですが、API チームは統合とデプロイの直接制御を得られます。
長所と短所
- 自然言語 AI 抽出でセレクタを手作業で構築せずに構造化 JSON を取得可能
- JavaScript レンダリングとスクリプトアクションで多くの動的ページワークフローに対応
- プロキシローテーション、スクリーンショット、Markdown 出力、専用 API が一サービスに統合
- CLI、MCP、オートメーション統合が開発者とエージェントのワークフローに適合
- AI 抽出やプレミアムプロキシ、JavaScript レンダリングを追加するとクレジット使用量が増加
- ビジュアルデスクトップスクレイパーではなく API ファースト製品
- 複雑なマルチページクローリングは依然としてオーケストレーションと品質チェックが必要
7. Octoparse
Octoparse は、開発者フレームワークではなくビジュアルワークフローを求めるユーザー向けの成熟したノーコードスクレイパーです。ページデータを検出し、抽出手順をガイドし、クラウドでスクレイピングジョブを実行でき、e コマースサイト、ディレクトリ、リスティング、検索ページ、その他構造化ウェブソースからの定期的な収集に有用です。
このプラットフォームは、クイックなブラウザ拡張スクレイプ以上のワークフロー制御が必要だが、コードを書きたくないチームに最適です。テンプレート、スケジューリング、クラウド抽出、自動エクスポート、動的ページ対応により、Octoparse はシンプルなノーコードツールとエンジニア主導スクレイピングプラットフォームの中間的実用性を提供します。
ビジュアルモデルは慎重なワークフローデザインを要求します。チームはページネーション、無限スクロール、ログイン状態、重複レコード、エラーブランチをテストしてからスケジュールジョブに依存すべきです。Octoparse は、これらのチェックを所有できるアナリストやオペレーションユーザーに適していますが、厳密なバージョン管理と自動テストを求める開発者は、API やコードファーストフレームワークを好むでしょう。
長所と短所
- ビジュアルワークフロービルダーはシンプルなワンクリックツールよりも制御性が高い
- クラウド抽出によりローカルマシン不要で定期ジョブが実行可能
- テンプレートで一般的なサイトとデータタイプのセットアップ時間を短縮
- 繰り返し構造化データセットが必要なオペレーションチームに適合
- 複雑なウェブサイトではワークフローデザインに時間がかかる
- コードファーストパイプラインを好む開発者チームには自然ではない
- 対象サイトが変化すると継続的なモニタリングが依然として必要
8. Oxylabs
Oxylabs は、スケールで信頼できる公開ウェブデータへのアクセスが必要で、プロキシローテーション、レンダリング、アンブロック層を自前で管理したくないチームに強く適合します。Web Scraper API は、幅広いターゲットから構造化公開データを収集し、スクレイピングインフラの多くを裏側で処理します。
同社は AI データワークフロー向けに AI Studio、Fast Search API、ブラウザ自動化、グラウンディング指向ユースケースにも深く進出しています。これにより、マーケットインテリジェンスシステム、検索モニタリング、モデルグラウンディングパイプライン、e コマースデータセット、エージェントワークフローで新鮮なウェブコンテキストが必要な組織にとって Oxylabs は有力です。
Oxylabs は、信頼性、ターゲットの難易度、地理的リーチがエンタープライズ志向サービスを正当化する場合に最も魅力的です。購入前にターゲットサイト、出力要件、応答時間、コンプライアンス所有権をマッピングすべきです。小規模プロジェクトはプラットフォーム全体のインフラ深さを活用しないかもしれませんが、大規模プログラムは収集成功が正確な正規化を保証しないため、独立した品質モニタリングが依然として必要です。
長所と短所
- エンタープライズグレードのスクレイピングとプロキシインフラが強力
- スケールと信頼性が求められる公開ウェブデータパイプラインに有用
- AI Studio と Fast Search API がエージェントとグラウンディングワークフローを支援
- 難易度の高い動的サイトやジオターゲティング収集に適合
- 技術・コンプライアンス要件が明確なチーム向けに最適化
- 小規模ノーコードプロジェクトに比べ過剰なインフラになる可能性
- 高度なワークフローはターゲット選定と検証に慎重さが必要
9. Diffbot
Diffbot は多くのウェブスクレイピングツールと異なり、ページやエンティティの「理解」に焦点を当て、単なるフィールド収集ではありません。抽出技術はページを分類し、構造化エンティティを特定し、ウェブデータを広範な Knowledge Graph に接続します。これは、生のスクレイプ行ではなく、豊富で正規化された情報が求められる場合に有用です。
この特性は、エンティティインテリジェンス、企業・人物データ、マーケットリサーチ、ナレッジグラフ、メディアモニタリング、構造化事実が必要な AI システムを扱うチームに特に関連します。簡易なポイント&クリックスクレイパーというより、ウェブスケールの抽出と知識層に近い位置付けです。
主な購入判断は、Diffbot のデータモデルがプロジェクトのエンティティとリレーションに合致するかどうかです。合致すれば、ページ固有のパーサーやエンリッチメントパイプラインを一から構築する手間を省けます。合致しない場合は、従来のスクレイパーが直接的な制御を提供します。評価時は代表的なページ、フィールドカバレッジ、更新頻度、エンティティ解決、そして下流での出典保持方法を検討すべきです。
長所と短所
- 自動抽出とエンティティ理解が強力
- Knowledge Graph へのアクセスで単一ページを超えるコンテキストを提供
- エンリッチメント、リサーチ、構造化インテリジェンスワークフローに有用
- 正規化エンティティが生データテーブルより重要なケースに最適
- シンプルなスプレッドシート型スクレイピングには直感的でない
- 最良の結果は Diffbot のモデルが対象コンテンツタイプに適合するかに依存
- チームは Knowledge Graph と API モデルを理解し、最大価値を引き出す必要がある
10. ScrapeGraphAI
ScrapeGraphAI は、ユーザーが自然言語で必要なデータを記述し、構造化出力を受け取れるよう設計されています。フィールドごとにセレクタを書く代わりに、URL を提供し、取得したい情報を定義し、AI 補助抽出でクリーンな JSON を返すことで、アプリケーション、リサーチワークフロー、エージェントに活用できます。
開発者がウェブデータを中心とした AI ワークフローを構築する際に特に適しています。抽出タスクが頻繁に変わる、あるいは LangChain、CrewAI、SDK、CLI、MCP 対応環境と接続したい場合に有用です。主な利点は柔軟性で、抽出ロジックがプロンプト駆動になるため、壊れやすいページセレクタに縛られません。
この柔軟性ゆえに検証が特に重要です。チームはスキーマ、リトライ動作、エビデンスフィールド、サンプルレビュー規則を本番利用前に定義すべきです。説得力のある回答が必ずしも完全な抽出を意味しないためです。ScrapeGraphAI は実験や適応的ワークフローに魅力的ですが、安定した高ボリュームジョブでは決定論的セレクタやハイブリッドアプローチ(AI をページ構造が変わる場合に限定使用)も有益です。
長所と短所
- 自然言語抽出は変化するタスクや探索的作業に有用
- 構造化 JSON 出力は AI アプリケーションとオートメーションワークフローに適合
- 開発者統合がエージェントとオーケストレーションユースケースをサポート
- セレクタ保守が実験速度を遅くする場合に役立つ
- AI 抽出は本番利用前に検証が必要
- プロンプト設計とスキーマが出力の一貫性に影響
- 純粋なビジュアルノーコードワークフローが必要なチームには不向き
よくある質問
ウェブスクレイピングツールが AI 搭載になる条件は何ですか?
AI 搭載スクレイパーは通常、ページ上のフィールドを特定する、ページコンテンツを構造化データに変換する、自然言語指示でブラウザを制御する、または抽出したコンテンツを AI システム向けに整形する、という4つの作業のいずれかを支援します。最良のツールでも、明確なプロンプト、スキーマ、検証、そして収集すべきデータのルールは必要です。
スクレイピングとブラウザ自動化の違いは何ですか?
スクレイピングはページからデータを抽出することに焦点を当てます。ブラウザ自動化は、クリック、スクロール、ログイン、フォーム入力、動的コンテンツ待機、マルチステップワークフローの実行など、ブラウザ操作全般を制御します。多くの最新ツールは両方を組み合わせますが、区別は重要です:静的な商品リストはスクレイピング作業、ナビゲーションとインタラクションが必要なフローはブラウザ自動化が必要です。
RAG システムに最適な出力形式はどれですか?
取得強化生成(RAG)システムは、クリーンテキスト、Markdown、構造化 JSON、メタデータ、安定したソース URL といった形式で最も効果的に機能します。目的はコンテンツを収集するだけでなく、チャンク化、検索、引用、品質チェックのために十分な構造を保持することです。生の HTML も利用可能ですが、AI アプリケーションで有用になるまでに余分なクリーンアップが必要になることが多いです。
AI スクレイパーは JavaScript サイトに対応できますか?
多くは対応可能ですが、品質は製品によります。いくつかのツールはブラウザでページをレンダリングし、いくつかはヘッドレスブラウザインフラを使用し、また別のツールはページ読み込み後の抽出に依存します。JavaScript 対応は、e コマース、マーケットプレイス、ソーシャルプラットフォーム、ダッシュボード、モダンウェブアプリなど、データが初期レスポンス後に現れるケースで重要です。
ノーコードスクレイパーは大規模プロジェクトに適していますか?
ノーコードスクレイパーは、定期的なビジネスワークフロー、競合モニタリング、リードリサーチ、オペレーションタスクに非常に有効です。大規模プログラムは最終的に API、キュー、モニタリング、プロキシインフラ、バージョン管理、データ検証、エンジニアリング所有権を必要とすることがあります。最適なノーコードツールは、ワークフローが明確で、カスタムスクレイパーを構築せずに速度を求めるチームに最も強みを発揮します。
ウェブスクレイピングは合法ですか?
ウェブスクレイピングの法的側面は、管轄地域、対象サイト、データ種別、アクセス手段、データ利用方法によって異なります。公開ウェブデータの収集でも、契約、プライバシー、知的財産、サイバーセキュリティ、プラットフォームポリシーの問題が生じる可能性があります。チームは適用法規、robots.txt と利用規約、社内コンプライアンス方針、データの機密性を確認した上でスクレイピングプログラムを実行すべきです。
AI が生成した抽出結果は検証すべきですか?
はい。AI はスクレイピングを柔軟にしますが、ページを誤読したり、フィールドを結合したり、隠れたコンテキストを見落としたり、レイアウト変更時に構造が不一致になることがあります。本番ワークフローにはスキーマチェック、サンプルレビュー、変更アラート、エラーハンドリング、機密決定に対する人的レビューを組み込むべきです。
AI ウェブスクレイピングツールに関する最終的考察
Bright Data は、真剣なインフラと大規模公開データプログラムが必要なチームにとって最も強力な選択肢です。Firecrawl は、LLM 対応のウェブコンテキストが必要な AI アプリに最も適合し、Apify は開発者にカスタムスクレイパー、Actor、ブラウザ自動化の柔軟なプラットフォームを提供します。
ビジネスチーム向けには、Browse AI と Octoparse が、エンジニアリングプロジェクトに全てを任せずに定期的なデータ収集を容易にします。ScrapingBee は、自然言語抽出、JavaScript レンダリング、構造化出力を提供する開発者フレンドリーな API として強力です。
SearchAPI は、SEO、リサーチ、AI エージェント向けに新鮮で構造化された検索エンジンデータが必要な場合に際立っています。Oxylabs はエンタープライズ向けスクレイピング API と難しい公開サイトに最適で、Diffbot はエンティティ抽出と Knowledge Graph コンテキストが重要な場合に魅力的です。そして ScrapeGraphAI は、AI ワークフロー向けに柔軟なプロンプト駆動抽出オプションを提供します。




