
AIモデルとプラットフォーム
ASUS、OCPでデュアルNVIDIA Vera CPU搭載サーバー「XA P2N-E2」を発表

 Unite.AI を Google の優先ソースに追加
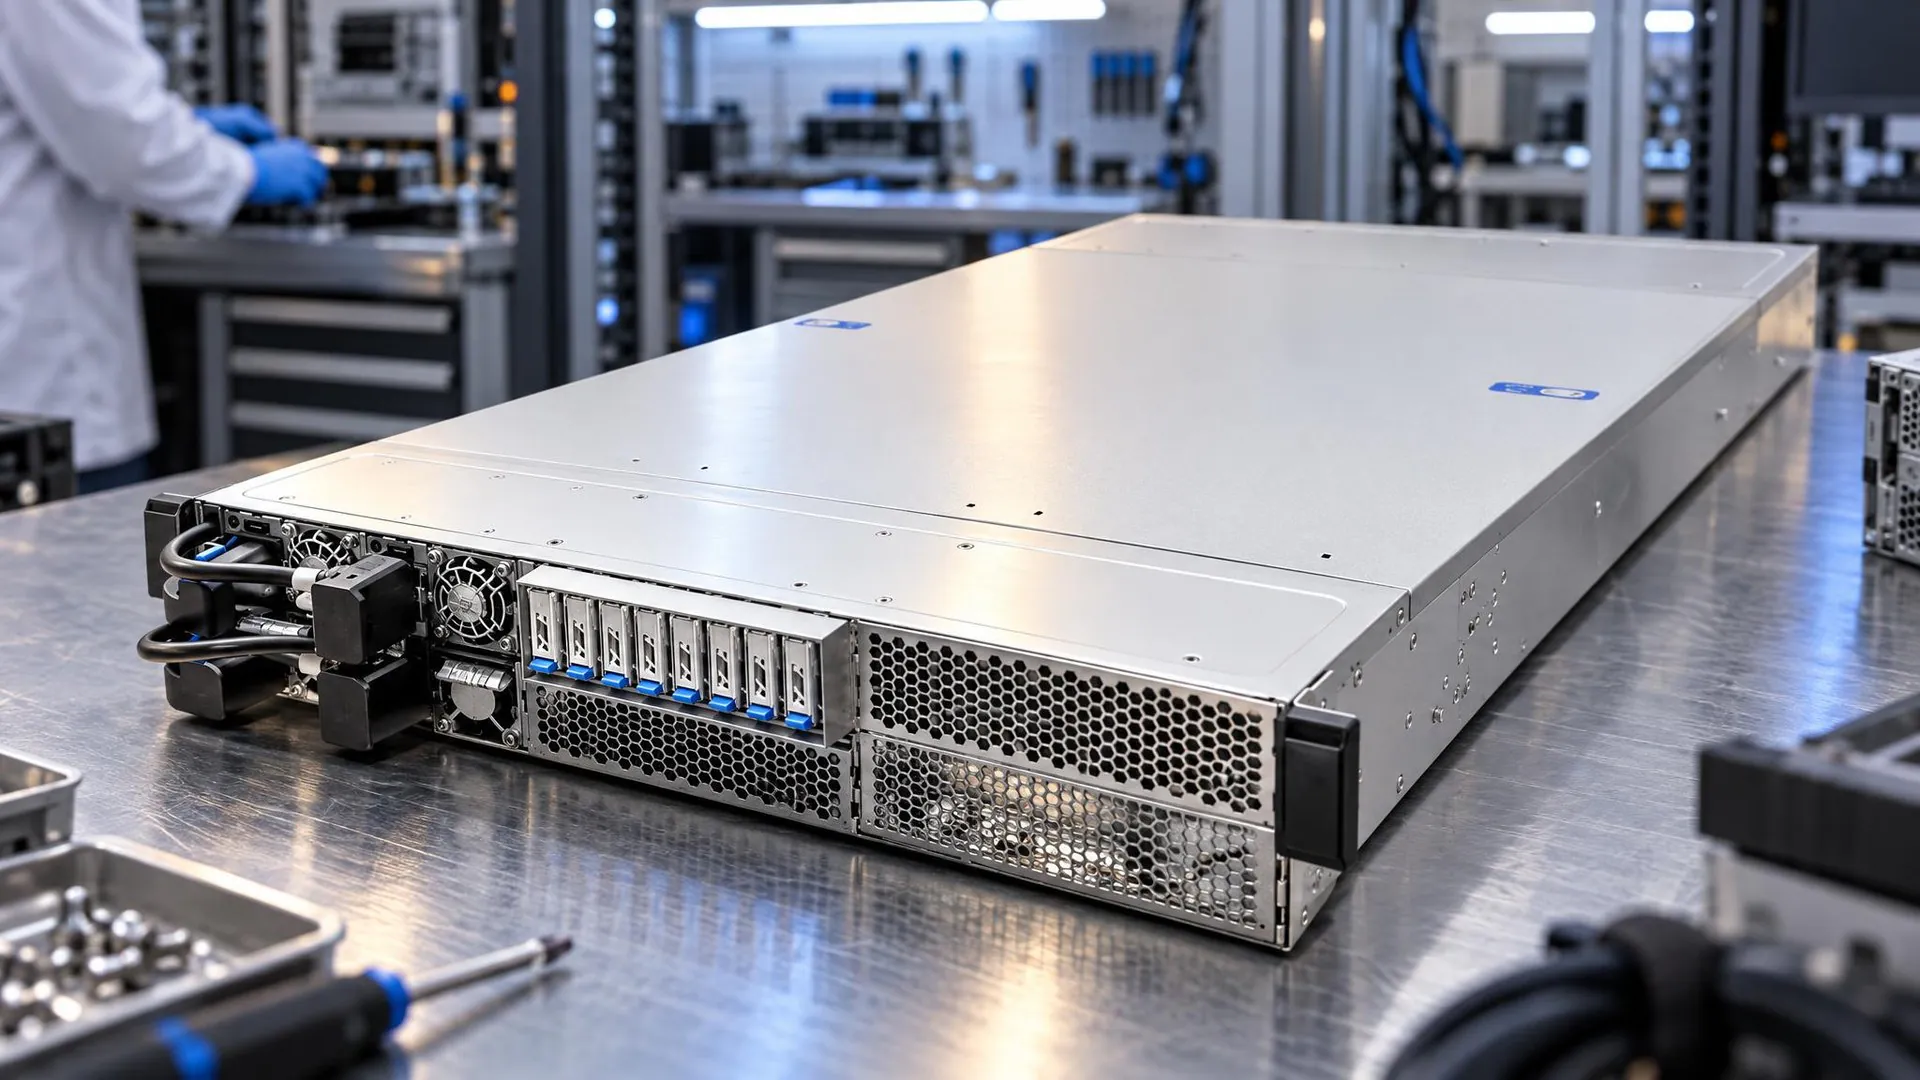
ASUSは2026年10月12日、カリフォルニア州サンノゼで開催されたOCP Global Summit 2026で、NVIDIA MGXアーキテクチャを採用し、デュアルNVIDIA Vera CPUを搭載した2Uサーバー「XA P2N-E2」を発表した。同社はプレスリリースで、本システムはエージェント型AIおよび強化学習のワークロード向けに設計されていると述べた。
プレスリリースによると、このサーバーはAIアプリケーションの実行レイヤーを担い、コード実行、ツール利用、サンドボックス化、データ処理、オーケストレーションなど、AIモデル自体にとどまらない処理に対応する。XA P2N-E2は、デュアルスロットのNVIDIA RTX PRO 6000 Blackwell Server Edition GPUを最大2基搭載でき、2UプラットフォームでCPU処理とGPUアクセラレーションを組み合わせる。ASUSによると、本システムのシングルスレッドCPU性能と、高帯域幅かつエネルギー効率に優れたメモリーは、負荷の高い実行タスクや評価タスク中もAIエージェントの応答性を維持することを目的としている。
空冷式2UシャーシにデュアルVeraプロセッサーを搭載
XA P2N-E2の製品ページには「NEW」と表示されており、NVIDIA Veraプロセッサーを2基搭載すると記載されている。各プロセッサーは、Spatial Multithreadingに対応した独自設計のOlympusコアを88基統合し、176スレッドを備える。ソケットあたりのTDPは最大480Wだ。ASUSはVeraを、AIエージェント向けに初めて専用設計されたCPUと説明している。同社が示すワークフローでは、CPUがサンドボックス内でのコード実行、ツール利用、オーケストレーション、データ処理を担い、GPUはトレーニングと推論に専念する。
第2世代NVIDIA NVLink-C2Cにより、CPU間のコヒーレント通信は最大1.8TB/s、コア間帯域幅は最大3.4TB/sに達すると製品ページに記載されている。メモリーには、LPDDR5Xを9600MT/sで動作させるSOCAMM2モジュールを16基使用し、容量は最大1.5TBとなる。ASUSによると、この構成は従来のRDIMMメモリーと比べて最大2倍のエネルギー効率を実現し、メモリー消費電力を50%削減する。
ストレージとして、ホットスワップ対応のE1.Sドライブベイを8基備える。拡張用としてPCIe Gen6 x16スロットを2基、専用のデュアルスロットDPU/NICスロットを1基搭載する。完全空冷式のシャーシは、プロセッサー、メモリー、GPUの各ゾーンを前面から背面へ通り抜けるエアフローを採用し、2+2の冗長構成による2000Wの80 PLUS Titanium電源ユニットを備える。液冷設備は不要だ。MGXのモジュラー設計により、ホストプロセッサーモジュールと、最大600WのデュアルスロットRTX PRO 6000 Blackwell Server Edition GPUを最大2基搭載できるGPUベイは、それぞれ個別に保守できる。
ASUSが指摘するエージェント型AIの4つのハードウェア上のボトルネック
2026年8月10日付の見解でASUSは、エージェント型AIの導入を制約すると同社が指摘する4つのハードウェア上のボトルネックを挙げた。大規模運用時のシングルスレッド性能不足、コアあたりのメモリー帯域幅不足、ダイ間のデータアクセス遅延、ハードウェアレベルのサンドボックス分離機能の欠如だ。同社によると、XA P2N-E2は、エージェントのコード実行に対応するハードウェアレベルのサンドボックス分離機能によって、最後の課題に対処する。またASUSは、Vera CPUについて、従来のx86 CPUの最大1.8倍のシングルスレッド性能、従来のx86インフラの1.8倍の速度でのサンドボックス内コード実行、最大1.5倍高速なコーディングワークフローを実現するとしている。ASUSは、これらの数値をVera CPUの88コア設計、最大1.2TB/sのLPDDR5Xメモリー帯域幅、3.4TB/sの内部インターコネクト帯域幅に結び付けて説明した。
この8月の見解では、XA P2N-E2は、AMD EPYC 9006プロセッサーを搭載するASUSサーバー、RS700A-E14B、RS720A-E14B、XA P8A-E14Aシリーズと同時に発表されたとすでに説明されていた。これらのシステムについてASUSは、ソケットあたり最大256コアを搭載し、前世代と比べて総合性能が約70%向上するとしている。また、16チャネルDDR5メモリーにより、約1.6TB/sの帯域幅を実現する。
ラックスケールシステムとNVIDIAプラットフォーム技術
ASUSは2Uサーバーに加え、OCPでラックスケールシステムも展示している。XA VR721-E3 ASUS AI PODは、NVIDIA Vera Rubin NVL72プラットフォームを通じて36基のNVIDIA Vera CPUと72基のNVIDIA Rubin GPUを統合し、大規模なAIトレーニング、ポストトレーニング、推論向けに完全液冷式のアーキテクチャを採用する。XR R1I12B-M1BHFSはNVIDIA HGX Rubin NVL8を採用し、GPUベースボードにはチップ直結型液冷を、Intel Xeon 6プロセッサーには空冷を組み合わせている。
ASUSは、NVIDIA DSXリファレンスデザインとNVIDIA Omniverse DSX Blueprintも紹介した。同社によると、これらは検証済みのアーキテクチャと高精度シミュレーションを組み合わせ、導入前にAIファクトリーの設計と運用を最適化するための、物理的に正確なデジタルツインの構築を可能にする。ASUSブースでは、NVIDIAの4つの技術を展示する。HGX Rubin NVL8アクセラレーテッドコンピューティング、Spectrum-6を基盤とするSpectrum-Xイーサネットスイッチング、CMX Context Memory Storage Platform、そしてVera Rubin NVL72向けのGroq 3 LPX推論アクセラレーターだ。プレスリリースによると、Groq 3 LPXは超高速なトークン生成によってNVL72プラットフォームを拡張し、高い応答性を備えた推論を実現する。
IntelおよびAMD搭載システムも展示
Intelの展示では、Intel Xeon 6プロセッサーを搭載した1Uおよび2Uのデュアルソケットサーバー、RS700-E12-RS4UとRS720-E12-RS12Uを紹介する。DC-MHS設計と工具不要の保守性を備え、エージェント型AI、仮想化、データ集約型ワークロードを対象とする。AMDの展示では、RS700A-E14B-R16Uを披露する。これは「Venice」のコードネームを持つ第6世代AMD EPYC 9006シリーズプロセッサーを搭載した1Uデュアルソケットシステムで、DC-MHSアーキテクチャとPCIe 6.0接続に対応し、E3.Sドライブを最大16基搭載できる。ASUS Thermal Radar 3.0により、温度の監視と管理も行える。
AI処理の高速化に向けて、ESC8000A-E13PはAMD Instinct MI350P PCIeアクセラレーターに対応しています。一方、XA AM3A-E13は、ASUSによると、専用の冷水設備を必要とせず高密度導入を可能にする、空冷設計の10UシステムにAMD Instinct MI355Xアクセラレーターを8基搭載しています。製品ラインアップ全体は、OCP Global Summit 2026の開催期間中、ASUSブース#B9で展示されています。またASUSによると、サーバーは世界各地で販売されており、個々の製品や構成の提供状況は地域によって異なります。


