
Andersonの視点
Adobe Researchが分離されたGANの顔編集を拡張する

 Unite.AI を Google の優先ソースに追加
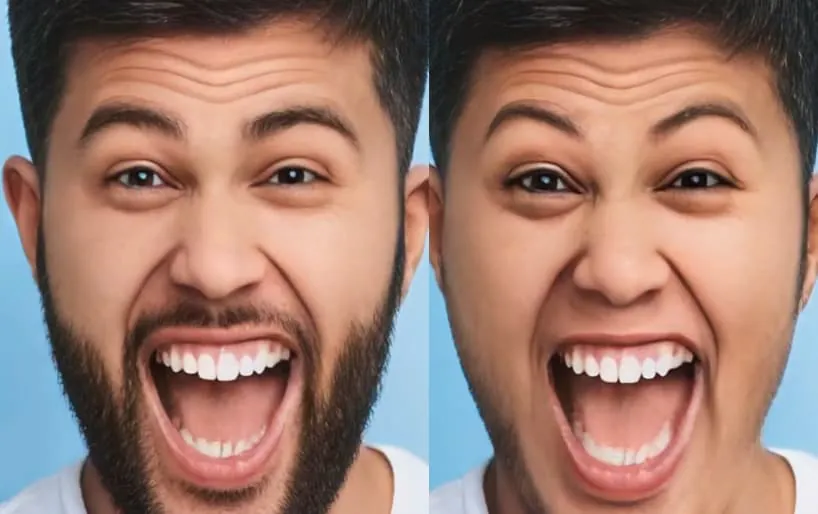
要点Adobeの潜在空間間マッパーは、再学習なしで35の顔属性を編集しながらアイデンティティを固定する。
もっと見る
- Adobeの潜在空間間マッパーは、再学習なしで35の顔属性を編集しながらアイデンティティを固定する。
- このシステムは、属性変換中のアイデンティティ劣化を防ぐために、FaceNetを識別器として使用する。
- InterFaceGANのような競合フレームワークは年齢と性別や眼鏡を絡めてしまうが、Adobeの手法はこれらの副作用を回避する。
画像合成における特徴のもつれ(エンタングルメント)が問題となる理由は、他の分野でも同様の問題が生じることが多いため、理解するのは難しくない。例えば、カレーからターメリックを取り除くのは、ハンバーガーからピクルスを取り出すよりも難しい。また、コーヒーに溶けた砂糖を取り除くことはほぼ不可能である。いくつかのものはバンドルされてくる。
同様に、エンタングルメントは、機械学習を使用して顔(または犬、船、その他の対象)を作成または編集するときに、さまざまな機能や概念を分離することを望む画像合成アーキテクチャにとっての障害である。
年齢、性別、髪の色、肌の色、感情などを分離できれば、顔画像を細部まで自在に生成・編集できる、実用的で柔軟なフレームワークの基礎ができあがる。不要な「乗客」を変換に引きずり込まないで済む。

最大のエンタングルメント(上の左)では、学習したGANネットワークの画像を別の人の画像に変更することしかできない。
これは、30年以上前に他の手段で解決された問題に対して、最新のAIコンピュータビジョンテクノロジーを使用して何かを実現しようとしているに過ぎない。
ある程度の分離(上の画像の「Medium Separation」)がある場合、髪の色、表情、化粧、限られた範囲での頭の回転などのスタイルベースの変更を行うことができる。

Source: FEAT: Face Editing with Attention, 2022年2月, https://arxiv.org/pdf/2202.02713.pdf
過去2年間で、ユーザーがスライダーなどの従来のUIインタラクションを使用して追加や変更を加えても対象の顔の基本的特徴を保ちながら、顔の特徴を変更できるインタラクティブな顔編集環境を作成する試みが何度かありました。しかし、これはGANの潜在空間における基本的な機能/スタイルエンタングルメントのため、課題となりました。
例えば、メガネの特性は、年齢の特性としばしば絡み合っています。つまり、メガネを追加すると顔が「年をとる」可能性があり、顔が「年をとる」場合はメガネが追加される可能性があり、高レベルの特徴の分離の程度によっては、どちらかまたは両方が発生する可能性があります(以下の「テスト」で説明します)。
特に、髪の色やその他の特徴を変える際に、髪の毛の形や配置まで再計算されることを避けるのは、ほぼ不可能でした。そのため、変換中に髪が細かく揺らぐような効果が生じます。

Source: InterFaceGAN Demo (CVPR 2020), https://www.youtube.com/watch?v=uoftpl3Bj6w
潜在コード間のGANトラバーサル
WACV 2022に提出されたAdobe (ADBE ) 主導の新しい論文は、これらの根本的な問題に対して新しいアプローチを提供します。この論文は、Latent to Latent: A Learned Mapper for Identity Preserving Editing of Multiple Face Attributes in StyleGAN-generated Imagesと題されています。
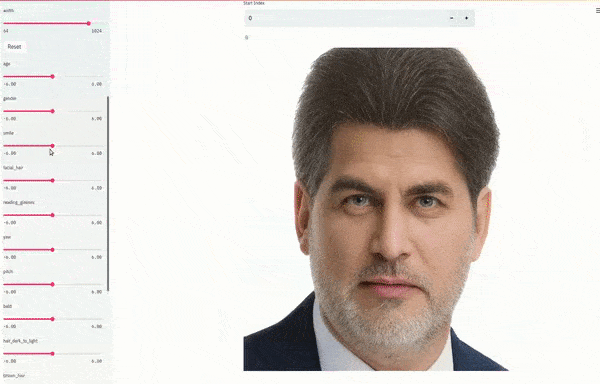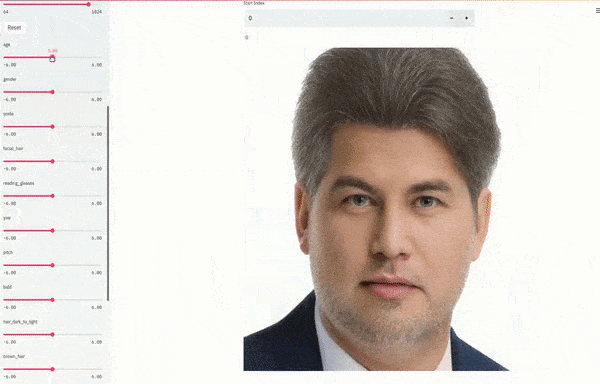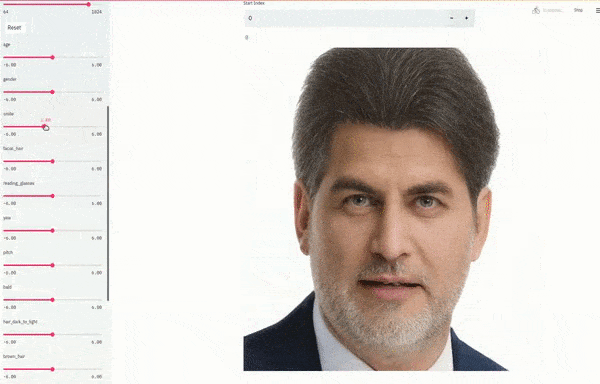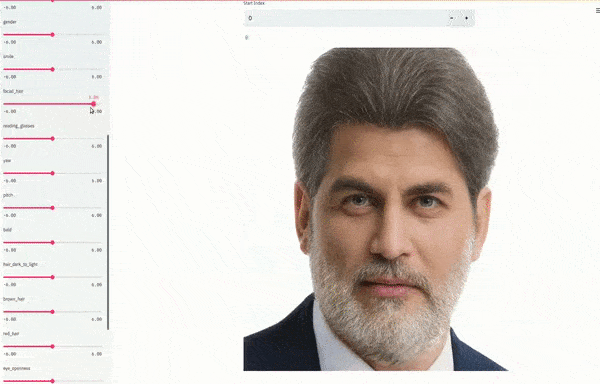
次の論文の補足資料: Latent to Latent: A Learned Mapper for Identity Preserving Editing of Multiple Face Attributes in StyleGAN-generated Images。学習された顔の基本的な特徴が、関係のない変更に巻き込まれていないことがわかる。細部を高解像度で確認するには、記事末尾に埋め込まれた完全な動画を参照。 出典:https://www.youtube.com/watch?v=rf_61llRH0Q
この論文は、Adobeの応用科学者Siavash Khodadadehが主導し、他の4人のAdobe研究者とセントラルフロリダ大学のコンピュータサイエンス学部の研究者が参加しています。
この論文は、Adobeがこの分野で長期間活動していること、またこの機能が将来のCreative Suiteプロジェクトに搭載される可能性があることから興味深いものです。ただし、主な理由は、このプロジェクトのアーキテクチャが、GAN顔編集器で変更を適用しながら視覚的な完全性を維持するための新しいアプローチを採用していることです。
著者は以下のように述べています。
‘[私たちは]、属性の変更に対応する潜在コードを見つけるために、潜在的な変換を実行するためのニューラルネットワークを訓練します。 この手法は1回の変換で処理するため、属性を徐々に変える線形または非線形の軌道には依存しません。 ‘
‘生成パイプライン全体でネットワークをエンドツーエンドで訓練することで、システムはオフザシェルフのジェネレータアーキテクチャの潜在空間に対応できるようになります。 同一性の保存などの保存特性は、訓練損失の形式でエンコードできます。 ‘
‘潜在コード間変換ネットワークが訓練されると、任意の画像に対して再訓練せずに再利用できます。 ‘
この最後の部分は、提案されたアーキテクチャが、エンドユーザーに完成した状態で到着することを意味します。ローカルリソースでニューラルネットワークを実行する必要がありますが、新しい画像を「ドロップイン」してすぐに変更できるため、画像ごとの追加の訓練は必要ありません。フレームワークは十分に切り離されており、さらに画像固有の訓練は必要ありません。
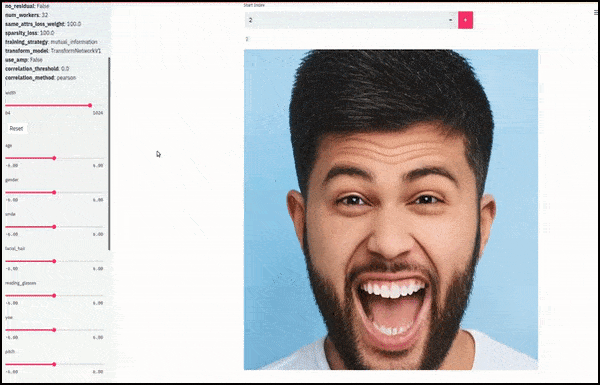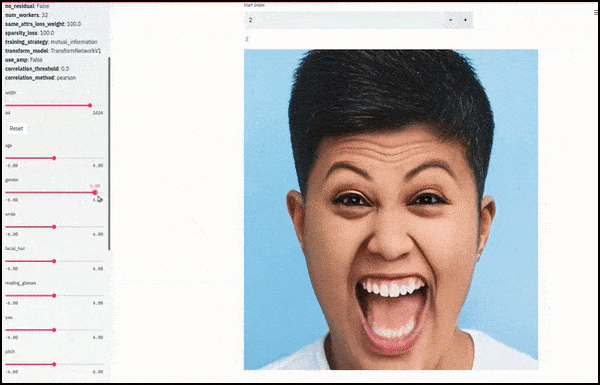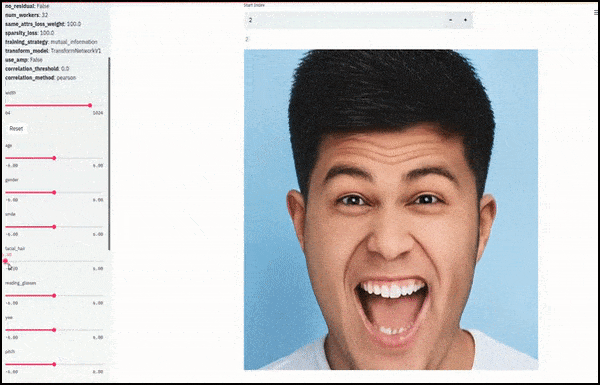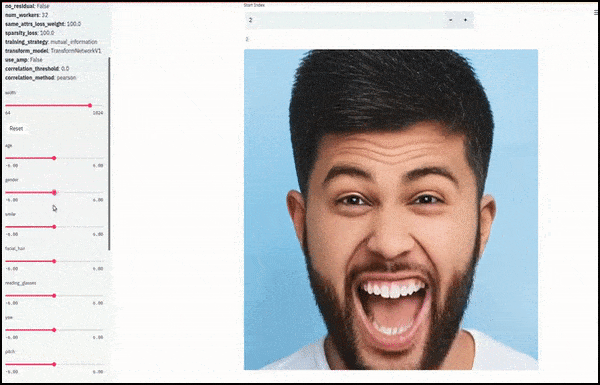
スライダーが潜在空間内でランダムかつ任意の経路を描くと、性別や顔の毛が変化する。単に両端の間を行き来するだけではない。より多くの変換例を高解像度で見るには記事末尾の動画を参照。
この研究の主な成果の1つは、ネットワークが潜在空間でアイデンティティを「凍結」する能力であり、ターゲットベクトルで属性のみを変更し、変換されるアイデンティティを保存する「修正項」を提供することです。
本質的に、提案されたネットワークは、処理された要素をオーケストレートするより広いアーキテクチャに組み込まれており、凍結された重みを持つ事前トレーニングコンポーネントを通過します。これにより、変換に望ましくない横方向的な影響が生じることはありません。
訓練プロセスは、三つ組に依存します。三つ組は、シード画像(GAN逆変換の下で)または既存の初期潜在コードによって生成できるため、訓練プロセス全体は教師なし学習です。通常のシステムにあるようなラベリングやキュレーションシステムの通常の範囲の暗黙のアクションは、実際にはアーキテクチャに組み込まれています。実際、新しいシステムは既存の属性回帰モデルを使用します。
‘[私たちの]ネットワークが独立して制御できる属性の数は、認識器の能力のみによって制限されます。認識器があれば、任意の顔に属性を追加できます。私たちの実験では、35個の異なる顔の属性の調整を可能にするように潜在コード間変換ネットワークを訓練しました。これは、以前のアプローチよりも多くの属性です。 ‘
システムには、望ましくない「副作用」変換に対する追加の安全対策が組み込まれています。属性の変更を要求されない場合、潜在コード間変換ネットワークは潜在ベクトルを自分自身にマッピングし、ターゲットアイデンティティの安定した永続性をさらに高めます。
顔認識
過去数年間のGANおよびエンコーダ/デコーダベースの顔編集器の再発する問題の1つは、適用された変換が類似性を低下させる傾向があることです。これに対処するために、Adobeの研究ではFaceNetという顔認識ネットワークを判別器として組み込んでいます。

プロジェクトのアーキテクチャ。FaceNetは図の下部中央より左に組み込まれている。 出典:Latent to Latent: A Learned Mapper for Identity Preserving Editing of Multiple Face Attributes in StyleGAN-generated Images, OpenAccess.
(個人的には、これは標準的な顔の識別、さらには表情認識システムを生成ネットワークに統合する、心強い一歩だと感じます。現在のディープフェイクでは、盲目的なピクセル間マッピングが主流で、表情の忠実さや顔生成の他の重要な側面が犠牲になっています。こうした統合は、その問題を克服する最善の方向かもしれません。)
潜在空間ですべての領域にアクセス
このフレームワークのもう1つの印象的な機能は、潜在空間内の潜在的な変換間を、ユーザーの任意のタイミングで移動できることです。以前のいくつかのシステムは、ユーザーが潜在的な変換の固定されたタイムライン間で「行き来」することしかできませんでしたが、印象的ではありましたが、しばしば線形または規定されたエクスペリエンスでした。
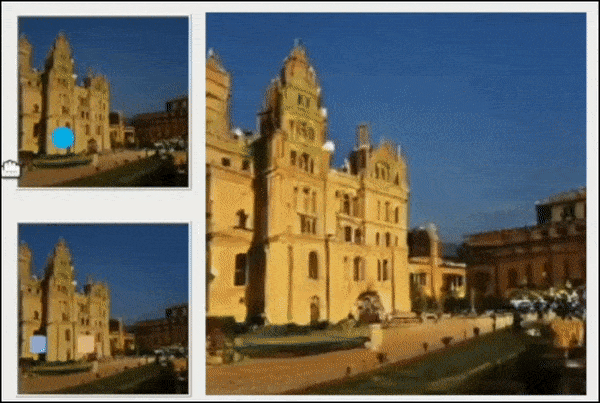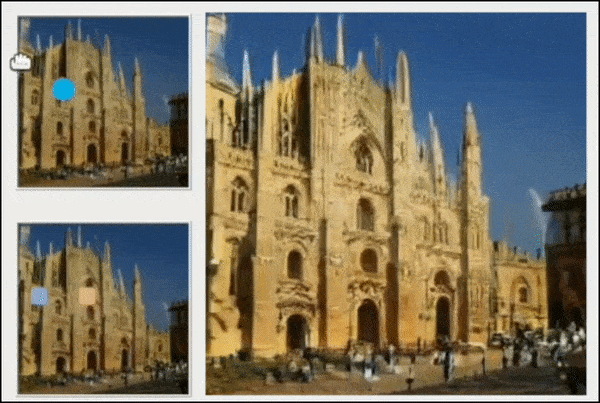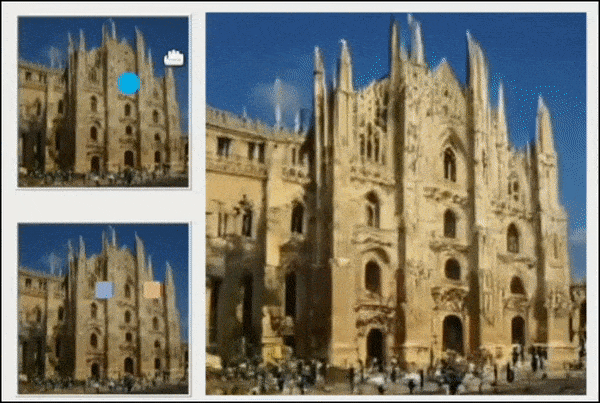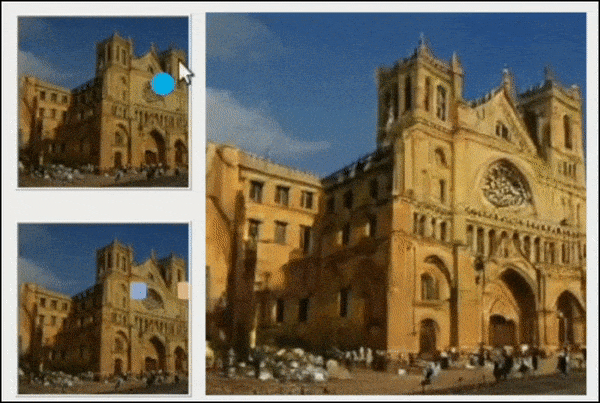
次の研究より: Improving GAN Equilibrium by Raising Spatial Awareness。ユーザーは潜在空間内の2つの位置の間にある複数の遷移候補を行き来するが、事前に学習された位置の範囲に制限される。同じ素材に別の種類の変換を適用するには、再設定や再訓練が必要となる。 出典:https://genforce.github.io/eqgan/
フレームワークがユーザーのまったく新しい画像を受け入れられることに加えて、ユーザーは変換プロセス中に保存したい要素を手動で「凍結」できます。たとえば、ユーザーは背景が移動しないことを確認したり、目を開けたままにしたり、閉じたままにしたりすることができます。
データ
属性回帰ネットワークは、3つのデータセットで訓練されました: FFHQ、CelebAMask-HQ、およびStyleGAN-V2のZ空間から400,000個のベクトルをサンプリングし、GANでローカルに生成したデータセット。
分布外の画像は除外され、MicrosoftのFace APIを使用して属性が抽出され、結果の画像セットは90/10で分割され、721,218個の訓練画像と72,172個のテスト画像が比較のために残されました。
テスト
実験ネットワークは当初、35個の潜在的な変換を処理するように構成されていましたが、比較可能なフレームワークであるInterFaceGAN、GANSpace、およびStyleFlowに対するテストを行うために、8個に絞り込まれました。
選択された8つの属性は、年齢、禿、ひげ、表情、性別、メガネ、ピッチ、およびヨーでした。元の配布で提供されていなかった属性(たとえば、InterFaceGANに禿とひげを追加する)に対して、競合するフレームワークを再構成する必要がありました。
予想通り、競合するアーキテクチャでは、より高いレベルのエンタングルメントが発生しました。たとえば、1つのテストでは、InterFaceGANとStyleFlowの両方が、年齢を適用したときに、サブジェクトの性別を変更しました。

2つの競合フレームワークは、年齢の変換に性別の変更を組み込み、ユーザーの直接の要請なしに髪の色も変更しました。
さらに、2つのライバルは、メガネと年齢が切り離せない特徴であることを発見しました。

メガネと髪の色の変更が無料で付いてきます!
研究は一様に勝利しているわけではありません。記事の最後に埋め込まれたビデオを参照すると、フレームワークは、さまざまな角度(ヨー)を外挿する際に最も効果が低いことがわかりますが、GANSpaceは年齢とメガネの追加に対してより優れた一般的な結果を示しています。潜在コード間変換フレームワークは、頭の角度(ピッチ)の追加については、GANSpaceとStyleFlowと同等でした。

MTCNN顔検出器の校正に基づいて計算された結果。値が低いほどよい。
詳細や例の解像度の向上については、以下の記事の末尾に埋め込まれたビデオを参照してください。
最初に公開されたのは2022年2月16日です。





