
AGI e IA del futuro
Potere dei Rerankers e del Retrieval a Due Stadi per la Generazione Migliorata con Retrieval

 Aggiungi Unite.AI alle tue fonti preferite su Google

Punti chiaveLa ricerca a due stadi con modelli di reranking migliora drasticamente l'accuratezza…
Vedi di più
- La ricerca a due stadi con modelli di reranking migliora drasticamente l'accuratezza del RAG recuperando prima molti documenti e poi riordinandoli con un modello più intelligente.
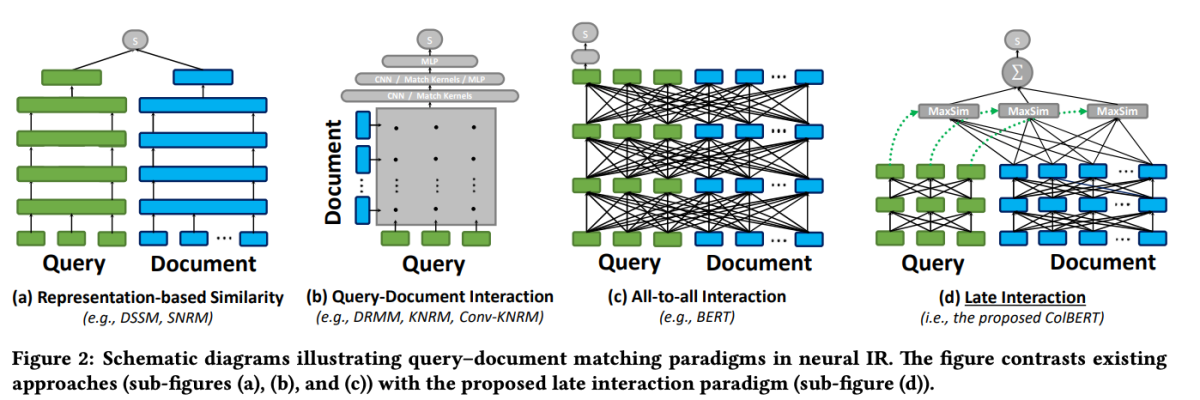
- Il meccanismo di interazione tardiva di ColBERT consente una ricerca semantica efficiente elaborando separatamente query e documenti fino al confronto finale.
- I modelli di reranking possono essere addestrati su dati specifici di dominio per risolvere i problemi di dominio esterno comuni nei modelli di embedding generici.

Questo snippet di codice dimostra come configurare e utilizzare il modello jina-colbert-v1-en per l’indicizzazione di una raccolta di documenti, sfruttando la sua capacità di gestire contesti lunghi in modo efficiente.
Implementazione del Recupero a Due Stadi con Rerankers
Ora che abbiamo compreso i principi alla base del recupero a due stadi e dei rerankers, esploriamo la loro implementazione pratica all’interno di un sistema RAG. Sfrutteremo librerie e framework popolari per dimostrare l’integrazione di queste tecniche.
Configurazione dell’Ambiente
Prima di addentrarci nel codice, configuriamo il nostro ambiente di sviluppo. Utilizzeremo Python e diverse librerie NLP popolari, tra cui Hugging Face Transformers, Sentence Transformers e LanceDB.
# Installa le librerie richieste
!pip install datasets huggingface_hub sentence_transformers lancedb
Preparazione dei Dati
Per scopi dimostrativi, utilizzeremo il set di dati “ai-arxiv-chunked” da Hugging Face Datasets, che contiene oltre 400 articoli di ArXiv su apprendimento automatico, elaborazione del linguaggio naturale e grandi modelli linguistici.
from datasets import load_dataset <p>dataset = load_dataset("jamescalam/ai-arxiv-chunked", split="train")</p> &lt;pre&gt;
Successivamente, elaboreremo i dati e li divideremo in chunk più piccoli per facilitare il recupero e l’elaborazione efficienti.
from transformers import AutoTokenizer <p>tokenizer = AutoTokenizer.from_pretrained("bert-base-uncased")</p> <p>def chunk_text(text, chunk_size=512, overlap=64): tokens = tokenizer.encode(text, return_tensors="pt", truncation=True) chunks = tokens.split(chunk_size - overlap) texts = [tokenizer.decode(chunk) for chunk in chunks] return texts</p> <p>chunked_data = [] for doc in dataset: text = doc["chunk"] chunked_texts = chunk_text(text) chunked_data.extend(chunked_texts)</p>
Per la fase di recupero iniziale, utilizzeremo un modello Sentence Transformer per codificare i nostri documenti e query in rappresentazioni vettoriali dense, e poi eseguiremo una ricerca di vicini più prossimi approssimata utilizzando un database vettoriale come LanceDB.
from sentence_transformers import SentenceTransformer from lancedb import lancedb <p># Carica modello Sentence Transformer model = SentenceTransformer('all-MiniLM-L6-v2')</p> <p># Crea archivio vettoriale LanceDB db = lancedb.lancedb('/path/to/store') db.create_collection('docs', vector_dimension=model.get_sentence_embedding_dimension())</p> <p># Indicizza documenti for text in chunked_data: vector = model.encode(text).tolist() db.insert_document('docs', vector, text)</p> <p>from sentence_transformers import SentenceTransformer from lancedb import lancedb</p> <p># Carica modello Sentence Transformer model = SentenceTransformer('all-MiniLM-L6-v2')</p> <p># Crea archivio vettoriale LanceDB db = lancedb.lancedb('/path/to/store') db.create_collection('docs', vector_dimension=model.get_sentence_embedding_dimension())</p> <p># Indicizza documenti for text in chunked_data: vector = model.encode(text).tolist() db.insert_document('docs', vector, text)
Con i documenti indicizzati, possiamo eseguire il recupero iniziale trovando i vicini più prossimi al vettore della query.
from transformers import AutoTokenizer <p>tokenizer = AutoTokenizer.from_pretrained("bert-base-uncased")</p> <p>def chunk_text(text, chunk_size=512, overlap=64): tokens = tokenizer.encode(text, return_tensors="pt", truncation=True) chunks = tokens.split(chunk_size - overlap) texts = [tokenizer.decode(chunk) for chunk in chunks] return texts</p> <p>chunked_data = [] for doc in dataset: text = doc["chunk"] chunked_texts = chunk_text(text) chunked_data.extend(chunked_texts)
Reranking
Dopo il recupero iniziale, impiegheremo un modello di reranking per riordinare i documenti recuperati in base alla loro rilevanza per la query. In questo esempio, utilizzeremo il reranker ColBERT, un modello trasformazionale veloce e preciso progettato specificamente per la classificazione di documenti.
from lancedb.rerankers import ColbertReranker

reranker = ColbertReranker()

<p># Reranking dei documenti iniziali
reranked_docs = reranker.rerank(query, initial_docs)
La lista reranked_docs contiene ora i documenti riordinati in base alla loro rilevanza per la query, come determinato dal reranker ColBERT.
Miglioramento e Generazione
Con i documenti riordinati e rilevanti a disposizione, possiamo procedere alle fasi di miglioramento e generazione della pipeline RAG. Utilizzeremo un modello linguistico dalla libreria Hugging Face Transformers per generare la risposta finale.
from transformers import AutoTokenizer, AutoModelForSeq2SeqLM <p>tokenizer = AutoTokenizer.from_pretrained("t5-base") model = AutoModelForSeq2SeqLM.from_pretrained("t5-base")</p> <p># Miglioramento della query con documenti riordinati augmented_query = query + " " + " ".join(reranked_docs[:3])</p> <p># Generazione della risposta dal modello linguistico input_ids = tokenizer.encode(augmented_query, return_tensors="pt") output_ids = model.generate(input_ids, max_length=500) response = tokenizer.decode(output_ids[0], skip_special_tokens=True)</p> print(response)


