
Angolo di Anderson
Come Stable Diffusion potrebbe diventare un prodotto per il grande pubblico

 Aggiungi Unite.AI alle tue fonti preferite su Google
Ironia della sorte, Stable Diffusion, il nuovo framework di sintesi di immagini AI che ha fatto scalpore nel mondo, non è né stabile né realmente “diffuso” – almeno, non ancora.
La gamma completa delle capacità del sistema è distribuita su una varietà di offerte in continua mutazione da parte di un pugno di sviluppatori che scambiano febbrilmente le ultime informazioni e teorie in diversi colloqui su Discord – e la maggior parte delle procedure di installazione per i pacchetti che stanno creando o modificando sono molto lontane dall’essere “plug and play”.
Piuttosto, tendono a richiedere un’installazione tramite linea di comando o BAT tramite GIT, Conda, Python, Miniconda e altri framework di sviluppo all’avanguardia – pacchetti software così rari tra i consumatori generici che la loro installazione è spesso segnalata dai vendor di antivirus e anti-malware come prova di un sistema compromesso.

Solo una piccola selezione degli ostacoli che l’installazione standard di Stable Diffusion richiede oggi. Molte distribuzioni richiedono anche versioni specifiche di Python, che possono entrare in conflitto con quelle già installate sul computer. Il problema si può evitare con installazioni basate su Docker e, in parte, con gli ambienti Conda.
I thread di messaggio in entrambe le comunità SFW e NSFW di Stable Diffusion sono inondati di suggerimenti e trucchi relativi all’hacking di script Python e installazioni standard, al fine di abilitare una funzionalità migliorata o risolvere errori di dipendenza frequenti e una serie di altri problemi.
Ciò lascia il consumatore medio, interessato a creare immagini incredibili da prompt di testo, praticamente alla mercé del crescente numero di interfacce web API monetizzate, la maggior parte delle quali offre un numero limitato di generazioni di immagini gratuite prima di richiedere l’acquisto di token.
Inoltre, quasi tutte queste offerte web rifiutano di generare il contenuto NSFW (molto del quale può essere relativo a soggetti non pornografici di interesse generale, come “guerra”) che distingue Stable Diffusion dai servizi censurati di OpenAI DALL-E 2.
‘Photoshop per Stable Diffusion’
Attratto dalle immagini fantastiche, audaci o ultraterrene che popolano ogni giorno l’hashtag #stablediffusion su Twitter, il grande pubblico probabilmente attende ‘Photoshop per Stable Diffusion’ – un’applicazione installabile cross-platform che incorpora la migliore e più potente funzionalità dell’architettura di Stability.ai, nonché le varie innovazioni ingegnose della comunità di sviluppo di SD emergente, senza finestre CLI galleggianti, routine di installazione e aggiornamento oscure e in continua evoluzione, o funzionalità mancanti.
Ciò che attualmente abbiamo, nella maggior parte delle installazioni più capaci, è una pagina web variamente elegante affiancata da una finestra separata della riga di comando, e il cui URL è una porta localhost:

Come le applicazioni di sintesi guidate da CLI, quali FaceSwap e DeepFaceLab basato su BAT, l’installazione preconfezionata di Stable Diffusion mostra le proprie radici nella riga di comando. L’interfaccia si apre tramite una porta localhost, visibile in alto nell’immagine, che comunica con le funzioni CLI di Stable Diffusion.
Senza dubbio, un’applicazione più fluida sta arrivando. Già ci sono diverse applicazioni integrali basate su Patreon che possono essere scaricate, come GRisk e NMKD (vedi immagine sotto) – ma nessuna che, al momento, integri la gamma completa di funzionalità che alcune delle implementazioni più avanzate e meno accessibili di Stable Diffusion possono offrire.

Primi pacchetti di Stable Diffusion basati su Patreon, trasformati leggermente in applicazioni. NMKD è il primo a integrare l’output CLI direttamente nella GUI.
Vediamo cosa potrebbe assomigliare un’implementazione più raffinata e integrale di questa meraviglia open source – e quali sfide potrebbe affrontare.
Considerazioni legali per un’applicazione commerciale Stable Diffusion completamente finanziata
Il fattore NSFW
Il codice sorgente di Stable Diffusion è stato rilasciato sotto una licenza estremamente permissiva che non proibisce implementazioni commerciali e opere derivate che si basano ampiamente sul codice sorgente.
Oltre alle già menzionate e crescenti numerose build di Stable Diffusion basate su Patreon, nonché al gran numero di plugin di applicazioni in fase di sviluppo per Figma, Krita, Photoshop, GIMP e Blender (tra gli altri), non c’è ragione pratica per cui una casa di sviluppo software ben finanziata non potrebbe sviluppare un’applicazione Stable Diffusion molto più sofisticata e capace. Da una prospettiva di mercato, c’è ogni ragione per credere che diverse di queste iniziative siano già in corso.
Qui, tali sforzi affrontano immediatamente il dilemma di decidere se l’applicazione permetterà o meno al filtro NSFW nativo di Stable Diffusion (un frammento di codice) di essere disattivato.
‘Seppellire’ l’interruttore NSFW
Sebbene la licenza open source di Stability.ai per Stable Diffusion includa un elenco ampiamente interpretabile di applicazioni per le quali non può essere utilizzato (argomentando, tra l’altro, contenuti pornografici e deepfake), l’unico modo in cui un fornitore potrebbe effettivamente proibire un tale uso sarebbe quello di compilare il filtro NSFW in un eseguibile opaco invece di un parametro in un file Python, o di applicare un confronto di checksum sul file Python o DLL che contiene la direttiva NSFW, in modo che i rendering non possano verificarsi se gli utenti modificano questa impostazione.
Ciò lascerebbe l’applicazione putativa “evirata” in modo molto simile a come DALL-E 2 attualmente è, diminuendo il suo appeal commerciale. Inoltre, inevitabilmente, versioni decompilate e manomesse di questi componenti (elementi di runtime Python originali o file DLL compilati, come quelli attualmente utilizzati nella linea di strumenti di miglioramento delle immagini AI di Topaz) emergerebbero probabilmente nella comunità di torrent/hacking per annullare tali restrizioni, semplicemente sostituendo gli elementi che impongono il blocco e annullando qualsiasi requisito di checksum.
Alla fine, il fornitore potrebbe scegliere di semplicemente ripetere l’avvertimento di Stability.ai contro l’uso improprio che caratterizza la prima esecuzione di molte distribuzioni di Stable Diffusion attuali.
Tuttavia, gli sviluppatori open source di piccole dimensioni che attualmente utilizzano dichiarazioni di non responsabilità in questo modo hanno poco da perdere in confronto a una società di software che ha investito quantità significative di tempo e denaro nel rendere Stable Diffusion completo e accessibile – il che invita a una considerazione più profonda.
Responsabilità per i deepfake
Come abbiamo recentemente notato, il database LAION-aesthetics, parte dei 4,2 miliardi di immagini su cui i modelli di Stable Diffusion sono stati addestrati, contiene un gran numero di immagini di celebrità, consentendo agli utenti di creare efficacemente deepfake, inclusi deepfake di celebrità pornografici.

Dal nostro recente articolo: quattro fasi di Jennifer Connelly lungo quattro decenni della sua carriera, ricostruite da Stable Diffusion.
Questo è un problema separato e più controverso della generazione di (solitamente) “pornografia astratta” legale, che non ritrae “persone reali” (sebbene tali immagini siano inferite da molte foto reali nel materiale di addestramento).
Dal momento che un numero crescente di stati e paesi sta sviluppando o ha istituito leggi contro la pornografia deepfake, la capacità di Stable Diffusion di creare pornografia di celebrità potrebbe significare che un’applicazione commerciale che non è completamente censurata (ossia che può creare materiale pornografico) potrebbe ancora avere bisogno di una certa capacità di filtrare i volti delle celebrità.
Un metodo potrebbe essere quello di fornire un elenco nero di termini che non saranno accettati in un prompt dell’utente, relativi a nomi di celebrità e a personaggi fittizi con cui potrebbero essere associati. Presumibilmente, tali impostazioni dovrebbero essere istituite in più lingue oltre all’inglese, poiché i dati di origine presentano altre lingue. Un altro approccio potrebbe essere quello di incorporare sistemi di riconoscimento delle celebrità come quelli sviluppati da Clarifai.
Potrebbe essere necessario per i produttori di software incorporare tali metodi, forse inizialmente disattivati, come potrebbe aiutare a prevenire che un’applicazione autonoma di Stable Diffusion generi volti di celebrità, in attesa di nuove leggi che potrebbero rendere tale funzionalità illegale.
Ancora una volta, tuttavia, tale funzionalità potrebbe inevitabilmente essere decompilata e ribaltata da soggetti interessati; tuttavia, il produttore di software potrebbe, in tale eventualità, affermare che si tratta di un atto di vandalismo non autorizzato – a condizione che tale reverse engineering non sia reso eccessivamente facile.
Funzionalità che potrebbero essere incluse
La funzionalità di base in qualsiasi distribuzione di Stable Diffusion sarebbe attesa da qualsiasi applicazione commerciale ben finanziata. Queste includono la capacità di utilizzare prompt di testo per generare immagini appropriate (testo-immagine); la capacità di utilizzare schizzi o altre immagini come linee guida per nuove immagini generate (immagine-immagine); i mezzi per regolare quanto “immaginativo” il sistema debba essere istruito a essere; un modo per scambiare il tempo di rendering con la qualità; e altre “funzionalità di base”, come l’archiviazione automatica facoltativa di immagini e prompt e l’aumento di risoluzione facoltativo tramite RealESRGAN, e almeno una correzione di base del viso con GFPGAN o CodeFormer.
Questo è un “installazione base abbastanza standard”. Vediamo alcune delle funzionalità più avanzate attualmente in fase di sviluppo o estensione, che potrebbero essere incorporate in un’applicazione Stable Diffusion completa e tradizionale.
Congelamento stocastico
Anche se si riutilizza un seed da un rendering precedente di successo, è terribilmente difficile ottenere che Stable Diffusion ripeta con precisione una trasformazione se qualsiasi parte del prompt o dell’immagine di origine (o entrambi) viene modificata per un rendering successivo.
Questo è un problema se si desidera utilizzare EbSynth per imporre le trasformazioni di Stable Diffusion su un video reale in modo temporalmente coerente – sebbene la tecnica possa essere molto efficace per semplici riprese di teste e spalle:
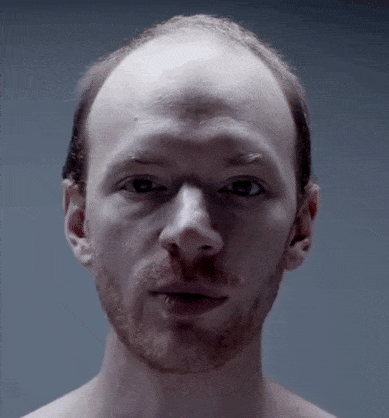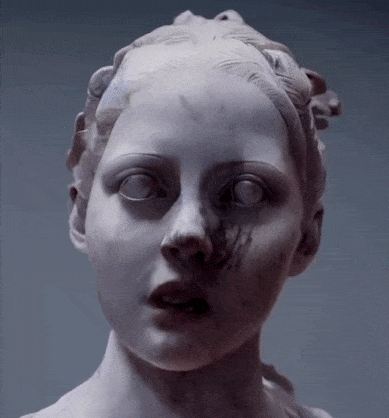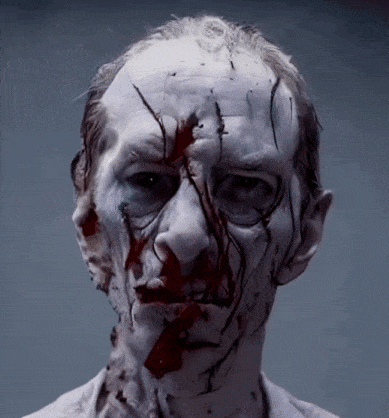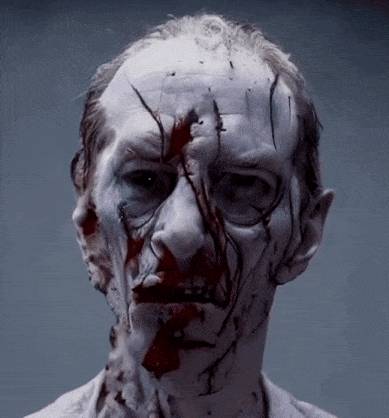
Un movimento limitato può rendere EbSynth uno strumento efficace per trasformare le elaborazioni di Stable Diffusion in video realistici. Fonte: https://streamable.com/u0pgzd
EbSynth funziona estendendo una piccola selezione di “frame alterati” in un video che è stato renderizzato in una serie di file di immagini (e che può successivamente essere ri-assemblato in un video).

In questo esempio dal sito di EbSynth, pochi fotogrammi di un video sono stati dipinti artisticamente. EbSynth li usa come guide stilistiche per modificare l’intero video in modo che corrisponda allo stile dipinto. Fonte: https://www.youtube.com/embed/eghGQtQhY38
Nell’esempio seguente, che presenta quasi nessun movimento dalla (reale) istruttrice di yoga bionda a sinistra, Stable Diffusion ha ancora difficoltà a mantenere una faccia coerente, perché i tre frame che vengono trasformati come “frame chiave” non sono completamente identici, anche se condividono lo stesso seed numerico.

Anche usando lo stesso prompt e seed nelle tre trasformazioni e con pochissime differenze tra i fotogrammi originali, i muscoli cambiano dimensione e forma. Soprattutto, il viso è incoerente e ostacola la continuità temporale di un eventuale rendering EbSynth.
Sebbene il video SD/EbSynth seguente sia molto inventivo, dove le dita dell’utente sono state trasformate in (rispettivamente) un paio di gambe di pantaloni che camminano e un’anatra, l’incoerenza dei pantaloni tipifica il problema che Stable Diffusion ha nel mantenere la coerenza tra diversi frame chiave, anche quando i frame di origine sono simili tra loro e il seed è coerente.
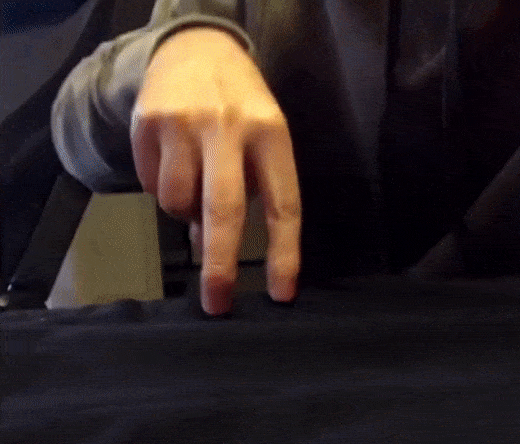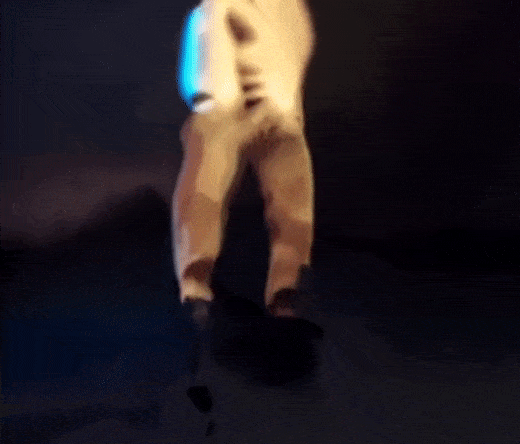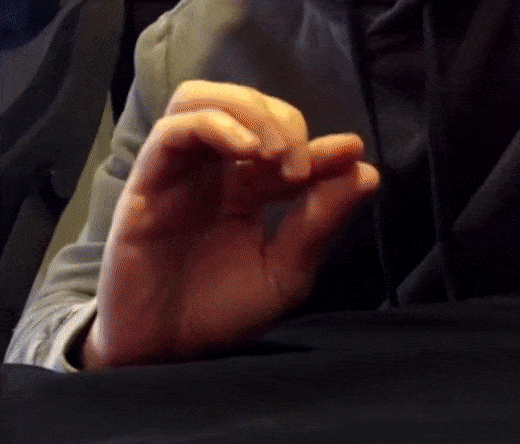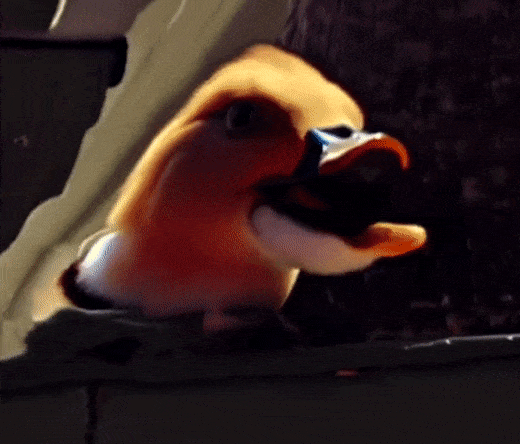
Le dita di un uomo diventano un uomo che cammina e un’anatra attraverso Stable Diffusion ed EbSynth. Fonte: https://old.reddit.com/r/StableDiffusion/comments/x92itm/proof_of_concept_using_img2img_ebsynth_to_animate/
L’utente che ha creato questo video ha commentato che la trasformazione dell’anatra, forse la più efficace delle due, se meno sorprendente e originale, ha richiesto solo un singolo frame chiave trasformato, mentre è stato necessario renderizzare 50 immagini di Stable Diffusion per creare i pantaloni che camminano, che esibiscono maggiore incoerenza temporale. L’utente ha anche notato che ci sono volute cinque prove per raggiungere la coerenza per ciascuno dei 50 frame chiave.
Pertanto, sarebbe un grande vantaggio per un’applicazione veramente completa di Stable Diffusion fornire una funzionalità che preservi le caratteristiche al massimo tra i frame chiave.
Una possibilità è quella di consentire all’utente di “congelare” la codifica stocastica per la trasformazione su ogni frame, che attualmente può essere ottenuto solo modificando manualmente il codice sorgente. Come l’esempio seguente mostra, ciò aiuta la coerenza temporale, anche se non la risolve del tutto:
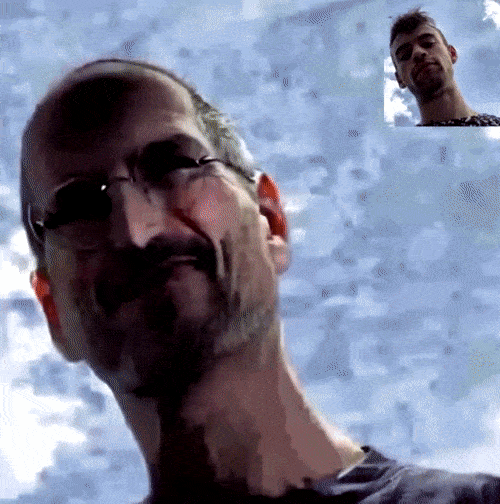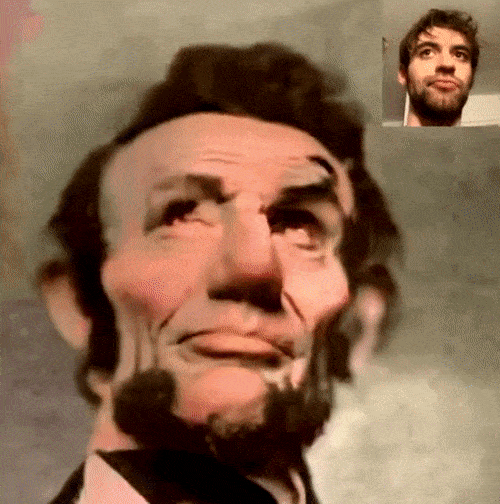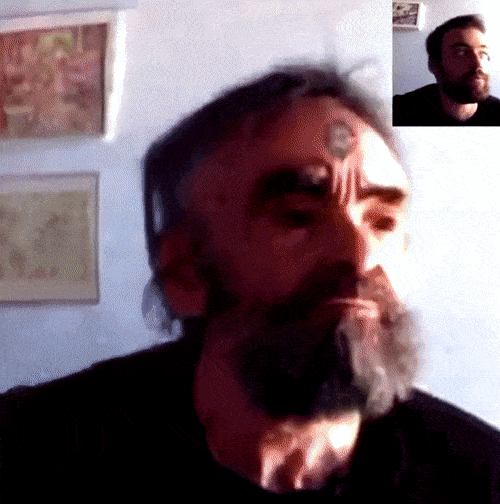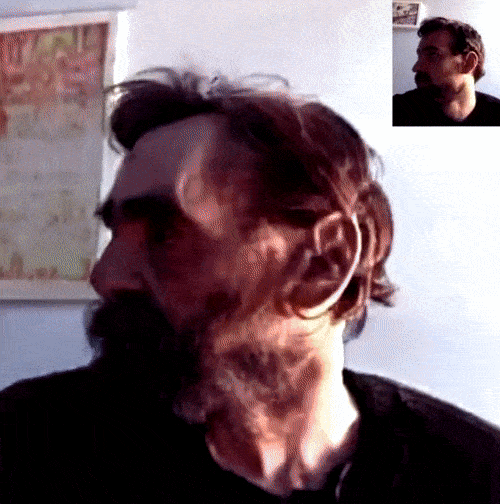
Un utente di Reddit ha trasformato riprese della propria webcam in varie celebrità mantenendo non solo il seed, cosa possibile in ogni implementazione di Stable Diffusion, ma anche lo stesso parametro stochastic_encode() in ogni trasformazione. Ha modificato il codice, ma la funzione potrebbe facilmente diventare un interruttore per l’utente. È comunque evidente che non risolve tutti i problemi temporali. Fonte: https://old.reddit.com/r/StableDiffusion/comments/wyeoqq/turning_img2img_into_vid2vid/
Inversione testuale basata su cloud
Una soluzione migliore per ottenere personaggi e oggetti temporalmente coerenti è quella di “cuocere” questi ultimi in un file di inversione testuale – un file da 5 KB che può essere addestrato in poche ore in base a sole cinque immagini annotate, che possono quindi essere evocate da una speciale parola chiave ‘*’, abilitando, ad esempio, l’apparizione persistente di personaggi nuovi da includere in una narrazione.

Le immagini associate a tag appropriati possono diventare entità distinte tramite inversione testuale ed essere richiamate senza ambiguità, nel contesto e nello stile corretti, mediante speciali parole-token. Fonte: https://huggingface.co/docs/diffusers/training/text_inversion
Le inversioni testuali sono file aggiuntivi al modello completo e addestrato che Stable Diffusion utilizza e sono effettivamente “agganciati” al processo di richiamo/prompt, in modo che possano partecipare a scene derivate dal modello e trarre vantaggio dalle enormi conoscenze del modello su oggetti, stili, ambienti e interazioni.
Tuttavia, sebbene un’inversione testuale non richieda molto tempo per l’addestramento, richiede una grande quantità di VRAM; secondo vari walkthrough attuali, da 12 a 20 o addirittura 40 GB.
Dal momento che la maggior parte degli utenti casuali non ha a disposizione quel tipo di potenza GPU, i servizi cloud stanno già emergendo per gestire l’operazione, tra cui una versione di Hugging Face. Sebbene ci siano implementazioni Google Colab che possono creare inversioni testuali per Stable Diffusion, i requisiti di VRAM e tempo possono renderle impegnative per gli utenti di Colab a livello gratuito.
Per un’applicazione potenzialmente completa e ben finanziata di Stable Diffusion, passare questo compito oneroso ai server cloud dell’azienda sembra una strategia di monetizzazione ovvia (supponendo che un’applicazione Stable Diffusion a basso costo o gratuita sia permeata da tale funzionalità non gratuita, il che sembra probabile in molte applicazioni che emergeranno da questa tecnologia nei prossimi 6-9 mesi).
Inoltre, il processo piuttosto complicato di annotare e formattare le immagini e il testo presentati potrebbe trarre vantaggio dall’automazione in un ambiente integrato. Il potenziale “fattore di dipendenza” della creazione di elementi unici che possono esplorare e interagire con i vasti mondi di Stable Diffusion sembrerebbe potenzialmente compulsivo, sia per gli appassionati che per gli utenti più giovani.
Ponderazione del prompt versatile
Ci sono molte implementazioni attuali che consentono all’utente di assegnare un’enfasi maggiore a una sezione di un lungo prompt di testo, ma lo strumento varia notevolmente tra questi e spesso è goffo o poco intuitivo.
Ad esempio, la popolare fork di Stable Diffusion di AUTOMATIC1111 può abbassare o alzare il valore di una parola del prompt racchiudendola tra parentesi singole o multiple (per la de-enfasi) o parentesi quadre per un’enfasi aggiuntiva.

Le parentesi quadre e tonde possono trasformare la colazione in questa versione dei pesi dei prompt di Stable Diffusion, ma in entrambi i casi è un incubo per il colesterolo.
Altre iterazioni di Stable Diffusion utilizzano i punti esclamativi per l’enfasi, mentre le più versatili consentono agli utenti di assegnare pesi a ogni parola nel prompt tramite la GUI.
Il sistema dovrebbe anche consentire pesi di prompt negativi – non solo per fan dell’horror, ma perché potrebbero esserci misteri meno allarmanti e più edificanti nello spazio latente di Stable Diffusion che il nostro uso limitato del linguaggio non può evocare.
Outpainting
Subito dopo l’apertura del codice sorgente di Stable Diffusion, OpenAI ha cercato – in gran parte invano – di riconquistare un po’ del suo fulgore DALL-E 2 annunciando ‘outpainting’, che consente all’utente di estendere un’immagine oltre i suoi confini con logica semantica e coerenza visiva.
Naturalmente, ciò è stato implementato in varie forme per Stable Diffusion, nonché in Krita, e dovrebbe essere sicuramente incluso in una versione completa e “Photoshop-style” di Stable Diffusion.
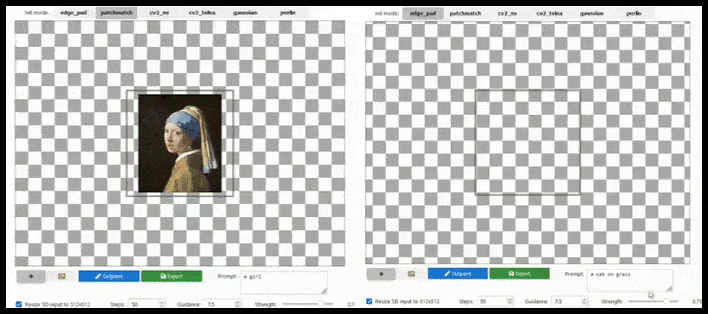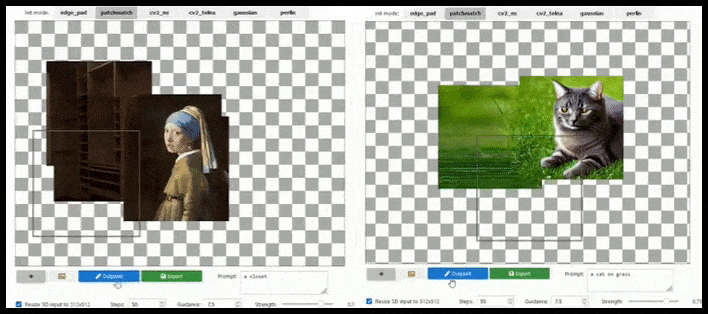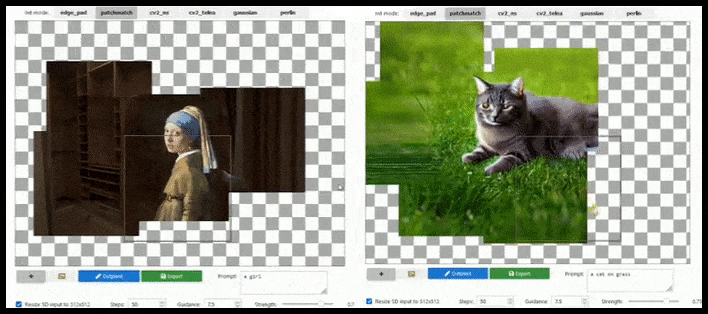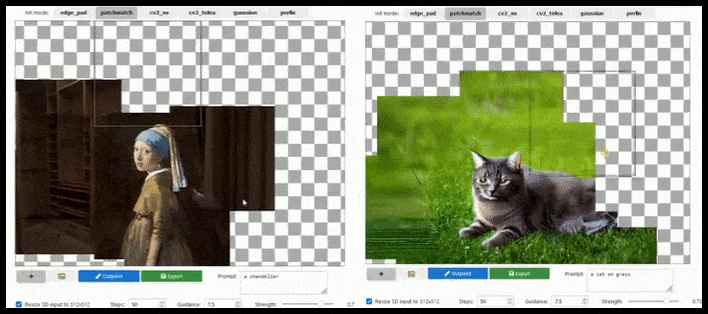
L’espansione basata su tasselli può estendere quasi all’infinito un rendering standard di 512 × 512 pixel, finché lo consentono i prompt, l’immagine esistente e la logica semantica. Fonte: https://github.com/lkwq007/stablediffusion-infinity
Perché Stable Diffusion è addestrato su immagini da 512x512px (e per una serie di altre ragioni), spesso taglia le teste (o altre parti essenziali del corpo) di soggetti umani, anche quando il prompt ha chiaramente indicato “enfasi sulla testa”, ecc..

Esempi tipici di decapitazione in Stable Diffusion; l’outpainting potrebbe però riportare George nell’immagine.
Qualsiasi implementazione di outpainting del tipo illustrato nell’immagine animata sopra (che si basa esclusivamente su librerie Unix, ma dovrebbe essere in grado di essere replicata su Windows) dovrebbe anche essere strumentata come una soluzione con un clic o un prompt per questo.
Attualmente, molti utenti estendono il canvas di rappresentazioni “decapitate” verso l’alto, riempiono approssimativamente l’area del viso e utilizzano img2img per completare il rendering guasto.
Maschera efficace che comprende il contesto
La maschera può essere un’operazione dall’esito molto incerto in Stable Diffusion, a seconda della fork o della versione in questione. Spesso, laddove è possibile disegnare una maschera coerente, l’area specificata finisce per essere ritoccata con contenuti che non tengono conto dell’intero contesto dell’immagine.
In una occasione, ho mascherato le cornee di un’immagine del viso e ho fornito il prompt ‘occhi blu’ come maschera da ritoccare – solo per scoprire che sembravo guardare attraverso due occhi umani tagliati fuori a un’immagine distante di un lupo dall’aspetto sovrannaturale. Sono fortunato che non fosse Frank Sinatra.
La modifica semantica è anche possibile identificando il rumore che ha costruito l’immagine in primo luogo, il che consente all’utente di affrontare elementi strutturali specifici in un rendering senza interferire con il resto dell’immagine:

Modifica di un elemento dell’immagine senza mascheratura tradizionale e senza alterare i contenuti adiacenti: si identifica il rumore che ha originato l’immagine e si interviene sulle parti che hanno contribuito all’area bersaglio. Fonte: https://old.reddit.com/r/StableDiffusion/comments/xboy90/a_better_way_of_doing_img2img_by_finding_the/
Questo metodo si basa sul campionatore K-Diffusion.
Filtri semantici per errori fisiologici
Come abbiamo menzionato in precedenza, Stable Diffusion può frequentemente aggiungere o sottrarre arti, in gran parte a causa di problemi di dati e carenze nelle annotazioni che accompagnano le immagini che lo hanno addestrato.

Come il bambino dispettoso che mostra la lingua nella foto di classe, le atrocità biologiche di Stable Diffusion non sono sempre evidenti subito. Potreste aver pubblicato su Instagram l’ultimo capolavoro AI prima di notare mani extra o arti fusi.
È così difficile correggere questo tipo di errori che sarebbe utile se un’applicazione completa di Stable Diffusion contenesse un sistema di riconoscimento anatomico che utilizza la segmentazione semantica per calcolare se l’immagine in entrata presenta gravi carenze anatomiche (come nell’immagine sopra) e la scarta in favore di un nuovo rendering prima di presentarla all’utente.

Certo, potresti voler rappresentare la dea Kali, o Doctor Octopus, o anche salvare una parte non affetta di un’immagine con arti fusi, quindi questa funzionalità dovrebbe essere un interruttore facoltativo.
Se gli utenti potessero tollerare l’aspetto della telemetria, tali errori potrebbero essere trasmessi in modo anonimo in uno sforzo di apprendimento federativo collettivo che potrebbe aiutare i modelli futuri a migliorare la loro comprensione della logica anatomica.
Miglioramento automatico del viso basato su LAION
Come ho notato nel mio precedente sguardo a tre cose che Stable Diffusion potrebbe affrontare in futuro, non dovrebbe essere lasciato solo a una versione di GFPGAN il tentativo di “migliorare” i visi resi in primo luogo.
I “miglioramenti” di GFPGAN sono terribilmente generici, spesso minano l’identità dell’individuo rappresentato e operano solo su un viso che ha ricevuto lo stesso tempo di elaborazione e attenzione di qualsiasi altra parte dell’immagine.
Pertanto, un programma professionale per Stable Diffusion dovrebbe essere in grado di riconoscere un viso (con una libreria standard e relativamente leggera come YOLO), applicare il pieno peso della potenza GPU disponibile per renderizzare nuovamente il viso e fondere il viso migliorato con il rendering originale a contesto completo, o salvarlo separatamente per una ricomposizione manuale. Attualmente, questo è un’operazione abbastanza “manuale”.
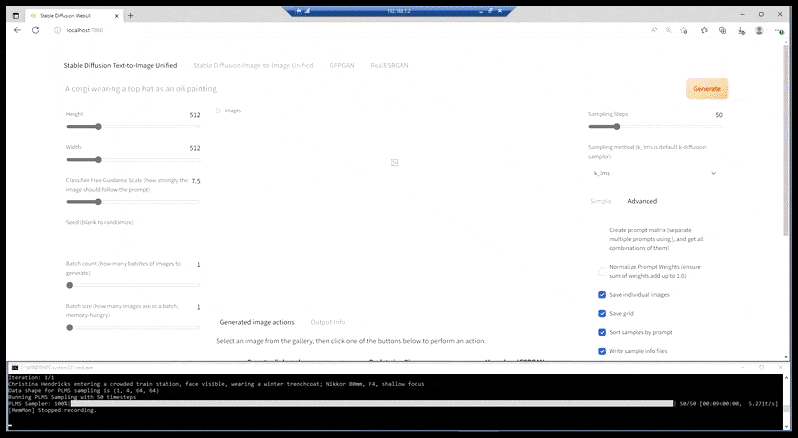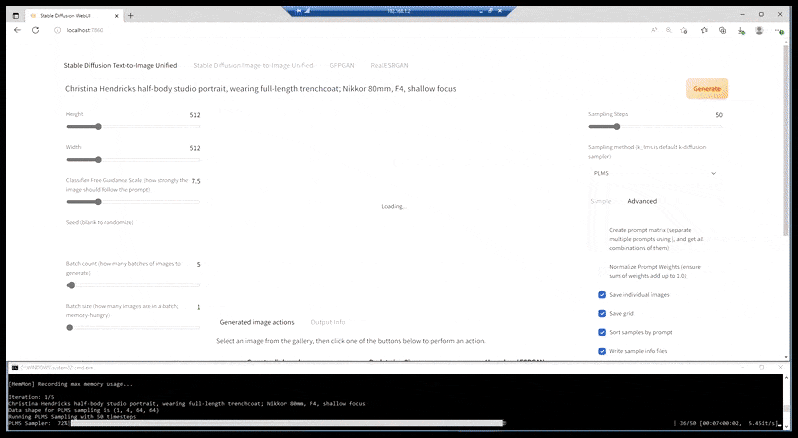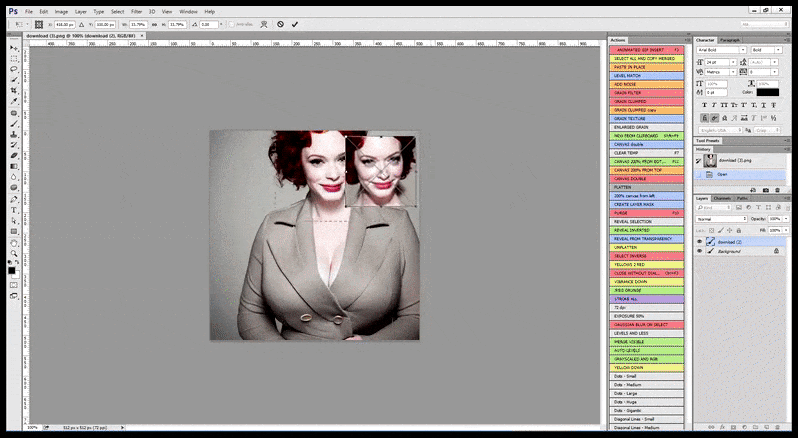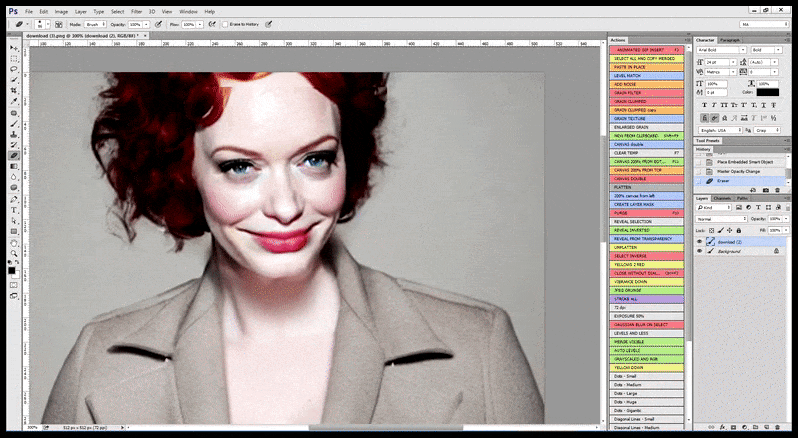
Se Stable Diffusion è stato addestrato su abbastanza immagini di una celebrità, è possibile concentrare tutta la GPU su un successivo rendering del solo volto. Di solito migliora molto e, a differenza di GFPGAN, sfrutta informazioni apprese dai dati LAION anziché limitarsi a correggere i pixel renderizzati.
Ricerche LAION all’interno dell’app
Da quando gli utenti hanno iniziato a rendersi conto che la ricerca del database LAION per concetti, persone e temi potrebbe aiutare un uso migliore di Stable Diffusion, sono state create diverse esplorazioni online di LAION, tra cui haveibeentrained.com.

La ricerca su haveibeentrained.com permette di esplorare le immagini che alimentano Stable Diffusion e capire se oggetti, persone o idee da evocare siano probabilmente entrati nell’addestramento. Aiuta anche a scoprire entità vicine, come raggruppamenti di celebrità o la prossima idea collegata a quella attuale. Fonte: https://haveibeentrained.com/?search_text=bowl%20of%20fruit
Sebbene tali database web spesso rivelino alcuni dei tag che accompagnano le immagini, il processo di generalizzazione che si verifica durante l’addestramento del modello significa che è improbabile che una particolare immagine possa essere evocata utilizzando il suo tag come prompt.
Inoltre, la rimozione di ‘parole di stop’ e la pratica di stemming e lemmatizzazione nel trattamento del linguaggio naturale significa che molte delle frasi visualizzate sono state divise o omesse prima di essere addestrate in Stable Diffusion.
Tuttavia, il modo in cui i raggruppamenti estetici si legano insieme in queste interfacce può insegnare all’utente finale molto sulla logica (o, argomentando, la “personalità”) di Stable Diffusion e può aiutare una migliore produzione di immagini.
Conclusione
Ci sono molte altre funzionalità che mi piacerebbe vedere in un’applicazione desktop nativa completa di Stable Diffusion, come l’analisi dell’immagine basata su CLIP nativa, che inverte il processo standard di Stable Diffusion e consente all’utente di evocare frasi e parole che il sistema associerebbe naturalmente all’immagine di origine o al rendering.
Inoltre, il vero aumento di risoluzione basato su tasselli sarebbe un’aggiunta benvenuta, poiché ESRGAN è quasi altrettanto grossolano di GFPGAN. Fortunatamente, i piani per integrare l’implementazione txt2imghd di GOBIG stanno rapidamente rendendo ciò una realtà in tutte le distribuzioni e sembra una scelta ovvia per un’iterazione desktop.
Alcune altre richieste popolari dalle comunità Discord mi interessano meno, come dizionari di prompt integrati e elenchi applicabili di artisti e stili, sebbene un taccuino in-app o un lessico personalizzabile di frasi sembri un’aggiunta logica.
Allo stesso modo, le limitazioni attuali dell’animazione umano-centrica in Stable Diffusion, sebbene avviate da CogVideo e altri progetti, rimangono incredibilmente primitive e alla mercé della ricerca di base sulle informazioni a priori temporali relativi al movimento umano autentico.
Per ora, il video di Stable Diffusion è strettamente psichedelico, sebbene possa avere un futuro più luminoso nella marionetta deepfake, tramite EbSynth e altre iniziative testo-video relativamente nascenti (ed è degno di nota la mancanza di persone sintetizzate o “modificate” nel video promozionale più recente di Runway).
Un’altra funzionalità preziosa sarebbe il trasferimento fluido delle immagini a Photoshop e viceversa, da tempo stabilito nell’editor di texture di Cinema4D, tra altre implementazioni simili. Con questo, è possibile scambiare facilmente immagini tra le applicazioni e utilizzare ogni applicazione per eseguire le trasformazioni in cui eccelle.
Infine, e forse più importante, un programma desktop completo di Stable Diffusion dovrebbe essere in grado non solo di scambiare facilmente tra i checkpoint (ossia le versioni del modello sottostante che alimenta il sistema), ma dovrebbe anche essere in grado di aggiornare le inversioni testuali personalizzate create con rilasci precedenti del modello, che potrebbero altrimenti essere rotte dalle versioni successive del modello (come hanno indicato gli sviluppatori nel Discord ufficiale).
Ironia della sorte, l’organizzazione nella posizione migliore per creare una matrice di strumenti così potente e integrata per Stable Diffusion, Adobe, si è alleata così fortemente all’Content Authenticity Initiative che potrebbe sembrare un passo indietro di PR per l’azienda – a meno che non decidesse di limitare i poteri generativi di Stable Diffusion in modo così completo come OpenAI ha fatto con DALL-E 2 e posizionarlo invece come una naturale evoluzione delle sue considerevoli partecipazioni nella fotografia stock.
Pubblicato per la prima volta il 15 settembre 2022.


