
Interviste
Fabiana Clemente, Co-fondatrice e Chief Data Officer di YData – Serie di interviste

 Aggiungi Unite.AI alle tue fonti preferite su Google
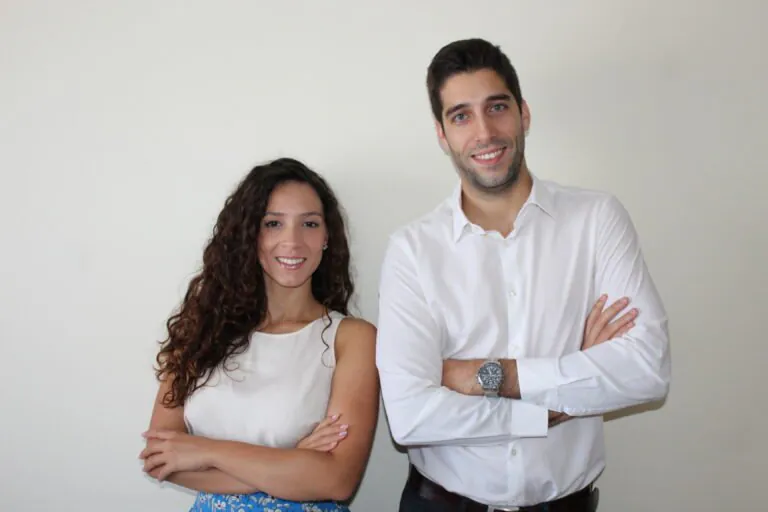
Fabiana Clemente è la Co-fondatrice e Chief Data Officer di YData. YData è una startup di intelligenza artificiale che ha creato la prima soluzione di sviluppo basata sui dati per combinare la scoperta, il miglioramento e la scalabilità in un’unica piattaforma.
Cosa ti ha inizialmente attratto verso l’intelligenza artificiale e il machine learning?
Il mio background è in Matematica Applicata, dove ho avuto l’opportunità di imparare e capire come possiamo estrarre informazioni dai dati, nonché come farlo utilizzando il codice. A quel tempo non era così “sexy” come il Machine Learning, ma è stato sicuramente ciò che ha acceso la mia passione per l’area.
Puoi condividere la storia di come è nata Ydata?
Come Data Scientist che ha lavorato per startup e aziende, ho avuto la mia dose di difficoltà – a volte l’accesso ai dati era bloccato per motivi di sicurezza o privacy, altre volte l’accesso era facile, ma la qualità dei dati non era nemmeno vicina a ciò che era necessario per costruire soluzioni basate sull’intelligenza artificiale. Sapendo che queste difficoltà sono molto frequenti nella maggior parte delle organizzazioni, ci ha ispirato a fondare l’azienda con l’obiettivo di aiutare questi team a superare questi ostacoli, accelerando lo sviluppo dell’intelligenza artificiale con dati migliorati.
Puoi descrivere al nostro pubblico cosa è il dato sintetico?
I dati sintetici sono considerati qualsiasi dato che non è stato generato nel mondo reale, quindi qualsiasi dato creato artificialmente. Ci sono metodi che consentono la generazione di dati sintetici – dalle strategie basate su regole a quelle che utilizzano modelli di Machine o Deep Learning per imparare queste “regole” per noi. YData ha adottato e si è specializzato in una strategia basata sul Deep Learning per generare nuovi dati che mantengono il comportamento degli eventi del mondo reale senza preoccupazioni relative alla privacy.
Cosa rende i dati sintetici così importanti?
Più le organizzazioni capiscono l’importanza dei dati per migliorare i loro affari, più capiranno l’importanza e il ruolo dei dati sintetici. Raccogliere dati reali non è solo tempo-consuming e costoso, ma a volte anche impossibile. Per costruire applicazioni di intelligenza artificiale, i dati sono un requisito fondamentale – è qui che i dati sintetici vengono in soccorso. La capacità di generare scenari non visti o di sbloccare l’accesso ai dati è fondamentale per evolversi in un mondo in cui pionieri come Andrew Ng, affermano che diventare data-centric è fondamentale per un’adozione di successo dell’intelligenza artificiale.
Nelle auto a guida autonoma o in altre attività di automazione delle macchine, possiamo già percepire l’importanza dei dati sintetici, quindi direi che è solo naturale che questa comprensione si diffonda in tutti i settori verticali.
Come Ydata genera dati sintetici?
YData si basa principalmente su modelli generativi profondi per imparare gli attributi statistici e le correlazioni tra variabili dei dati originali. Ciò consente al modello di generare un set di dati statisticamente rilevante che ha lo stesso valore aziendale di quello originale, senza permettere la tracciabilità dei record originali.
YData sta spingendo questa tecnologia in avanti e si trova dietro la Comunità dei dati sintetici – un gruppo di esperti di data science impegnati a diffondere e aiutare chiunque voglia imparare e utilizzare questa tecnologia.
Come la piattaforma Ydata aiuta a scoprire e sbloccare nuove fonti di dati?
La piattaforma YData include connettori integrati per qualsiasi tipo di database, data warehouse o data lake, che consente agli utenti di accedere facilmente ai metadati rilevanti e capire se i dati esistenti sono utili per rispondere alle domande aziendali che hanno a portata di mano – senza nemmeno guardare i record reali.
Puoi condividere alcuni dettagli riguardanti la comunità open source dei dati sintetici?
I dati sintetici sono solo ai primi giorni e per questo motivo la consapevolezza di come vengono generati, i benefici o i limiti sono ancora poco noti a un pubblico più ampio. Per questo motivo, YData ha deciso di intraprendere una strada più educativa creando la comunità dei dati sintetici – oltre a essere un luogo in cui scambiare idee o ottenere aiuto da esperti nel campo dei dati sintetici, è anche un luogo in cui data scientist e altri profili tecnici possono iniziare il loro viaggio nei dati sintetici, con alcuni degli algoritmi più interessanti della letteratura.
Inoltre, offriamo anche una prospettiva sulla qualità dei dati, in modo che i data scientist possano prima capire i dati con cui stanno lavorando, prima di sintetizzare o migliorare la sintesi dei dati. Siamo veramente impegnati nell’aiutare i team di dati a diventare sempre più data-centric.
YData ha recentemente annunciato 2,7 milioni di dollari di finanziamento per accelerare la sua espansione internazionale. Puoi condividere alcuni dettagli su cosa significa questo per il futuro dell’azienda e la sua strategia di espansione?
YData è nata già internazionale – sapevamo che questo tipo di tecnologia necessita di early adopter che sono solitamente nei paesi più sofisticati. Per questo motivo, i nostri primi clienti erano già fuori del Portogallo, in tutta Europa e ora stiamo stabilendo una presenza anche in Nord America. Questo finanziamento ci permetterà di rafforzare la nostra presenza in entrambi i continenti, non solo commercialmente, ma anche per crescere il team: siamo un team completamente distribuito, il che ci consente di assumere i migliori talenti, ovunque si trovino.
C’è qualcos’altro che vorresti condividere su YData?
YData sta spingendo i confini dell’intelligenza artificiale basata sui dati e creando una nuova categoria: DataPrepOps – anche se è un nome brutto, è un dolore che la maggior parte delle aziende sta affrontando oggi quando si tratta di sviluppo della data science. La tendenza della qualità dei dati continua a crescere e dopo i Data Pipelines e la Data Observability, la qualità dei dati per i team di data science è ancora in fasce e YData sta emergendo come un leader del pensiero nella preparazione dei dati.
Grazie per la grande intervista, i lettori che desiderano saperne di più possono visitare YData.


