
Modelli e piattaforme di IA
Guida Completa su Gemma 2: Il Nuovo Modello di Linguaggio Aperto di Google

 Aggiungi Unite.AI alle tue fonti preferite su Google
Gemma 2 si basa sul suo predecessore, offrendo prestazioni migliorate e una serie di funzionalità innovative che lo rendono particolarmente adatto per applicazioni di ricerca e pratiche. Ciò che distingue Gemma 2 è la sua capacità di offrire prestazioni paragonabili a quelle di modelli proprietari molto più grandi, ma in un pacchetto progettato per una maggiore accessibilità e utilizzo su configurazioni hardware più modeste.
Mentre esaminavo le specifiche tecniche e l’architettura di Gemma 2, mi sono trovato sempre più impressionato dall’ingegnosità del suo design. Il modello incorpora diverse tecniche avanzate, tra cui meccanismi di attenzione innovativi e approcci innovativi per la stabilità dell’addestramento, che contribuiscono alle sue capacità notevoli.

Google [securities_stock_price_tag symbol="GOOGL" exchange="NASDAQ"] Open Source LLM Gemma
In questa guida completa, esploreremo Gemma 2 in profondità, esaminando la sua architettura, le funzionalità chiave e le applicazioni pratiche. Sia che tu sia un praticante di AI esperto o un nuovo arrivato nel settore, questo articolo si propone di fornire approfondimenti preziosi su come funziona Gemma 2 e su come puoi sfruttarne il potere nei tuoi progetti.
Cosa è Gemma 2?
Gemma 2 è il nuovo modello di linguaggio aperto di Google, progettato per essere leggero ma potente. È costruito sulla stessa ricerca e tecnologia utilizzata per creare i modelli Gemini di Google, offrendo prestazioni all’avanguardia in un pacchetto più accessibile. Gemma 2 è disponibile in due taglie:
Gemma 2 9B: un modello da 9 miliardi di parametri
Gemma 2 27B: un modello più grande da 27 miliardi di parametri
Ogni taglia è disponibile in due varianti:
Modelli base: pre-addestrati su un vasto corpus di dati testuali
Modelli istruiti (IT): ottimizzati per prestazioni migliori su compiti specifici
Accedi ai modelli in Google AI Studio: Google AI Studio – Gemma 2
Leggi il rapporto tecnico qui: Rapporto tecnico di Gemma 2
Funzionalità chiave e miglioramenti
Gemma 2 introduce diverse innovazioni significative rispetto al suo predecessore:
1. Dati di addestramento aumentati
I modelli sono stati addestrati su molti più dati:
Gemma 2 27B: addestrato su 13 trilioni di token
Gemma 2 9B: addestrato su 8 trilioni di token
Questo set di dati ampliato, costituito principalmente da dati web (per lo più in inglese), codice e matematica, contribuisce alle prestazioni migliorate e alla versatilità dei modelli.
2. Attenzione a finestra mobile
Gemma 2 implementa un approccio innovativo ai meccanismi di attenzione:
Ogni altro livello utilizza un’attenzione a finestra mobile con un contesto locale di 4096 token
I livelli alternati utilizzano un’attenzione globale quadratica completa nel contesto di 8192 token
Questo approccio ibrido mira a bilanciare l’efficienza con la capacità di catturare dipendenze a lungo raggio nell’input.
3. Soft-capping
Per migliorare la stabilità dell’addestramento e le prestazioni, Gemma 2 introduce un meccanismo di soft-capping:
<p>def soft_cap(x, cap):
return cap * torch.tanh(x / cap)</p>

<p># Applicato ai logiti dell'attenzione
attention_logits = soft_cap(attention_logits, cap=50.0)</p>

<p># Applicato ai logiti del livello finale

<p>final_logits = soft_cap(final_logits, cap=30.0)
Questa tecnica impedisce ai logiti di crescere eccessivamente grandi senza troncamento rigido, mantenendo più informazioni e stabilizzando il processo di addestramento.
- Gemma 2 9B: un modello da 9 miliardi di parametri
- Gemma 2 27B: un modello più grande da 27 miliardi di parametri
Ogni taglia è disponibile in due varianti:
- Modelli base: pre-addestrati su un vasto corpus di dati testuali
- Modelli istruiti (IT): ottimizzati per prestazioni migliori su compiti specifici
4. Distillazione della conoscenza
Per il modello da 9 miliardi di parametri, Gemma 2 utilizza tecniche di distillazione della conoscenza:
- Pre-addestramento: il modello da 9 miliardi di parametri apprende da un modello insegnante più grande durante l’addestramento iniziale
- Post-addestramento: sia il modello da 9 miliardi di parametri che quello da 27 miliardi di parametri utilizzano la distillazione della politica per raffinare le loro prestazioni
Questo processo aiuta il modello più piccolo a catturare le capacità dei modelli più grandi in modo più efficace.
5. Fusione dei modelli
Gemma 2 utilizza una tecnica di fusione dei modelli chiamata Warp, che combina più modelli in tre fasi:
- Media mobile esponenziale (EMA) durante l’addestramento di rinforzo
- Interpolazione lineare sferica (SLERP) dopo l’addestramento di più politiche
- Interpolazione lineare verso l’inizializzazione (LITI) come passo finale
Questo approccio mira a creare un modello finale più robusto e capace.
Banche di prova delle prestazioni
Gemma 2 dimostra prestazioni impressionanti in varie banche di prova:
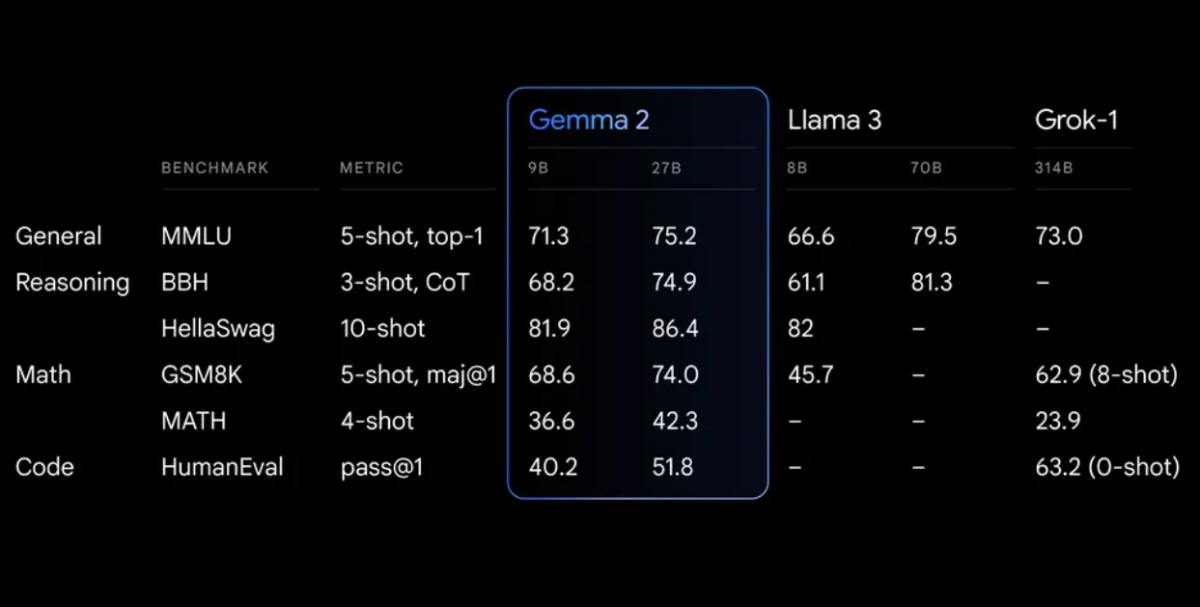
Gemma 2 su un’architettura ridisegnata, progettata per prestazioni eccezionali e efficienza di inferenza
Iniziare con Gemma 2
Per iniziare a utilizzare Gemma 2 nei tuoi progetti, hai diverse opzioni:
1. Google AI Studio
Per esperimenti rapidi senza requisiti hardware, puoi accedere a Gemma 2 attraverso Google AI Studio.
2. Hugging Transformers
Gemma 2 è integrato con la libreria Hugging Face Transformers. Ecco come puoi utilizzarlo:
<div class="relative flex flex-col rounded-lg"> <div class="text-text-300 absolute pl-3 pt-2.5 text-xs"> <p>from transformers import AutoTokenizer, AutoModelForCausalLM</p> <p># Carica il modello e il tokenizzatore model_name = "google/gemma-2-27b-it" # o "google/gemma-2-9b-it" per la versione più piccola tokenizer = AutoTokenizer.from_pretrained(model_name) model = AutoModelForCausalLM.from_pretrained(model_name)</p> <p># Prepara l'input prompt = "Spiega il concetto di entanglement quantistico in termini semplici." inputs = tokenizer(prompt, return_tensors="pt")</p> <p># Genera testo outputs = model.generate(**inputs, max_length=200) response = tokenizer.decode(outputs[0], skip_special_tokens=True)</p> print(response)
3. TensorFlow/Keras
Per gli utenti di TensorFlow, Gemma 2 è disponibile tramite Keras:
<p>import tensorflow as tf from keras_nlp.models import GemmaCausalLM</p> <p># Carica il modello model = GemmaCausalLM.from_preset("gemma_2b_en")</p> <p># Genera testo prompt = "Spiega il concetto di entanglement quantistico in termini semplici." output = model.generate(prompt, max_length=200)</p> print(output)
Utilizzo avanzato: costruire un sistema RAG locale con Gemma 2
Una delle applicazioni più potenti di Gemma 2 è la costruzione di un sistema di generazione aumentata di recupero (RAG). Creiamo un semplice sistema RAG locale utilizzando Gemma 2 e le embeddings di Nomic.
Passo 1: configurazione dell’ambiente
Prima di tutto, assicurati di avere le librerie necessarie installate:
<p>pip install langchain ollama nomic chromadb</p>
Passo 2: indicizzazione dei documenti
Crea un indicizzatore per elaborare i tuoi documenti:
<p>import os from langchain.text_splitter import RecursiveCharacterTextSplitter from langchain.document_loaders import DirectoryLoader from langchain.vectorstores import Chroma from langchain.embeddings import HuggingFaceEmbeddings</p> <p>class Indexer: def __init__(self, directory_path): self.directory_path = directory_path self.text_splitter = RecursiveCharacterTextSplitter(chunk_size=1000, chunk_overlap=200) self.embeddings = HuggingFaceEmbeddings(model_name="nomic-ai/nomic-embed-text-v1")</p> <p>def load_and_split_documents(self): loader = DirectoryLoader(self.directory_path, glob="**/*.txt") documents = loader.load() return self.text_splitter.split_documents(documents)</p> <p>def create_vector_store(self, documents): return Chroma.from_documents(documents, self.embeddings, persist_directory="./chroma_db")</p> <p>def index(self): documents = self.load_and_split_documents() vector_store = self.create_vector_store(documents) vector_store.persist() return vector_store</p> <p># Utilizzo indexer = Indexer("path/to/your/documents") vector_store = indexer.index()</p>
Passo 3: configurazione del sistema RAG
Ora, creiamo il sistema RAG utilizzando Gemma 2:
<p>from langchain.llms import Ollama
from langchain.chains import RetrievalQA
from langchain.prompts import PromptTemplate</p>
<p>class RAGSystem:
def __init__(self, vector_store):
self.vector_store = vector_store
self.llm = Ollama(model="gemma2:9b")
self.retriever = self.vector_store.as_retriever(search_kwargs={"k": 3})</p>
<p>self.template = """Utilizza i seguenti pezzi di contesto per rispondere alla domanda alla fine.
Se non conosci la risposta, semplicemente dicilo, non cercare di inventarla.</p>
{context}
<p>Dominanda: {question}
Risposta: """</p>
<p>self.qa_prompt = PromptTemplate(
template=self.template, input_variables=["context", "question"]
)</p>
<p>self.qa_chain = RetrievalQA.from_chain_type(
llm=self.llm,
chain_type="stuff",
retriever=self.retriever,
return_source_documents=True,
chain_type_kwargs={"prompt": self.qa_prompt}
)</p>
<p>def query(self, question):
return self.qa_chain({"query": question})</p>
<p># Utilizzo
rag_system = RAGSystem(vector_store)
response = rag_system.query("Qual è la capitale della Francia?")
print(response["result"])</p>
Questo sistema RAG utilizza Gemma 2 attraverso Ollama per il modello linguistico e le embeddings di Nomic per il recupero dei documenti. Consente di porre domande in base ai documenti indicizzati, fornendo risposte con contesto dalle fonti rilevanti.
Perfezionamento di Gemma 2
Per compiti o domini specifici, potresti voler perfezionare Gemma 2. Ecco un esempio di base utilizzando la libreria Hugging Face Transformers:
from transformers import AutoTokenizer, AutoModelForCausalLM, TrainingArguments, Trainer from datasets import load_dataset <p># Carica il modello e il tokenizzatore model_name = "google/gemma-2-9b-it" tokenizer = AutoTokenizer.from_pretrained(model_name) model = AutoModelForCausalLM.from_pretrained(model_name)</p> <p># Prepara il dataset dataset = load_dataset("your_dataset")</p> <p>def tokenize_function(examples): return tokenizer(examples["text"], padding="max_length", truncation=True)</p> <p>tokenized_datasets = dataset.map(tokenize_function, batched=True)</p> <p># Imposta gli argomenti di addestramento training_args = TrainingArguments( output_dir="./results", num_train_epochs=3, per_device_train_batch_size=4, per_device_eval_batch_size=4, warmup_steps=500, weight_decay=0.01, logging_dir="./logs", )</p> <p># Inizializza il trainer trainer = Trainer( model=model, args=training_args, train_dataset=tokenized_datasets["train"], eval_dataset=tokenized_datasets["test"], )</p> # Inizia il perfezionamento trainer.train() <p># Salva il modello perfezionato model.save_pretrained("./fine_tuned_gemma2") tokenizer.save_pretrained("./fine_tuned_gemma2")</p>
Ricorda di regolare i parametri di addestramento in base alle tue esigenze specifiche e alle risorse computazionali.
Considerazioni etiche e limitazioni
Sebbene Gemma 2 offra capacità impressionanti, è fondamentale essere consapevoli delle sue limitazioni e considerazioni etiche:
- Predisposizione: come tutti i modelli linguistici, Gemma 2 può riflettere le predisposizioni presenti nei suoi dati di addestramento. Valuta sempre criticamente le sue uscite.
- Esattezza fattuale: sebbene molto capace, Gemma 2 può occasionalmente generare informazioni scorrette o inconsistenti. Verifica i fatti importanti da fonti attendibili.
- Lunghezza del contesto: Gemma 2 ha una lunghezza di contesto di 8192 token. Per documenti o conversazioni più lunghi, potresti dover implementare strategie per gestire il contesto in modo efficace.
- Risorse computazionali: in particolare per il modello da 27 miliardi di parametri, potrebbero essere richieste risorse computazionali significative per un’inferenza e un perfezionamento efficienti.
- Utilizzo responsabile: attieniti alle pratiche di AI responsabile di Google e assicurati che il tuo utilizzo di Gemma 2 sia allineato con i principi etici dell’AI.
Conclusione
Gemma 2, con le sue funzionalità avanzate come l’attenzione a finestra mobile, il soft-capping e le tecniche di fusione dei modelli innovative, è uno strumento potente per una vasta gamma di compiti di elaborazione del linguaggio naturale.
Utilizzando Gemma 2 nei tuoi progetti, sia attraverso inferenze semplici, sistemi RAG complessi o modelli perfezionati per domini specifici, puoi sfruttare il potere dell’AI all’avanguardia mantenendo il controllo sui tuoi dati e processi.


