
साक्षात्कार
यारोन सिंगर, रोबस्ट इंटेलिजेंस के सीईओ और हार्वर्ड विश्वविद्यालय में कंप्यूटर विज्ञान के प्रोफेसर – साक्षात्कार श्रृंखला

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें
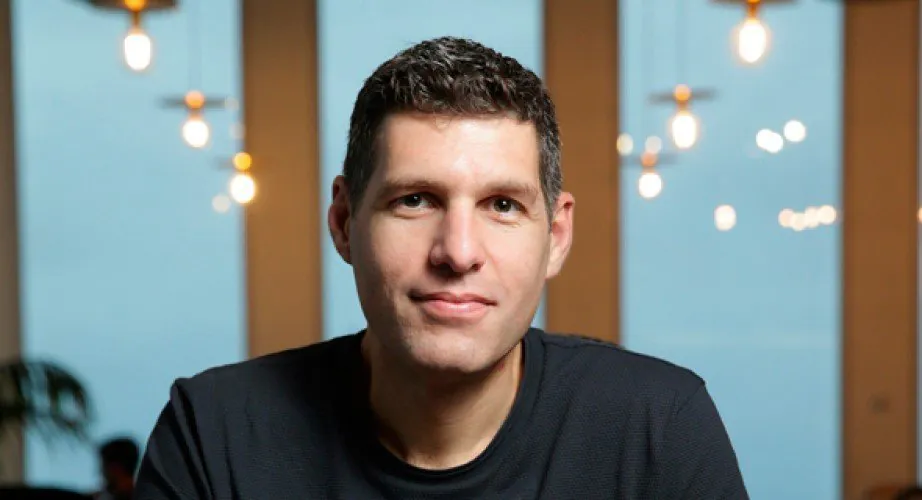
यारोन सिंगर रोबस्ट इंटेलिजेंस के सीईओ और हार्वर्ड विश्वविद्यालय में कंप्यूटर विज्ञान और अनुप्रयुक्त गणित के प्रोफेसर हैं। यारोन मशीन लर्निंग, एल्गोरिदम और ऑप्टिमाइजेशन में नए परिणामों के लिए जाने जाते हैं। इससे पहले, यारोन ने गूगल रिसर्च में काम किया और यूसी बर्कले से अपनी पीएचडी प्राप्त की।
(GOOGL )आपको कंप्यूटर विज्ञान और मशीन लर्निंग के क्षेत्र में आकर्षित करने वाली पहली चीज़ क्या थी?
मेरी यात्रा गणित से शुरू हुई, जिसने मुझे कंप्यूटर विज्ञान की ओर ले जाया, जिसने मुझे मशीन लर्निंग की ओर ले जाया। गणित ने मुझे आकर्षित किया क्योंकि इसकी स्वयंसिद्धों की प्रणाली ने मुझे नए विश्व बनाने की क्षमता दी। कंप्यूटर विज्ञान के साथ, मैंने अस्तित्व के प्रमाणों के बारे में सीखा, लेकिन उन प्रमाणों के पीछे के एल्गोरिदम के बारे में भी। एक रचनात्मक दृष्टिकोण से, कंप्यूटर विज्ञान वह सीमा है जो हमें यह बताती है कि हम क्या कर सकते हैं और क्या नहीं कर सकते हैं।
मेरी मशीन लर्निंग में रुचि वास्तविक डेटा में निहित है, लगभग इसके भौतिक पहलू में। वास्तविक दुनिया से चीजों को लेना और उन्हें अर्थपूर्ण बनाने के लिए मॉडलिंग करना। हम वास्तव में एक बेहतर दुनिया बनाने के लिए मॉडलिंग के माध्यम से चीजों को इंजीनियर कर सकते हैं। इसलिए, गणित ने मुझे सिद्ध करने के लिए एक आधार दिया, कंप्यूटर विज्ञान ने मुझे यह देखने में मदद की कि हम क्या कर सकते हैं और क्या नहीं कर सकते हैं, और मशीन लर्निंग ने मुझे इन अवधारणाओं को दुनिया में मॉडल करने में सक्षम बनाया।
हार्वर्ड विश्वविद्यालय में कंप्यूटर विज्ञान और अनुप्रयुक्त गणित के प्रोफेसर के रूप में आपके अनुभव से आपको क्या मिला?
हार्वर्ड में एक फैकल्टी सदस्य के रूप में मेरा सबसे बड़ा लाभ यह है कि इसने बड़ी उपलब्धियाँ हासिल करने की मेरी आकांक्षा बढ़ाई। हार्वर्ड में पारंपरिक रूप से एक छोटी सी फैकल्टी है, और टेन्योर ट्रैक फैकल्टी से अपेक्षा की जाती है कि वे बड़ी समस्याओं को हल करें और नए क्षेत्र बनाएं। आपको बहुत ही महत्वाकांक्षी होना चाहिए। यह अंततः एक श्रेणी बनाने वाले स्टार्टअप को लॉन्च करने और एक नए स्थान को परिभाषित करने के लिए बहुत अच्छी तैयारी है। मैं विशेष रूप से हार्वर्ड के टेन्योर ट्रैक से गुजरने की सलाह नहीं देता – लेकिन अगर आप उसे पार कर लेते हैं, तो स्टार्टअप बनाना आसान हो जाता है।
कृपया अपने उस ‘आहा’ पल का वर्णन करें जब आप यह महसूस करने में सफल रहे कि जटिल एआई प्रणालियां खराब डेटा के प्रति संवेदनशील होती हैं, जिसके कुछ दूरगामी परिणाम हो सकते हैं?
जब मैं यूसी बर्कले में स्नातकोत्तर छात्र था, तब मैंने पढ़ाई से कुछ समय का अवकाश लेकर एक स्टार्टअप स्थापित किया जिसने सोशल नेटवर्क में विपणन के लिए मशीन लर्निंग मॉडल बनाए। यह 2010 में था। हमारे पास सोशल मीडिया से बहुत सारा डेटा था, और हमने सभी मॉडलों को स्क्रैच से कोड किया। खुदरा विक्रेताओं के लिए वित्तीय परिणाम बहुत महत्वपूर्ण थे, इसलिए हमने मॉडल के प्रदर्शन पर बारीकी से नज़र रखी। चूंकि हमने सोशल मीडिया से डेटा का उपयोग किया, इसलिए इनपुट में कई त्रुटियां थीं, साथ ही ड्रिफ्ट भी था। हमने देखा कि छोटी त्रुटियों के परिणामस्वरूप मॉडल के आउटपुट में बड़े परिवर्तन हो सकते हैं और खुदरा विक्रेताओं के लिए खराब वित्तीय परिणाम हो सकते हैं जो उत्पाद का उपयोग करते हैं।
जब मैं गूगल+ (उन लोगों के लिए जो याद रखते हैं) पर काम करने के लिए स्थानांतरित हुआ, तो मैंने ठीक उसी प्रभाव को देखा। अधिक नाटकीय रूप से, AdWords जैसी प्रणालियों में, जो कीवर्ड के आधार पर विज्ञापन पर क्लिक होने की संभावना का पूर्वानुमान लगाती हैं, हमने देखा कि मॉडल में छोटी त्रुटियां बहुत खराब भविष्यवाणियों का कारण बनती हैं। जब आप इस समस्या को गूगल के पैमाने पर देखते हैं, तो आप महसूस करते हैं कि यह समस्या सार्वभौमिक है।
इन अनुभवों ने मेरे शोध को बहुत प्रभावित किया, और मैंने हार्वर्ड में यह जांच करने में समय बिताया कि एआई मॉडल गलतियां क्यों करते हैं और, महत्वपूर्ण रूप से, एल्गोरिदम को कैसे डिज़ाइन किया जाए जो मॉडल को गलतियां करने से रोक सकते हैं। यह, ज़ाहिर है, और ‘आहा’ पलों की ओर ले जाता है, और अंततः रोबस्ट इंटेलिजेंस के निर्माण की ओर ले जाता है।
रोबस्ट इंटेलिजेंस के पीछे की उत्पत्ति की कहानी साझा करें?
रोबस्ट इंटेलिजेंस एक सैद्धांतिक समस्या से शुरू हुआ: एआई मॉडल के निर्णयों के लिए हमें क्या गारंटी मिल सकती है। कोजिन हार्वर्ड में एक छात्र था, और हमने एक साथ काम किया, शुरू में शोध पत्र लिखने के लिए। इसलिए, यह शोध पत्रों के साथ शुरू होता है जोसैद्धांतिक रूप से संभव और असंभव क्या है, इसके बारे में बताते हैं। बाद में ये परिणाम एल्गोरिदम और मॉडल को डिज़ाइन करने के लिए जारी रहे जो एआई विफलताओं के प्रति मजबूत हैं। हमने तब प्रणालियों का निर्माण किया जो इन एल्गोरिदम को व्यावहारिक रूप से चला सकती हैं। उसके बाद, एक कंपनी शुरू करना जहां संगठन ऐसी प्रणाली का उपयोग कर सकते हैं, यह एक प्राकृतिक अगला कदम था।
रोबस्ट इंटेलिजेंस द्वारा संबोधित किए जाने वाले कई मुद्दों में से एक हैं मौन त्रुटियां, वे क्या हैं और वे इतनी खतरनाक क्यों हैं?
मौन त्रुटियों की तकनीकी परिभाषा देने से पहले, यह समझना आवश्यक है कि हम एआई मॉडल की त्रुटियों के बारे में क्यों परवाह करते हैं। हम एआई मॉडल की त्रुटियों के बारे में परवाह करते हैं क्योंकि इन त्रुटियों के परिणाम होते हैं। हमारी दुनिया एआई का उपयोग महत्वपूर्ण निर्णयों को स्वचालित करने के लिए कर रही है: कौन एक व्यवसाय ऋण प्राप्त करता है और किस दर पर, कौन स्वास्थ्य बीमा कवरेज प्राप्त करता है और किस दर पर, कौन से पड़ोस पुलिस को गश्त करना चाहिए, कौन एक नौकरी के लिए शीर्ष उम्मीदवार है, कैसे हवाई अड्डे की सुरक्षा का आयोजन किया जाना चाहिए, और इसी तरह। एआई मॉडल बहुत अधिक त्रुटि-प्रवण होने का तथ्य यह है कि हम इन महत्वपूर्ण निर्णयों को स्वचालित करके बहुत अधिक जोखिम उठाते हैं। रोबस्ट इंटेलिजेंस में, हम इसे “एआई जोखिम” कहते हैं और कंपनी का मिशन एआई जोखिम को समाप्त करना है।
मौन त्रुटियां एआई मॉडल की त्रुटियां हैं जहां एआई मॉडल इनपुट प्राप्त करता है और एक भविष्यवाणी या निर्णय का उत्पादन करता है जो गलत या पूर्वाग्रहपूर्ण है। इसलिए, सतह पर, प्रणाली के लिए सब कुछ कार्यात्मक दृष्टिकोण से ठीक लगता है, क्योंकि एआई मॉडल वही कर रहा है जो यह करने के लिए है। लेकिन भविष्यवाणी या निर्णय गलत है। ये त्रुटियां मौन हैं क्योंकि प्रणाली को पता नहीं है कि एक त्रुटि है। यह एक ऐसे मामले से बहुत बदतर हो सकता है जहां एआई मॉडल आउटपुट का उत्पादन नहीं कर रहा है, क्योंकि यह संगठनों को यह महसूस करने में लंबा समय ले सकता है कि उनकी एआई प्रणाली दोषपूर्ण है। फिर, एआई जोखिम एआई विफलता बन जाता है जिसके विनाशकारी परिणाम हो सकते हैं।
रोबस्ट इंटेलिजेंस ने मूल रूप से एक एआई फायरवॉल का डिजाइन किया है, जो पहले असंभव माना जाता था। यह एक तकनीकी चुनौती क्यों है?
एक कारण यह है कि यह एमएल समुदाय के पूर्ववर्ती दृष्टिकोण के खिलाफ जाता है। एमएल समुदाय का पूर्व दृष्टिकोण यह था कि त्रुटियों को समाप्त करने के लिए, आपको मॉडल में अधिक डेटा खिलाना होगा, जिसमें खराब डेटा भी शामिल है। ऐसा करने पर मॉडल स्वयं प्रशिक्षण लेकर अपनी गलतियाँ सुधारना सीखेंगे। इस दृष्टिकोण की समस्या यह है कि यह मॉडल की सटीकता को बहुत कम कर देता है। उदाहरण के लिए, छवियों के लिए सबसे अच्छे परिणाम एआई मॉडल की सटीकता को 98.5% से लगभग 37% तक कम कर देते हैं।
एआई फायरवॉल एक अलग समाधान प्रदान करता है। हम त्रुटि की पहचान करने की समस्या को भविष्यवाणी बनाने की भूमिका से अलग करते हैं, जिसका अर्थ है कि फायरवॉल एक विशिष्ट कार्य पर ध्यान केंद्रित कर सकता है: यह निर्धारित करना कि क्या एक डेटा बिंदु एक त्रुटिपूर्ण भविष्यवाणी का उत्पादन करेगा।
यह एक चुनौती थी क्योंकि यह अनुमान लगाना मुश्किल है कि कोई एक डेटा बिंदु त्रुटि उत्पन्न करेगा या नहीं। मॉडल त्रुटियां करने के कई कारण हैं, इसलिए उन त्रुटियों की भविष्यवाणी करने वाली एक प्रौद्योगिकी बनाना आसान नहीं था। हमें जो इंजीनियर मिले हैं उन्हें हम बहुत भाग्यशाली मानते हैं।
प्रणाली एआई पूर्वाग्रह को रोकने में कैसे मदद कर सकती है?
मॉडल पूर्वाग्रह मॉडल के प्रशिक्षण में इस्तेमाल हुए डेटा और पूर्वानुमान बनाने के लिए इस्तेमाल होने वाले डेटा के बीच विसंगति से उत्पन्न होता है। एआई जोखिम के प्रति वापस जाना, पूर्वाग्रह मौन त्रुटियों से जुड़ा एक प्रमुख मुद्दा है। उदाहरण के लिए, यह अक्सर कम प्रतिनिधित्व वाली आबादी के साथ एक मुद्दा है। एक मॉडल में पूर्वाग्रह हो सकता है क्योंकि इसने उस आबादी का बहुत कम डेटा देखा है, जो मॉडल के प्रदर्शन और इसकी भविष्यवाणियों की सटीकता को नाटकीय रूप से प्रभावित कर सकता है। एआई फायरवॉल संगठनों को इन डेटा विसंगतियों के बारे में अलर्ट कर सकता है और मॉडल को सही निर्णय लेने में मदद कर सकता है।
एआई फायरवॉल संगठनों को किन अन्य जोखिमों से बचाने में मदद कर सकता है?
एआई से निर्णयों को स्वचालित करने वाली कोई भी कंपनी, खासकर महत्वपूर्ण निर्णयों के मामले में, जोखिम भी लाती है। खराब डेटा की त्रुटि 1 के बजाय 0 दर्ज करने जितनी छोटी हो सकती है, फिर भी उसके गंभीर परिणाम हो सकते हैं। चाहे जोखिम गलत चिकित्सा भविष्यवाणी हो या गलत उधार भविष्यवाणी, एआई फायरवॉल संगठनों को जोखिम को रोकने में मदद करता है।
क्या रोबस्ट इंटेलिजेंस के बारे में और कुछ है जो आप साझा करना चाहेंगे?
रोबस्ट इंटेलिजेंस तेजी से बढ़ रहा है और हमें कई अच्छे उम्मीदवार मिल रहे हैं जो पदों के लिए आवेदन कर रहे हैं। लेकिन मैं जो कुछ कहना चाहता हूं वह यह है कि हम जिन उम्मीदवारों की तलाश कर रहे हैं उनमें सबसे महत्वपूर्ण गुण उनका मिशन के प्रति जुनून है। हम कई उम्मीदवारों से मिलते हैं जो तकनीकी रूप से मजबूत हैं, इसलिए यह वास्तव में यह समझने में नीचे आता है कि क्या वे वास्तव में एआई जोखिम को समाप्त करने और दुनिया को एक सुरक्षित और बेहतर स्थान बनाने के लिए उत्साहित हैं।
जिस दुनिया में हम जा रहे हैं, वहां कई निर्णय जो वर्तमान में मानव द्वारा किए जा रहे हैं, स्वचालित किए जाएंगे। चाहे हमें यह पसंद हो या नहीं, यह एक तथ्य है। इसे देखते हुए, रोबस्ट इंटेलिजेंस में हम सभी चाहते हैं कि स्वचालित निर्णय जिम्मेदारी से किए जाएं। इसलिए, कोई भी जो प्रभाव डालने के बारे में उत्साहित है, जो समझता है कि यह लोगों के जीवन को कैसे प्रभावित कर सकता है, वह एक उम्मीदवार है जिसे हम रोबस्ट इंटेलिजेंस में शामिल होने के लिए देख रहे हैं। हम उस जुनून की तलाश कर रहे हैं। हम उन लोगों की तलाश कर रहे हैं जो इस प्रौद्योगिकी का निर्माण करेंगे जिसका उपयोग पूरी दुनिया करेगी।
साक्षात्कार के लिए धन्यवाद, मुझे एआई पूर्वाग्रह रोकने और एआई फायरवॉल की आवश्यकता पर आपके विचार जानकर खुशी हुई, पाठक जो अधिक जानना चाहते हैं उन्हें रोबस्ट इंटेलिजेंस पर जाना चाहिए।









