
Anderson का एंगल
रिगएनआरएफ: एक नया डीपफेक्स तरीका जो न्यूरल रेडिएंस फील्ड्स का उपयोग करता है

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें

मुख्य बिंदुRigNeRF, 3DMM नियंत्रण के साथ न्यूरल रेडिएंस फील्ड्स का उपयोग करने वाली पहली व्यवहार्य…
और देखें
- RigNeRF, 3DMM नियंत्रण के साथ न्यूरल रेडिएंस फील्ड्स का उपयोग करने वाली पहली व्यवहार्य डीपफेक विधि है।
- सिस्टम को प्रशिक्षण के लिए केवल 70 सेकंड के स्मार्टफोन वीडियो की आवश्यकता होती है, श्रमसाध्य ऑटोएनकोडर डेटासेट के विपरीत।
- RigNeRF केवल चेहरा बदलने के बजाय शरीर और पृष्ठभूमि सहित पूर्ण दृश्य संश्लेषण को सक्षम बनाता है।
एडोबी में विकसित नए शोध ने न्यूरल रेडिएंस फील्ड्स (NeRF) पर आधारित पहली व्यावहारिक और प्रभावी डीपफेक्स तरीका प्रदान किया है – शायद 2017 में डीपफेक्स के उदय के बाद पांच वर्षों में वास्तुकला या दृष्टिकोण में पहली वास्तविक नवाचार।
(ADBE )RigNeRF नामक यह तरीका तीन-आयामी रूप बदलने योग्य चेहरे के मॉडल (3DMM) को वांछित इनपुट, यानी NeRF रेंडर में लागू की जाने वाली पहचान, और न्यूरल स्पेस के बीच नियंत्रण की मध्यवर्ती परत बनाता है। जेनरेटिव एडवर्सेरियल नेटवर्क (GAN) से चेहरा-संश्लेषण करने वाले तरीकों में हाल के वर्षों में यह दृष्टिकोण व्यापक रूप से अपनाया गया है, लेकिन लेख के प्रकाशन तक इनमें से कोई वीडियो के लिए कार्यशील और उपयोगी चेहरा-बदलने वाला फ्रेमवर्क नहीं बना पाया था।
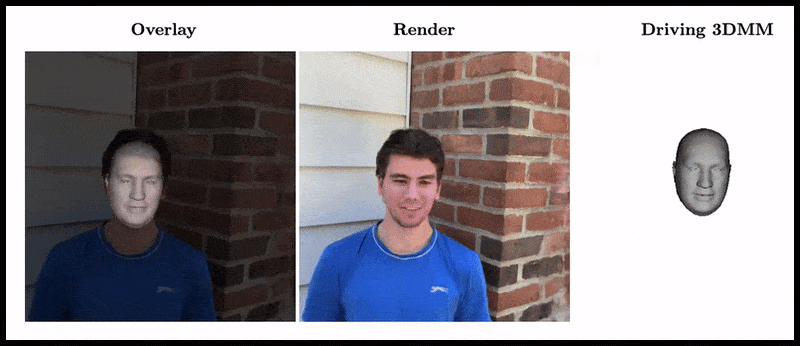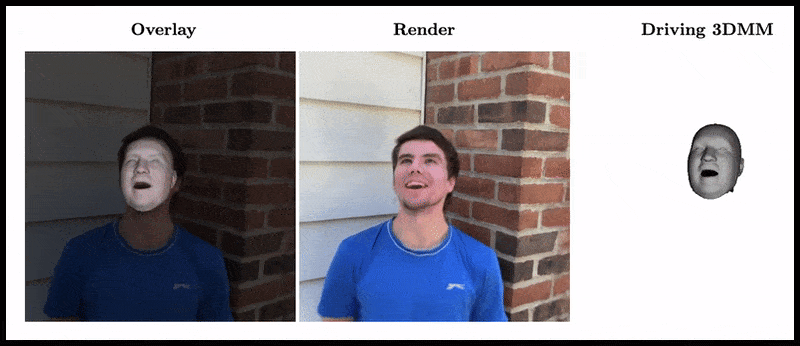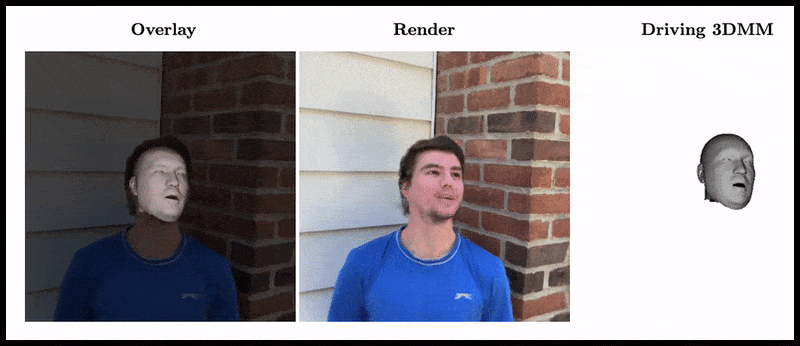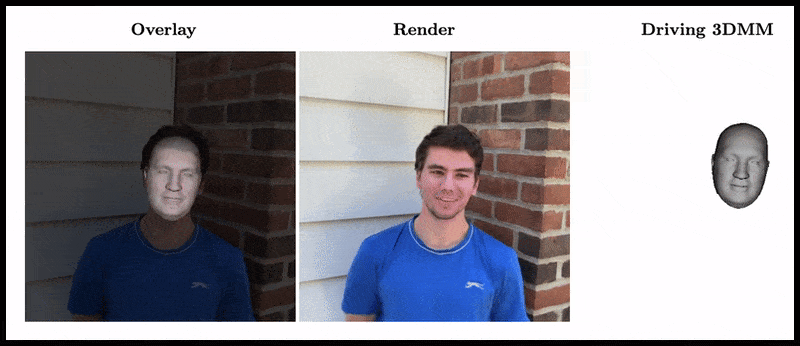
पारंपरिक डीपफेक्स वीडियो के विपरीत, यहाँ दिखाए गए गतिशील सामग्री में से कोई भी ‘वास्तविक’ नहीं है, बल्कि एक अन्वेषणीय न्यूरल स्पेस है जो संक्षिप्त फुटेज पर प्रशिक्षित किया गया है। दाईं ओर हम 3D मोर्फेबल फेस मॉडल (3DMM) को नेरफ विज़ुअलाइज़ेशन के सामान्य-स्तब्ध पैरामीटर और वांछित हेरफेर (‘मुस्कराएं’, ‘बाएं देखें’, ‘ऊपर देखें’, आदि) के बीच एक इंटरफ़ेस के रूप में कार्य करते हुए देखते हैं। इस क्लिप के उच्च-रिज़ॉल्यूशन संस्करण के लिए, साथ ही अन्य उदाहरणों के लिए परियोजना पृष्ठ पर जाएं, या इस लेख के अंत में एम्बेडेड वीडियो देखें। स्रोत: https://shahrukhathar.github.io/2022/06/06/RigNeRF.html स्रोत: https://shahrukhathar.github.io/2022/06/06/RigNeRF.html
3DMMs प्रभावी रूप से फेस के सीजीआई मॉडल हैं, जिनके पैरामीटर को अधिक अमूर्त छवि संश्लेषण प्रणालियों में अनुकूलित किया जा सकता है, जैसे कि नेरफ और GAN, जो अन्यथा नियंत्रित करने में कठिन होते हैं।
उपरोक्त छवि में (मध्य छवि, नीले शर्ट वाला आदमी), साथ ही नीचे की छवि (बाएं, नीले शर्ट वाला आदमी) में, एक ‘वास्तविक’ वीडियो में एक छोटा सा ‘नकली’ चेहरा नहीं है, बल्कि एक पूरी तरह से संश्लेषित दृश्य है जो केवल एक वॉल्यूमेट्रिक न्यूरल रेंडरिंग के रूप में मौजूद है – इसमें शरीर और पृष्ठभूमि भी शामिल है:
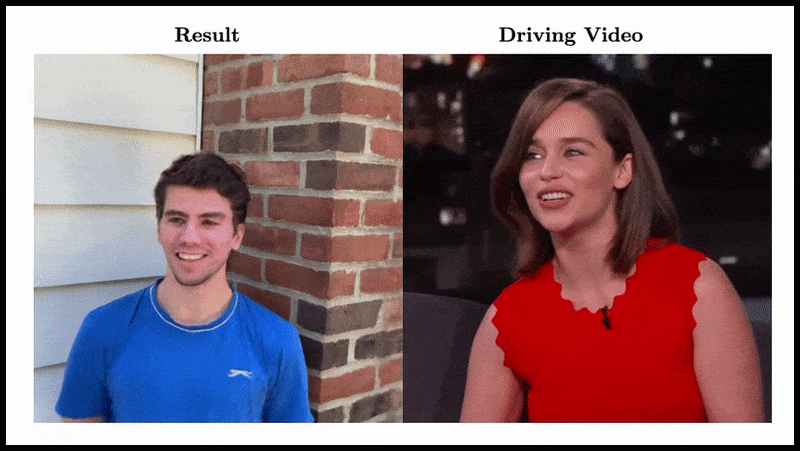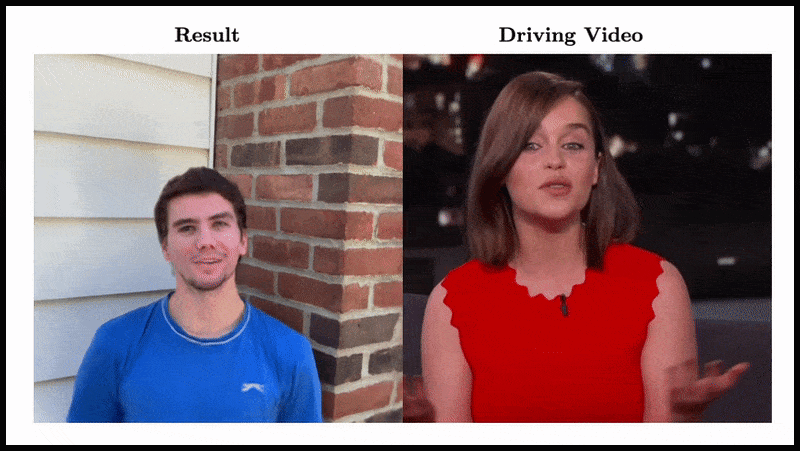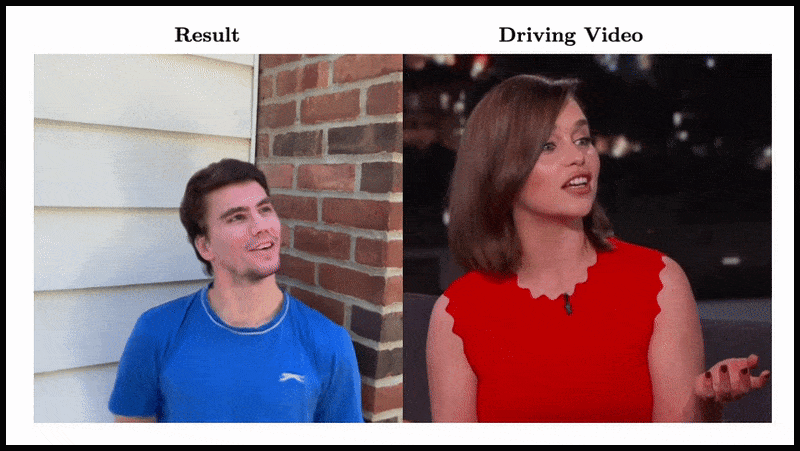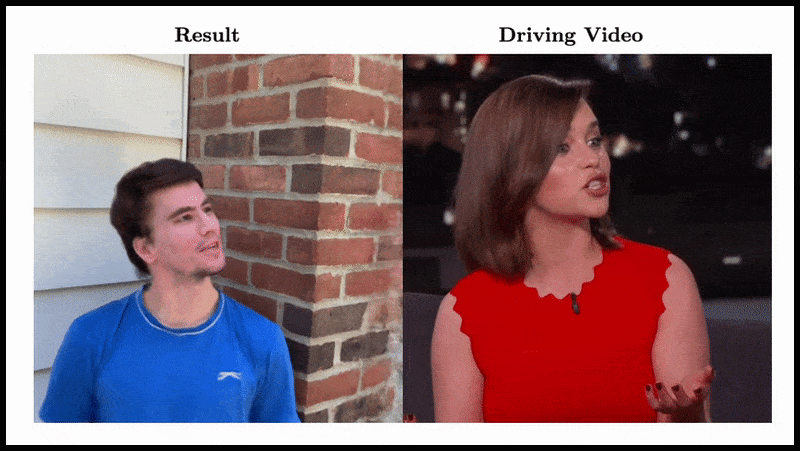
उपरोक्त उदाहरण में, वास्तविक जीवन का वीडियो (लाल पोशाक वाली महिला) रिगएनआरएफ के माध्यम से बाएं (नीले शर्ट वाला आदमी) पर कब्जा किए गए पहचान को ‘पपेट’ करने के लिए उपयोग किया जाता है, जो (लेखकों का दावा है) पहला नेरफ-आधारित प्रणाली है जो मुद्रा और अभिव्यक्ति को अलग करते हुए नए दृश्य संश्लेषण करने में सक्षम है।
उपरोक्त छवि में बाएं स्थित पुरुष को 70 सेकंड के स्मार्टफोन वीडियो से ‘कैप्चर’ किया गया था, और इनपुट डेटा (संपूर्ण दृश्य जानकारी सहित) को 4 वी100 जीपीयू पर प्रशिक्षित किया गया था ताकि दृश्य प्राप्त किया जा सके।
3DMM जैसे पैरामीट्रिक रिग पूरे शरीर के पैरामीट्रिक CGI प्रतिनिधि मॉडल के रूप में भी उपलब्ध हैं, न कि केवल चेहरे के लिए। इसलिए RigNeRF पूरे शरीर के deepfake की संभावना खोल सकता है, जिसमें असली मानव गति, बनावट और अभिव्यक्ति CGI-आधारित पैरामीट्रिक परत को दी जाए और फिर NeRF परिवेश तथा वीडियो में रेंडर हो।
रिगएनआरएफ के बारे में – क्या यह वर्तमान अर्थ में एक डीपफेक्स तरीका के रूप में योग्य है जिस तरह से हेडलाइंस इस शब्द को समझते हैं? या यह केवल डीपफेसलैब और अन्य श्रमसाध्य, 2017-युग के ऑटोएनकोडर डीपफेक्स प्रणालियों के लिए एक और अर्ध-विकलांग भी है?
नया पेपर के शोधकर्ता इस बिंदु पर स्पष्ट हैं:
‘चेहरों को फिर से गतिशील बनाने में सक्षम होने के नाते, रिगएनआरएफ दुर्भावनापूर्ण लोगों द्वारा डीपफेक्स बनाने के लिए दुरुपयोग के लिए प्रवण है।’
नया पेपर शीर्षक रिगएनआरएफ: पूरी तरह से नियंत्रित न्यूरल 3डी पोर्ट्रेट है, और स्टोनीब्रुक विश्वविद्यालय के शाहरुख अथर से आता है, जो रिगएनआरएफ के विकास के दौरान एडोबी में एक इंटर्न था, और एडोबी रिसर्च से चार अन्य लेखक।
ऑटोएनकोडर-आधारित डीपफेक्स से परे
पिछले कुछ वर्षों में सुर्खियों में आए अधिकांश वायरल डीपफेक्स ऑटोएनकोडर-आधारित प्रणालियों द्वारा उत्पादित किए जाते हैं, जो 2017 में प्रतिबंधित r/deepfakes सबरेडिट पर प्रकाशित कोड से व्युत्पन्न होते हैं – हालांकि इससे पहले कि यह गिटहब पर कॉपी किया गया था, जहां यह वर्तमान में एक हजार से अधिक बार फोर्क किया गया है, जिसमें लोकप्रिय (हालांकि विवादास्पद) डीपफेसलैब वितरण भी शामिल है, और फेसस्वैप परियोजना भी।
इसके अलावा GAN और नेरफ, ऑटोएनकोडर फ्रेमवर्क ने भी 3DMMs को चेहरे संश्लेषण फ्रेमवर्क में सुधार के लिए ‘मार्गदर्शक’ के रूप में प्रयोग किया है। जुलाई 2021 का HifiFace प्रोजेक्ट इसका एक उदाहरण है। हालांकि, इस दृष्टिकोण से कोई भी उपयोगी या लोकप्रिय पहल नहीं लगती है जो अब तक विकसित हुई है।
रिगएनआरएफ दृश्यों के लिए डेटा छोटे स्मार्टफोन वीडियो को कैप्चर करके प्राप्त किया जाता है। परियोजना के लिए, रिगएनआरएफ के शोधकर्ताओं ने सभी प्रयोगों के लिए एक आईफोन एक्सआर या एक आईफोन 12 का उपयोग किया। कैप्चर के पहले भाग के लिए, विषय को विभिन्न चेहरे के भाव और बोलते समय अपने सिर को स्थिर रखते हुए विभिन्न चेहरे के भाव करने के लिए कहा जाता है, जबकि कैमरा उनके चारों ओर घूमता है।
कैप्चर के दूसरे भाग के लिए, कैमरा एक निश्चित स्थिति बनाए रखता है, जबकि विषय को विभिन्न अभिव्यक्तियों को प्रदर्शित करते हुए अपना सिर घुमाना होता है। परिणामी 40-70 सेकंड का फुटेज (लगभग 1200-2100 फ्रेम) प्रशिक्षण के लिए उपयोग किए जाने वाले पूरे डेटासेट का प्रतिनिधित्व करता है।
डेटा-संग्रह में कटौती
इसके विपरीत, ऑटोएनकोडर प्रणालियों जैसे डीपफेसलैब को हजारों विविध फोटो के अपेक्षाकृत श्रमसाध्य संग्रह और चयन की आवश्यकता होती है, जो अक्सर यूट्यूब वीडियो और अन्य सोशल मीडिया चैनलों से ली जाती हैं, साथ ही सेलिब्रिटी डीपफेक्स के मामले में फिल्मों से।
परिणामी प्रशिक्षित ऑटोएनकोडर मॉडल अक्सर विभिन्न स्थितियों में उपयोग किए जाने के लिए अभिप्रेत होते हैं। हालांकि, सबसे अधिक उत्साही ‘सेलिब्रिटी’ डीपफेकर एकल वीडियो के लिए पूरी तरह से मॉडल को प्रशिक्षित कर सकते हैं,हालांकि प्रशिक्षण में एक सप्ताह या अधिक का समय लग सकता है।
नए शोध के लेखकों की चेतावनी के बावजूद, AI से बने अश्लील कंटेंट और लोकप्रिय YouTube/TikTok deepfake पुनर्निर्माणों के लिए अलग-अलग स्रोतों से जोड़े गए डेटासेट RigNeRF जैसी दृश्य-विशिष्ट प्रणाली में स्वीकार्य और सुसंगत नतीजे देने की संभावना नहीं रखते। नए काम में बताई गई रिकॉर्डिंग की सीमाएं कुछ हद तक दुर्भावनापूर्ण deepfake निर्माताओं द्वारा पहचान के आसानी से किए जाने वाले अनधिकृत उपयोग के विरुद्ध अतिरिक्त सुरक्षा बन सकती हैं।
डीपफेक्स वीडियो के लिए नेरफ को अनुकूलित करना
नेरफ एक फोटोग्राममेट्री-आधारित विधि है जिसमें विभिन्न दृष्टिकोणों से ली गई छोटी संख्या में स्रोत चित्रों को एक अन्वेषणीय 3डी न्यूरल स्पेस में इकट्ठा किया जाता है। यह दृष्टिकोण इस साल की शुरुआत में प्रमुखता से आया जब एनवीडिया (NVDA ) ने अपनी इंस्टेंट नेरफ प्रणाली का अनावरण किया, जो नेरफ के लिए अत्यधिक प्रशिक्षण समय को मिनटों या यहां तक कि सेकंड तक कम कर सकती है:
इंस्टेंट नेरफ। स्रोत: https://www.youtube.com/watch?v=DJ2hcC1orc4
परिणामी न्यूरल रेडिएंस फील्ड दृश्य मूल रूप से एक स्थिर वातावरण है जिसे अन्वेषण किया जा सकता है, लेकिन जिसे संपादित करना मुश्किल है। शोधकर्ता ध्यान देते हैं कि दो पूर्व नेरफ-आधारित पहल – हाइपरनेरफ + ई/पी और नरफेस – ने चेहरे के वीडियो संश्लेषण का प्रयास किया है, और (स्पष्ट रूप से पूर्णता और दृढ़ता के लिए) रिगएनआरएफ को इन दोनों फ्रेमवर्क के खिलाफ एक परीक्षण दौर में रखा है:
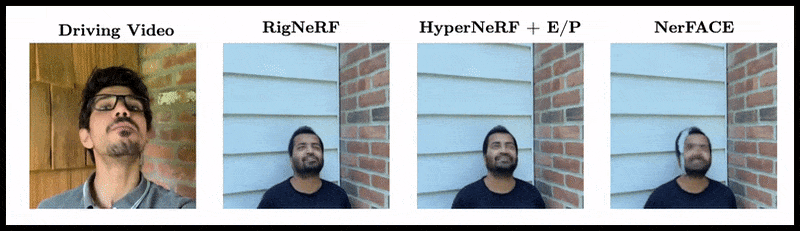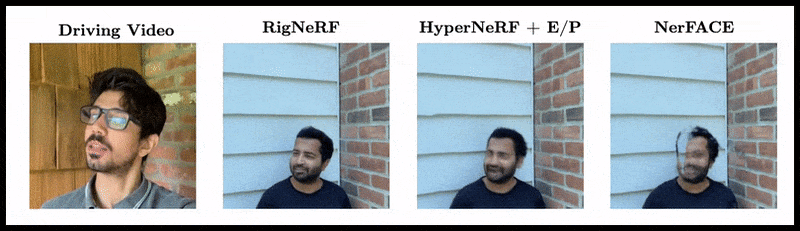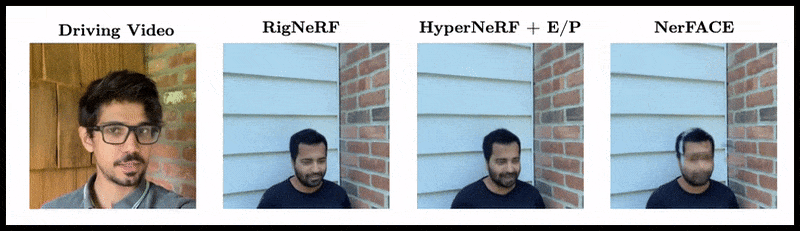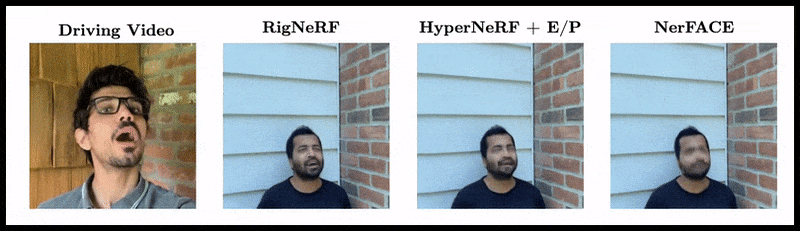
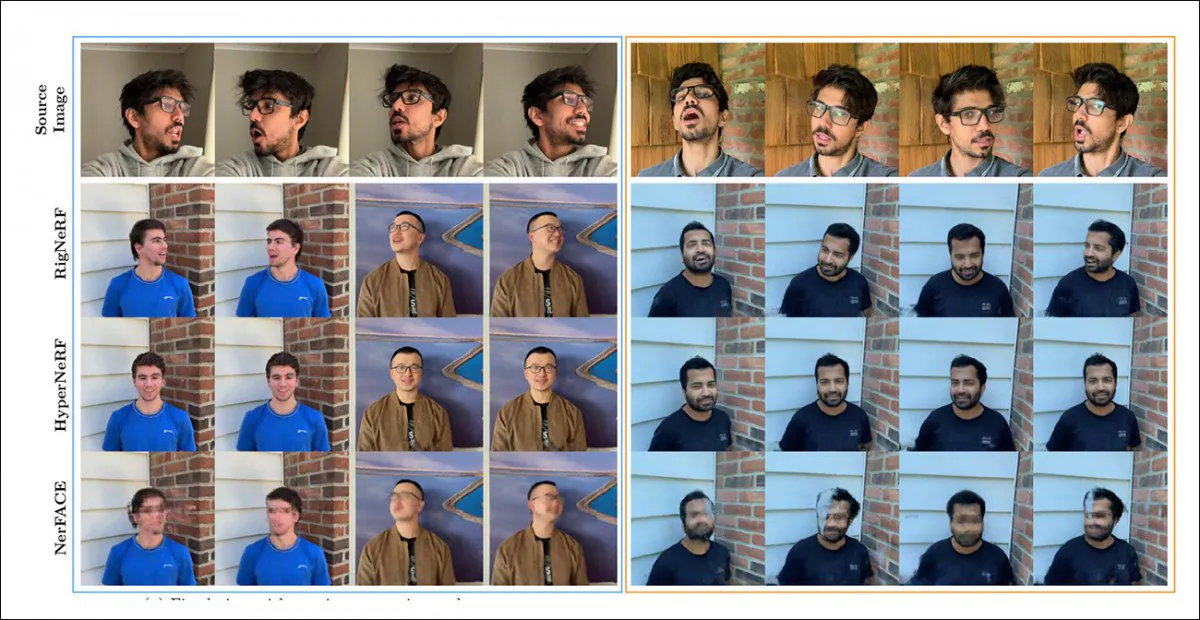
रिगएनआरएफ, हाइपरनेरफ और नरफेस के बीच एक गुणात्मक तुलना। उच्च-गुणवत्ता वाले संस्करण के लिए जुड़े स्रोत वीडियो और पीडीएफ देखें। स्थिर छवि स्रोत: https://arxiv.org/pdf/2012.03065.pdf
हालांकि, इस मामले में परिणाम, जो रिगएनआरएफ को पसंद करते हैं, काफी असामान्य हैं, दो कारणों से: पहला, लेखकों का अवलोकन है कि ‘कोई भी मौजूदा काम एक से एक तुलना के लिए नहीं है’; दूसरा, इस कारण RigNeRF की क्षमताओं को सीमित करना पड़ा ताकि वे पूर्ववर्ती प्रणालियों की अधिक सीमित कार्यक्षमता से कम से कम आंशिक रूप से मेल खा सकें।
चूंकि परिणाम पिछले काम पर एक क्रमिक सुधार का प्रतिनिधित्व नहीं करते हैं, बल्कि नेरफ की संपादनीयता और उपयोगिता में एक ‘ब्रेकथ्रू’ का प्रतिनिधित्व करते हैं, इसलिए हम परीक्षण दौर को अलग रख देंगे और इसके बजाय देखेंगे कि रिगएनआरएफ अपने पूर्ववर्तियों से अलग क्या कर रहा है।
संयुक्त ताकत
NerFACE, जो NeRF परिवेश में मुद्रा और चेहरे की अभिव्यक्ति को नियंत्रित कर सकता है, की प्रमुख सीमा स्थिर कैमरे से स्रोत फुटेज रिकॉर्ड किए जाने की धारणा है। इसलिए यह रिकॉर्डिंग की सीमाओं से आगे के नए दृष्टिकोण नहीं बना सकता। इससे चलायमान पोर्ट्रेट बन सकते हैं, लेकिन deepfake शैली के वीडियो के लिए यह उपयुक्त नहीं है।
हाइपरनेरफ, दूसरी ओर, जबकि नई और हाइपर-वास्तविक दृश्यों का उत्पादन करने में सक्षम है, सिर की मुद्रा या चेहरे के भाव को बदलने की कोई साधन नहीं है, जो फिर से ऑटोएनकोडर-आधारित डीपफेक्स के लिए कोई प्रतिस्पर्धी नहीं है।
रिगएनआरएफ दो अलग-अलग कार्यक्षमताओं को एक ‘कैनोनिकल स्पेस’ बनाकर जोड़ सकता है, एक डिफ़ॉल्ट बेसलाइन जिससे 3DMM मॉड्यूल से इनपुट के माध्यम से विचलन और विकृतियाँ की जा सकती हैं।

एक ‘कैनोनिकल स्पेस’ (न मुद्रा, न चेहरे की अभिव्यक्ति) बनाना, जिस पर 3DMM द्वारा उत्पादित विकृतियाँ (अर्थात मुद्रा और अभिव्यक्तियाँ) कार्य कर सकती हैं।
चूंकि 3DMM प्रणाली कब्जा किए गए विषय के साथ बिल्कुल मेल नहीं खाएगी, इसलिए इस प्रक्रिया में इसके लिए क्षतिपूर्ति करना महत्वपूर्ण है। RigNeRF विकृति-क्षेत्र के पूर्वज्ञान का उपयोग करके इसकी भरपाई करता है, जिसकी गणना स्रोत फुटेज से व्युत्पन्न एक मल्टीलेयर परसेप्ट्रॉन (एमएलपी) से व्युत्पन्न होता है।

विकृतियों की गणना के लिए आवश्यक कैमरा पैरामीटर कोलमैप के माध्यम से प्राप्त किए जाते हैं, जबकि प्रत्येक फ्रेम के लिए अभिव्यक्ति और आकार पैरामीटर डीईसीए से प्राप्त किए जाते हैं।
स्थिति को लैंडमार्क फिटिंग और कोलमैप के कैमरा पैरामीटर के माध्यम से आगे अनुकूलित किया जाता है, और, कंप्यूटिंग संसाधन प्रतिबंधों के कारण, वीडियो आउटपुट को प्रशिक्षण के लिए 256×256 रिज़ॉल्यूशन में डाउनसैंपल किया जाता है (एक हार्डवेयर-निर्धारित संकुचन प्रक्रिया जो ऑटोएनकोडर डीपफेकिंग दृश्य को भी प्रभावित करती है)।
इसके बाद, विकृति नेटवर्क को चार वी100 पर प्रशिक्षित किया जाता है – एक शक्तिशाली हार्डवेयर जो सामान्य शौकिया लोगों की पहुंच में होने की संभावना कम है (हालांकि, जहां मशीन लर्निंग प्रशिक्षण का संबंध है, यह अक्सर संभव होता है कि कम कंप्यूटिंग शक्ति के बदले अधिक प्रशिक्षण समय स्वीकार किया जाए और मॉडल प्रशिक्षण को दिनों या सप्ताहों का विषय बनाया जाए)।
निष्कर्ष में, शोधकर्ता कहते हैं:
‘अन्य तरीकों के विपरीत, रिगएनआरएफ, 3DMM-निर्देशित विकृति मॉड्यूल का उपयोग करके, सिर की मुद्रा, चेहरे के भाव और पूरे 3D पोर्ट्रेट दृश्य को उच्च विश्वसनीयता के साथ मॉडल करने में सक्षम है, जिससे स्पष्ट सूक्ष्म विवरण के साथ बेहतर पुनर्निर्माण होता है।’
विस्तृत विवरण और परिणाम फुटेज के लिए नीचे दिए गए एम्बेडेड वीडियो देखें。
पहली बार 15 जून 2022 को प्रकाशित।


