
Anderson का एंगल
नजर से दूर, याद से दूर: AI वीडियो की सबसे बड़ी समस्या से निपटना

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें
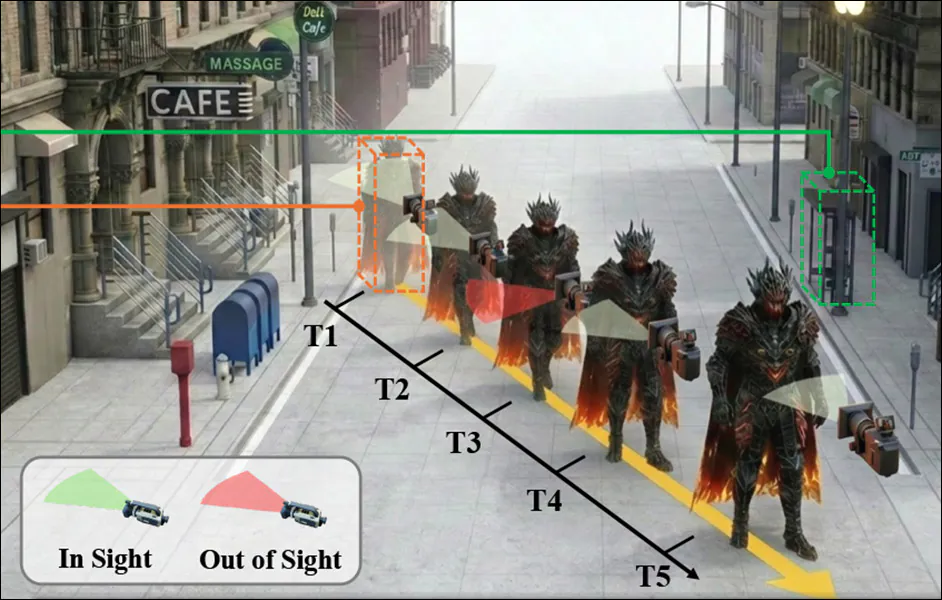
मुख्य बिंदुएक नई हाइब्रिड मेमोरी प्रणाली ऑफ-स्क्रीन पात्रों को सुसंगत रखकर एआई वीडियो की…
और देखें
- एक नई हाइब्रिड मेमोरी प्रणाली ऑफ-स्क्रीन पात्रों को सुसंगत रखकर एआई वीडियो की दीर्घकालिक स्मृति हानि को हल करती है।
- यह विधि उपस्थिति और गति को बनाए रखने के लिए निकास के दौरान मेमोरी टोकनाइजेशन और डायनामिक पुनर्प्राप्ति का उपयोग करती है।
- हाइड्रा लेटेंट स्पेस में गतिशील विषयों को स्थिर पृष्ठभूमि से अलग करके पिछले दृष्टिकोणों से बेहतर प्रदर्शन करता है।
बेहतरीन AI वीडियो जनरेटरों की भी सबसे बड़ी समस्या लगातार भूलते रहना है। चीन का एक नया शोध अब इसी चुनौती का समाधान तलाश रहा है।
बेहतरीन और अत्याधुनिक AI वीडियो निर्माण प्रणालियों की सबसे बड़ी समस्या यह है कि वे सभी लगातार स्मृतिलोप से ग्रस्त हैं। कैमरा जिस वस्तु पर केंद्रित है, उससे हटकर वापस लौटे तो शुरुआत में मौजूद दृश्य फिर नहीं मिलता। पात्र गायब हो चुके होते हैं या उनका रूप अथवा चलने का ढंग बदल जाता है। पृष्ठभूमि भी संभवतः बदल चुकी होती है।
इसका कारण यह है कि डिफ्यूजन आधारित निर्माण प्रणाली के पास सीमित, खिसकती हुई अटेंशन विंडो होती है और वह हमेशा उसी समय दिखाई देने वाली चीजों को ही संभालती है। यह मानो सॉलिप्सिज्म का वास्तविक प्रदर्शन है: फ्रेम के बाहर की चीजें जनरेटिव AI के लिए अस्तित्वहीन हैं और सचमुच उसकी स्मृति से निकाल दी जाती हैं।
यह पारंपरिक CGI में कभी समस्या नहीं रही। उसमें रेंडर किए गए वीडियो के किसी भी बिंदु पर किसी विषय की फिर जरूरत हो तो उसके रूप और गति समेत उसे संदर्भ से सटीक दोबारा बनाया जा सकता है।

पारंपरिक CGI मेश और बिटमैप टेक्सचर को हमेशा रेंडर में फिर शामिल करके एक जैसा रूप बनाए रखा जा सकता है। AI विधियों में यह बहुत कठिन है, क्योंकि वैसी स्वतंत्र संदर्भ फाइल या संबंधित फाइलों का समूह नहीं होता।
CGI के घटक, जैसे मेश और टेक्सचर (ऊपर का चित्र देखें), गति की फाइलें और अन्य गतिशील व्यवहार डिस्क पर अलग-अलग रखे जा सकते हैं और कभी भी कंपोजिशन में शामिल किए जा सकते हैं।
जनरेटिव वीडियो AI में ऐसा स्वतंत्र संदर्भ भंडार नहीं है। इस सुविधा के सबसे करीब LoRA हैं। ये विशेष रूप से प्रशिक्षित सहायक फाइलें हैं जिन्हें सामान्य उपभोक्ता हार्डवेयर पर प्रशिक्षित किया जा सकता है। इनके जरिए नए पात्रों और खास कपड़ों को वीडियो में जबरन शामिल किया जा सकता है।
चलाने के लिए क्लिक करें। LoRA से AI वीडियो की सॉलिप्सिज्म वाली समस्या कुछ हद तक घट सकती है, लेकिन उनका असर जरूरत से ज्यादा हावी हो सकता है।
फिर भी यह आदर्श समाधान नहीं है। एक तो LoRA किसी आधार मॉडल के ठीक एक विशिष्ट संस्करण से जुड़े होते हैं, जैसे Wan2+ या Hunyuan Video। आधार मॉडल बदलते ही इन्हें दोबारा बनाना पड़ता है। दूसरे, LoRA आधार मॉडल के वेट्स को विकृत कर सकते हैं, जिससे सीखी गई पहचान दृश्य के सभी पात्रों पर थोप दी जाती है। इसके अलावा इस तरह की फाइन-ट्यूनिंग विधियां खराब ढंग से तैयार डेटासेट के प्रति बहुत संवेदनशील होती हैं।
सटीक वापसी
चीन की एक नई अकादमिक और औद्योगिक साझेदारी अब वह पहला महत्वपूर्ण समाधान दे रही है जिस पर इस समस्या के बारे में तीन साल से अधिक समय से लिखते हुए मेरा ध्यान गया है। शोधकर्ता जिस व्यवस्था को हाइब्रिड मेमोरी कहते हैं, वह स्क्रीन से बाहर के पात्र और उसके आसपास के परिवेश को मॉडल के लेटेंट स्पेस में सक्रिय और सटीक रखती है। इसलिए नजर वापस उन पर लौटने पर परिणाम एक जैसा रहता है।
चलाने के लिए क्लिक करें। नए शोध की परियोजना वेबसाइट के दो उदाहरण: AI से बने WAN पात्र फ्रेम से बाहर जाते हैं और सटीक रूप में वापस आते हैं। स्रोत
यह स्पष्ट करना जरूरी है कि यह अलग-अलग शॉट में पात्र की एकरूपता बनाए रखने जैसी बात नहीं है। बाद वाली उपलब्धि का दावा Runway के Gen 4 संस्करण में एक साल पहले किया गया था और शोध साहित्य में यह अब भी लगातार तलाशा जाने वाला लक्ष्य है।
यहां जो समस्या सुलझाई गई है, उसे मैंने किसी व्यावसायिक या प्रायोगिक फ्रेमवर्क को सुलझाते नहीं देखा: स्क्रीन से बाहर के पात्र के पिछले रूप, गति और परिवेश का दृश्य रूप से एक जैसा दोबारा प्रकट होना।
चलाने के लिए क्लिक करें। नई पहल की परियोजना वेबसाइट पर दिए गए दो अन्य मुख्य उदाहरण।
स्पष्ट है कि यही सिद्धांत दूसरे क्षेत्रों में भी लागू हो सकते हैं, जैसे शहरों की खोज, चालक के नजरिए से ड्राइविंग या पात्रों के बिना दूसरे प्रकार की रेंडरिंग।
यह भी स्पष्ट करना जरूरी है कि यह नया तरीका उस समस्या को हल नहीं करता और न ही संबोधित करता है जिसे Runway Gen4 तथा दूसरे बंद-स्रोत प्लेटफॉर्म अलग-अलग शॉट में पात्रों को दोबारा बनाकर सुलझाने का दावा करते हैं। इसके बजाय यह वह काम करता है जो उनमें से किसी ने अब तक नहीं किया: पात्र और परिवेश को स्मृति में रखना, उन्हें हर समय दर्शक को दिखाई देते रहना जरूरी बनाए बिना।
इस काम में Unreal Engine से तैयार विशेष डेटासेट, सॉलिप्सिज्म की समस्या* के लिए खास मापदंड और WAN पर बना अनुकूलित जनरेटिव फ्रेमवर्क शामिल हैं। उपलब्ध कुछ मिलती-जुलती प्रणालियों से तुलना में लेखक अत्याधुनिक परिणामों का दावा करते हैं और कहते हैं:
“स्मृति तंत्र विश्व मॉडलों को आगे बढ़ाने का महत्वपूर्ण मोर्चा बन गए हैं, क्योंकि स्मृति क्षमता उत्पन्न सामग्री की स्थानिक और समयगत एकरूपता तय करती है।
“विशेष रूप से स्मृति वह संज्ञानात्मक आधार है जो नजरिया बदलने या लंबी अवधि का अनुमान लगाने के दौरान मॉडल को पिछले संदर्भ को बनाए रखने देता है।
“मजबूत स्मृति के बिना अनुकरण की गई दुनिया जल्दी ही असंबद्ध, अव्यवस्थित फ्रेम में बिखर जाती है।”
इस नए शोधपत्र का शीर्षक है Out of Sight but Not Out of Mind: Hybrid Memory for Dynamic Video World Models। इसे Huazhong University of Science and Technology और Kuaishou Technology की Kling टीम के सात शोधकर्ताओं ने तैयार किया है।
विधि
नए काम का केंद्र हाइब्रिड मेमोरी है, जो नजर से बाहर की स्थिति का अनुमान लगाना संभव बनाती है। दर्शक दूसरी ओर देखे या पात्र खुद फ्रेम से निकल जाए, तब भी पात्र और उसका संदर्भ बनाए रखा जाता है। इसके लिए फ्रेमवर्क को स्थान और समय का पृथक्करण करना होता है: उसे दर्शक को दिखाई देने वाले दृश्य के निर्माण और अब अदृश्य पात्र के फ्रेम के बाहर अस्तित्व, दोनों पर एक साथ ध्यान देना होता है।

पात्र के फ्रेम में आने-जाने वाली कैमरा गति के उदाहरण। यहां कैमरे की गति पात्र को फ्रेम से बाहर ले जाती है, लेकिन दूसरे नमूनों में पात्र खुद भी कुछ समय के लिए स्क्रीन से बाहर जाता दिखता है। स्रोत
लेखक बताते हैं कि डिफ्यूजन की लेटेंट एम्बेडिंग में निकालकर इस्तेमाल की जाने वाली विशेषताएं दूसरी विशेषताओं और गुणों से गहराई से उलझी हुई होती हैं। उन्हें निकालने का प्रयास अक्सर विषय को पृष्ठभूमि में जमाकर रख देता है। इसलिए उन्होंने खास तौर पर हाइब्रिड मेमोरी के प्रशिक्षण के लिए HM-World डेटासेट** तैयार और व्यवस्थित किया।

शोधपत्र में दिए गए HM-World डेटासेट की चार श्रेणियों के नमूने।
यह संग्रह चार आयामों पर बना है: विषयों के गति-पथ, कैमरे के गति-पथ, दृश्य और विषय।
HM-World के कृत्रिम डेटा में 17 दृश्य और 49 विषय हैं। इनमें अलग-अलग रूप वाले लोग और कई प्रजातियों के जानवर शामिल हैं। इनके संयोजनों को Unreal Engine से प्रक्रियात्मक ढंग से दृश्य में रखा जाता है, हर एक को अलग गति एनीमेशन दिया जाता है और फिर यादृच्छिक रूप से चुने गए गति-पथ पर चलाया जाता है।
लेखक कहते हैं कि डेटासेट में कई तरह की निकास-प्रवेश घटनाएं हैं। इसमें 28 अलग कैमरा गति-पथ हैं और हर पथ के कई शुरुआती बिंदु हैं।
अंतिम संग्रह में 59,225 वीडियो क्लिप हैं। हर क्लिप को MiniCPM-V मल्टीमॉडल लार्ज लैंग्वेज मॉडल (MLLM) से एनोटेट किया गया है।
शोधकर्ता अपने संग्रह की सांख्यिकीय खूबियों की तुलना इन पुराने डेटासेट से करते हैं: WorldScore, Context-As-Memory, Multi-Cam Video और 360° Motion।

मौजूदा डेटासेट और HM-World की तुलना। ‘Dynamic Subject’ चलती इकाइयों की मौजूदगी, ‘Subject Exit-Enter’ विषयों के फ्रेम से निकलकर वापस आने वाले क्लिप और ‘Subject Pose’ एनोटेट किए गए 3D पोज के शामिल होने को दर्शाता है।
कम अपनाया गया रास्ता
पिछले कुछ फ्रेम और कैमरे का ज्ञात रास्ता मिलने पर काम यह है कि दर्शक का नजरिया बदलते समय आगे के दृश्यों का अनुमान लगाया जाए। साथ ही स्वतंत्र रूप से चलने वाले ऐसे विषयों को भी ध्यान में रखना है जो फ्रेम से निकलकर वापस आ सकते हैं। केवल स्थिर पृष्ठभूमि बनाए रखना पर्याप्त नहीं है। मॉडल को हर चलते विषय के रूप और व्यवहार का एक सुसंगत आंतरिक रिकॉर्ड तब भी रखना होगा जब वह दिखाई नहीं दे रहा हो।
लेखकों की Hybrid Dynamic Retrieval Attention (HyDRA) विधि एक विशेष मेमोरी मार्ग जोड़कर इसे संभालती है। यह गतिशील विषयों को दृश्य के स्थिर प्रतिनिधित्व से अलग करता है, ताकि वे समय के साथ बने रहें और एक जैसे रूप व गति के साथ लौटें।

HyDRA मॉडल की अवधारणात्मक रूपरेखा।
HyDRA, Wan2.1-T2V-1.3B पर आधारित है। मूल डिफ्यूजन पाइपलाइन को काफी हद तक जस का तस रखा गया है, लेकिन संशोधित ट्रांसफॉर्मर ब्लॉक में डायनामिक रिट्रीवल अटेंशन जोड़ी गई है। इससे मॉडल किसी तय या स्थानीय संदर्भ पर निर्भर रहने के बजाय पिछले फ्रेम से गति और रूप के संकेत चुनकर याद कर सकता है।
इस प्रक्रिया में अनुकूलित Flow Matching प्रशिक्षण उद्देश्य का इस्तेमाल सामान्य डिफ्यूजन लॉस के स्थान पर किया जाता है।
दृश्यों को कैमरा गति के अनुरूप रखने के लिए कैमरे के गति-पथ स्पष्ट कंडीशनिंग संकेत के रूप में दिए जाते हैं। हर फ्रेम की मुद्रा घूर्णन और स्थानांतरण से परिभाषित होती है और फिर ऐसे संक्षिप्त प्रतिनिधित्व में बदलती है जो समय के साथ नजरिए का विकास पकड़ता है।
Kling की पिछली ReCamMaster पहल की तरह परिणाम को फिर कैमरा एनकोडर संसाधित करता है। इसे मल्टी-लेयर परसेप्ट्रॉन के रूप में लागू किया गया है। इसका आउटपुट प्रसारित होकर Diffusion Transformer की विशेषताओं में जुड़ता है, जिससे मॉडल कैमरे के चलने पर भी वस्तुओं की स्थिति एक जैसी रख सकता है।
टोकनाइजेशन
कच्चे डिफ्यूजन लेटेंट विषय की गति, रूप और पृष्ठभूमि को एक उलझे हुए प्रतिनिधित्व में मिला देते हैं। इस स्पेस से सीधे पुनर्प्राप्ति करने पर असंबंधित संदर्भ आ सकता है या चलते विषय पृष्ठभूमि में मिल सकते हैं।
HyDRA इसके लिए स्थान और समय को साथ संसाधित करने वाला 3D-कन्वोल्यूशन आधारित Memory Tokenizer इस्तेमाल करता है। वह पूरे लेटेंट इतिहास को आगे भेजने के बजाय उसे छोटे, गति को समझने वाले मेमोरी टोकन में समेटता है, जो विषयों का रूप और गति बचाए रखते हैं।

HyDRA का अवलोकन। बाईं ओर Memory Tokenizer पिछले फ्रेम को छोटे, गति को समझने वाले मेमोरी टोकन में बदलता है। दाईं ओर Dynamic Retrieval Attention वर्तमान क्वेरी की इन टोकन से तुलना करके सबसे प्रासंगिक टोकन लाती है और उत्पन्न फ्रेम में एक जैसा रूप व गति बहाल करती है।
ये टोकन संरचित हाइब्रिड मेमोरी बनाते हैं जो शोर छांटते हुए लंबे समय की गतिशीलता बनाए रखती है। Dynamic Retrieval Attention मॉड्यूल में दिए जाने पर वे मॉडल को स्क्रीन के बाहर के विषय चुनकर याद करने देते हैं, ताकि वे एक जैसे रूप, गति और संदर्भ के साथ लौटें।
डायनामिक रिट्रीवल अटेंशन
HyDRA का दोहरा मेमोरी तंत्र डायनामिक रिट्रीवल अटेंशन को भी फ्रेमवर्क में अलग लेकिन पूरक भूमिका में इस्तेमाल करता है।
मेमोरी टोकनाइजेशन पिछले लेटेंट प्रतिनिधित्व को संरचित, गति को समझने वाले टोकन में समेटता है। वे गतिशील विषयों को स्थिर दृश्य-सामग्री से अलग करते हैं और उस उलझाव को घटाते हैं जो अक्सर विषयों को पृष्ठभूमि में मिला देता है। ये टोकन पूरे फ्रेम इतिहास के बजाय एक स्थायी मेमोरी बैंक बनाते हैं।
निर्माण के दौरान डायनामिक रिट्रीवल अटेंशन इस बैंक में वर्तमान क्वेरी की संग्रहित टोकन से तुलना करती है और बदलते फ्रेम के लिए सबसे प्रासंगिक टोकन चुनती है। इससे स्क्रीन के बाहर के विषय अपना लेटेंट विकास जारी रख सकते हैं, यानी दिखाई न देने पर भी चल या दौड़ सकते हैं। वापस लौटने पर वे रीसेट या खराब होने के बजाय एक जैसे रूप और गति के साथ दिखाई देते हैं।
डेटा और परीक्षण
परीक्षणों में Wan आधारित HyDRA प्रणाली ने 77 संदर्भ फ्रेम को एन्कोड और डाउनसैंपल किया, फिर उन्हें 3D वैरिएशनल ऑटोएनकोडर (VAE) से संसाधित किया। ऊपर बताए गए मेमोरी टोकनाइज़र ने 3D कन्वोल्यूशन का इस्तेमाल किया, जिसका कर्नेल आकार 2×4×4 था।
मॉडल को HW-World पर 10,000 पुनरावृत्तियों के लिए ऐसे 32 GPU पर प्रशिक्षित किया गया जिनका प्रकार नहीं बताया गया है। बैच आकार 32 था।
परीक्षणों में असामान्य रूप से अधिक मापदंड थे। सामान्य पीक सिग्नल-टू-नॉइज रेशियो (PSNR), स्ट्रक्चरल सिमिलैरिटी इंडेक्स (SSIM) और लर्न्ड परसेप्चुअल सिमिलैरिटी मीट्रिक (LPIPS) के अलावा लेखकों ने विषय की एकरूपता और पृष्ठभूमि की एकरूपता को VBench सूट से लेकर फ्रेम स्तर की सुसंगतता परखी।
उन्होंने Dynamic Subject Consistency (DSC) नामक अपना मापदंड भी बनाया। यह YOLO V11 के बाउंडिंग बॉक्स से चलते विषयों वाले हिस्से क्रॉप करता है। उनसे अर्थ-संबंधी विशेषताएं निकाली जाती हैं और उनकी समानता गणना की जाती है।
HyDRA की तुलना Diffusion Forcing Transformer (DFoT) और Context-As-Memory से की गई। आधार के तौर पर कैमरा एनकोडर से लैस Wan2.1-T2V-1.3B इस्तेमाल हुआ, ताकि सभी क्लिप में साझा व्यक्तिपरक नजरिए का प्रतिनिधित्व हो। सभी मॉडल HW-World पर प्रशिक्षित किए गए और WorldPlay को जीरो-शॉट तरीके से दूसरे परीक्षण संग्रह के रूप में भी इस्तेमाल किया गया।
शुरुआती मात्रात्मक तुलना में HyDRA ने सभी आधार मॉडलों को पीछे छोड़ा। PSNR 18.696 से बढ़कर 20.357 और SSIM 0.517 से 0.606 हुआ। संदर्भ आधारित और वास्तविक मान आधारित Dice स्कोर भी सबसे अधिक, क्रमशः 0.827 और 0.849 रहे। विषय और पृष्ठभूमि की एकरूपता 0.926 और 0.932 तक पहुंची।

पुरानी विधियों से शुरुआती मात्रात्मक तुलना के परिणाम।
DFoT का PSNR 17.693 और Context-As-Memory का 18.921 रहा। सुधार का श्रेय मेमोरी टोकनाइजेशन और डायनामिक रिट्रीवल अटेंशन के मेल को दिया गया।

HyDRA और मौजूदा अत्याधुनिक तरीकों की मात्रात्मक तुलना।
WorldPlay से तुलना वाले परीक्षणों के बारे में लेखक कहते हैं:
“हमारी विधि सभी मापदंडों में WorldPlay से आगे है और PSNR में उल्लेखनीय 5.502 का अंतर है। डोमेन वितरण के अंतर और खास फाइन-ट्यूनिंग की कमी के कारण WorldPlay वास्तविक मान आधारित मापदंडों पर कम प्रदर्शन दिखाता है, जैसे PSNR 14.855 और DSCGT 0.832। फिर भी संदर्भ आधारित मापदंडों में DSCctx 0.822 हासिल करके वह उल्लेखनीय मजबूती दिखाता है।
“यह अवलोकन न केवल पुष्टि करता है कि बड़े पैमाने पर प्रशिक्षित मॉडल पर्याप्त हाइब्रिड एकरूपता रखते हैं, बल्कि गतिशील विषय की एकरूपता दर्शाने के लिए हमारे प्रस्तावित DSC मापदंडों की तार्किकता का अप्रत्यक्ष समर्थन भी करता है।
“अंततः ये प्रभावशाली परिणाम हमारे मॉडल की असाधारण क्षमता दिखाते हैं और स्थापित व्यावसायिक मॉडलों पर भी उसकी श्रेष्ठता प्रदर्शित करते हैं।”
शोधपत्र परीक्षणों में की गई गुणात्मक तुलनाओं के स्थिर चित्र भी देता है।

कैमरे की गति के दौरान निकास और पुनः प्रवेश की गुणात्मक तुलना। लेखक दावा करते हैं कि HyDRA विषय के बाहर जाने और लौटने के बाद भी उसकी पहचान, मुद्रा और गति की निरंतरता बचाए रखता है और वास्तविक संदर्भ के करीब रहता है। दूसरे तरीकों में विचलन, असंगत गति या विषय का बिगड़ना दिखता है, जिन्हें लाल रंग से चिह्नित किया गया है। एक जैसे पुनर्निर्माण हरे रंग में हैं।
इन परिणामों पर लेखक टिप्पणी करते हैं:
“जटिल निकास-प्रवेश घटनाओं में आधार मॉडल और Context-as-Memory विषय में गंभीर विकृति और गति की असंगति दिखाते हैं। DFoT विषय की अखंडता नहीं बचा पाता और वह पूरी तरह गायब हो जाता है। WorldPlay रूप की एकरूपता रखता है, लेकिन उसकी चाल रुक-रुककर होती है और क्रियाएं अस्वाभाविक होती हैं।
“इसके विपरीत हमारी विधि सफलतापूर्वक हाइब्रिड एकरूपता बनाए रखती है और विषय के फ्रेम में लौटने के बाद उसकी पहचान तथा गति, दोनों की सुसंगतता बचाती है।”
आगे के परिणाम वीडियो के रूप में पूरक वेबसाइट पर देखे जा सकते हैं। हमने पहले चार उदाहरणों को नीचे के वीडियो में जोड़ा है।
चलाने के लिए क्लिक करें। परियोजना वेबसाइट के छह परीक्षण परिणामों में से चार। स्रोत
निष्कर्ष
AI वीडियो निर्माण की सबसे बड़ी कठिनाइयों में से एक को हल करने की हर कोशिश स्वागत योग्य है। फिर भी मुझे लगता है कि इस तरह के बाहर जाने और लौटने के मुद्दों का सर्वोत्तम समाधान अंततः CGI जैसा ही होगा: अलग संदर्भ सामग्री, जिसे स्वतंत्र रूप से संपादित करके कंपोजिशन स्पेस में लाया जा सके।
किसी एम्बेडिंग को तदर्थ ढंग से और निर्माण के दौरान जीवित रखने की यह कोशिश थकाऊ लगती है। यह Runway जैसे विभिन्न ब्लैक-बॉक्स सेवाओं पर अब मिलने वाली एक शॉट के भीतर की एकरूपता की ओर भी कोई स्पष्ट रास्ता नहीं दिखाती। अगर अगले शॉट को पिछले शॉट के लेटेंट स्पेस तक पहुंचना जरूरी हो, तो दोनों इंस्टेंस अपनी अलग और स्वतंत्र पात्र एम्बेडिंग क्यों न रखें?
* किसी और ने इसका नाम नहीं रखा है और साझा शब्दावली के बिना चर्चा कठिन है।
** परियोजना पेज पर फिलहाल इसे ‘जल्द आ रहा है’ बताया गया है।
पहली बार शुक्रवार, 27 मार्च 2026 को प्रकाशित।


