
एआई मॉडल और प्लेटफ़ॉर्म
जनरेटिव एआई: ChatGPT, DALL-E, Midjourney और अन्य तकनीकों के पीछे का विचार

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें

मुख्य बिंदुजनरेटिव एआई मॉडल जैसे जीपीटी-4 डेटा पैटर्न से नई सामग्री बनाते हैं, न कि केवल आउटपुट की…
और देखें
- जनरेटिव एआई मॉडल जैसे जीपीटी-4 डेटा पैटर्न से नई सामग्री बनाते हैं, न कि केवल आउटपुट की भविष्यवाणी करते हैं।
- ट्रांसफॉर्मर आर्किटेक्चर का ध्यान तंत्र एआई को श्रेष्ठ भाषा निर्माण के लिए प्रासंगिक पाठ भागों पर केंद्रित करने की अनुमति देता है।
- डिफ्यूजन मॉडल जैसे डॉल-ई 2 टेक्स्ट प्रॉम्प्ट का उपयोग करके शोर को चरणबद्ध तरीके से छवियों में परिष्कृत करते हैं।
कला, संचार और हम वास्तविकता को कैसे देखते हैं, इसकी दुनिया तेजी से बदल रही है। यदि हम मानव नवाचार के इतिहास पर वापस देखते हैं, तो हम पहिये के आविष्कार या बिजली की खोज को एक महान छलांग मान सकते हैं। आज, एक नई क्रांति हो रही है – मानव रचनात्मकता और मशीन गणना के बीच की खाई को पाटना। यह जनरेटिव एआई है।
जनरेटिव मॉडल ने मानव और मशीन के बीच की रेखा को धुंधला कर दिया है। जीपीटी-4 जैसे मॉडल के आगमन के साथ, जो ट्रांसफॉर्मर मॉड्यूल का उपयोग करता है, हम प्राकृतिक और संदर्भ-समृद्ध भाषा उत्पादन के करीब पहुंच गए हैं। इन प्रगति ने दस्तावेज़ निर्माण, चैटबॉट संवाद प्रणाली और यहां तक कि सिंथेटिक संगीत रचना में अनुप्रयोगों को ईंधन दिया है।
हाल के बिग-टेक निर्णय इसके महत्व को रेखांकित करते हैं। माइक्रोसॉफ्ट (MSFT ) इस महीने अपने कोर्टाना ऐप को बंद कर रहा है ताकि वह नए जनरेटिव एआई नवाचारों पर ध्यान केंद्रित कर सके, जैसे कि बिंग चैट। एप्पल (AAPL ) ने भी अपने $22.6 बिलियन आरएंडडी बजट का एक महत्वपूर्ण हिस्सा जनरेटिव एआई में समर्पित किया है, जैसा कि सीईओ टिम कुक द्वारा संकेत दिया गया है।
एक नए युग की मॉडल: जनरेटिव बनाम विभेदकारी
जनरेटिव एआई की कहानी केवल इसके अनुप्रयोगों के बारे में नहीं है, बल्कि मूल रूप से इसके आंतरिक कार्यों के बारे में है। कृत्रिम बुद्धिमत्ता पारिस्थितिकी तंत्र में, दो मॉडल हैं: विभेदकारी और जनरेटिव।
विभेदकारी मॉडल वे हैं जिनसे अधिकांश लोग दैनिक जीवन में मिलते हैं। ये एल्गोरिदम इनपुट डेटा लेते हैं, जैसे कि पाठ या एक छवि, और इसे एक लक्ष्य आउटपुट के साथ जोड़ते हैं, जैसे कि एक शब्द अनुवाद या चिकित्सा निदान। वे मानचित्रण और भविष्यवाणी के बारे में हैं।
जनरेटिव मॉडल, दूसरी ओर, रचनाकार हैं। वे केवल व्याख्या या भविष्यवाणी नहीं करते हैं; वे संख्याओं के वेक्टर से नए और जटिल आउटपुट उत्पन्न करते हैं; इन संख्याओं का अक्सर वास्तविक दुनिया के मानों से सीधा संबंध नहीं होता।
…

जनरेटिव मॉडल के पीछे प्रौद्योगिकी
जनरेटिव मॉडल अपना अस्तित्व गहरे तंत्रिका नेटवर्क के लिए धन्यवाद देते हैं, जो जटिल संरचनाएं हैं जो मानव मस्तिष्क की कार्यक्षमता की नकल करने के लिए डिज़ाइन की गई हैं। डेटा में बहुमुखी भिन्नताओं को पकड़ने और संसाधित करने के द्वारा, ये नेटवर्क कई जनरेटिव मॉडल के लिए रीढ़ की हड्डी के रूप में कार्य करते हैं।
इन जनरेटिव मॉडल को कैसे जीवन में लाया जाता है? आमतौर पर, वे गहरे तंत्रिका नेटवर्क के साथ बनाए जाते हैं, जो डेटा में बहुमुखी भिन्नताओं को पकड़ने के लिए अनुकूलित होते हैं। एक प्रमुख उदाहरण जनरेटिव एडवर्सेरियल नेटवर्क (GAN) है, जहां दो तंत्रिका नेटवर्क, जनरेटर और डिस्क्रिमिनेटर, एक दूसरे से सीखते हैं और प्रतिस्पर्धा करते हैं एक अनोखे शिक्षक-छात्र संबंध में। चित्रों से लेकर शैली स्थानांतरण तक, संगीत रचना से लेकर गेम खेलने तक, ये मॉडल पहले से अकल्पनीय तरीकों से विकसित हो रहे हैं और विस्तार कर रहे हैं।
यह GAN के साथ नहीं रुकता है। वेरिएशनल ऑटोएनकोडर (VAE) जनरेटिव मॉडल क्षेत्र में एक और महत्वपूर्ण खिलाड़ी हैं। VAE अपनी क्षमता के लिए खड़े हैं जो लगभग यादृच्छिक संख्याओं से फोटो जैसी वास्तविक छवियाँ उत्पन्न कर सकते हैं। कैसे? इन संख्याओं को एक लेटेंट वेक्टर के माध्यम से संसाधित करके मानव सौंदर्यशास्त्र की जटिलताओं को दर्पण देने वाली कला का जन्म होता है।
जनरेटिव एआई प्रकार: पाठ से पाठ, पाठ से छवि
ट्रांसफॉर्मर और एलएलएम
” अटेंशन इज ऑल यू नीड ” नामक गूगल (GOOGL ) ब्रेन के पेपर ने टेक्स्ट मॉडलिंग के बारे में हमारी सोच में एक बदलाव का संकेत दिया। रिकरंट न्यूरल नेटवर्क (आरएनएन) या कॉनवोल्यूशनल न्यूरल नेटवर्क (सीएनएन) जैसे जटिल और क्रमिक वास्तुकला के बजाय, ट्रांसफॉर्मर मॉडल ने ध्यान की अवधारणा पेश की, जिसका अर्थ है संदर्भ के आधार पर इनपुट पाठ के विभिन्न भागों पर ध्यान केंद्रित करना। इसके मुख्य लाभों में से एक समानांतरकरण की सुविधा थी। आरएनएन के विपरीत, जो पाठ को क्रमिक रूप से संसाधित करते हैं, जिससे उन्हें स्केल करना मुश्किल हो जाता है, ट्रांसफॉर्मर एक ही समय में पाठ के हिस्सों को संसाधित कर सकते हैं, जिससे बड़े डेटासेट पर प्रशिक्षण तेज और अधिक कुशल हो जाता है।

- ट्रांसफॉर्मर मॉडल की संरचना
एक लंबे पाठ में, जिस शब्द या वाक्य को आप पढ़ते हैं उनमें से प्रत्येक का समान महत्व नहीं होता है। कुछ हिस्सों को संदर्भ के आधार पर अधिक ध्यान देने की आवश्यकता होती है। यह ध्यान तंत्र की क्षमता है जिसे यह अनुकरण करता है।
इसे समझने के लिए, एक वाक्य के बारे में सोचें: “यूनाइट एआई प्रकाशित एआई और रोबोटिक्स समाचार।” अब, अगले शब्द की भविष्यवाणी करने के लिए पिछले संदर्भ को समझने की आवश्यकता है। ‘रोबोटिक्स’ शब्द से यह संकेत मिल सकता है कि अगला शब्द रोबोटिक्स क्षेत्र में किसी विशिष्ट प्रगति या घटना से संबंधित हो सकता है, जबकि ‘प्रकाशित’ से यह संकेत मिल सकता है कि अगला संदर्भ किसी हाल के प्रकाशन या लेख में हो सकता है।
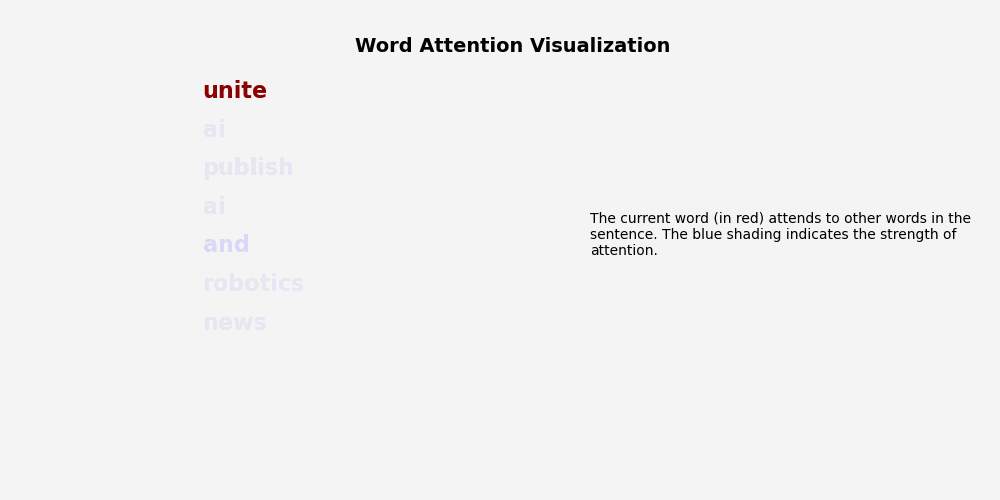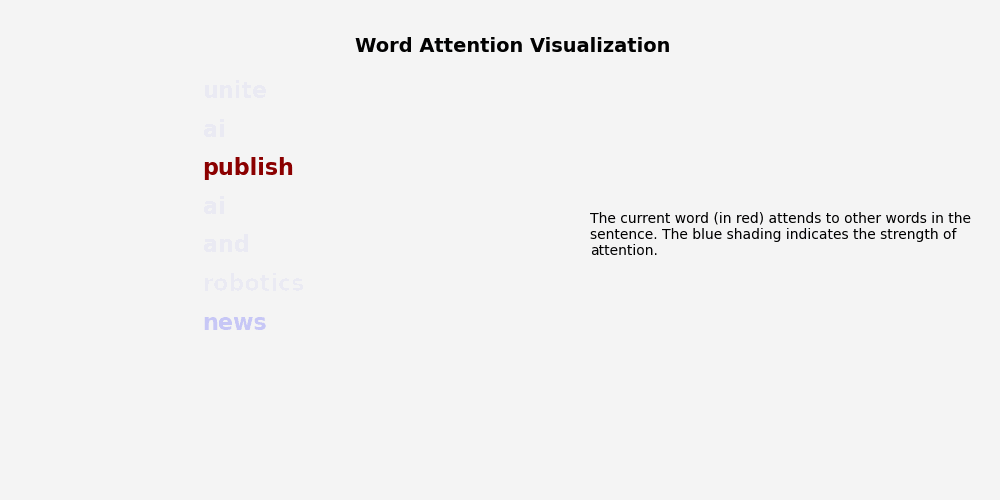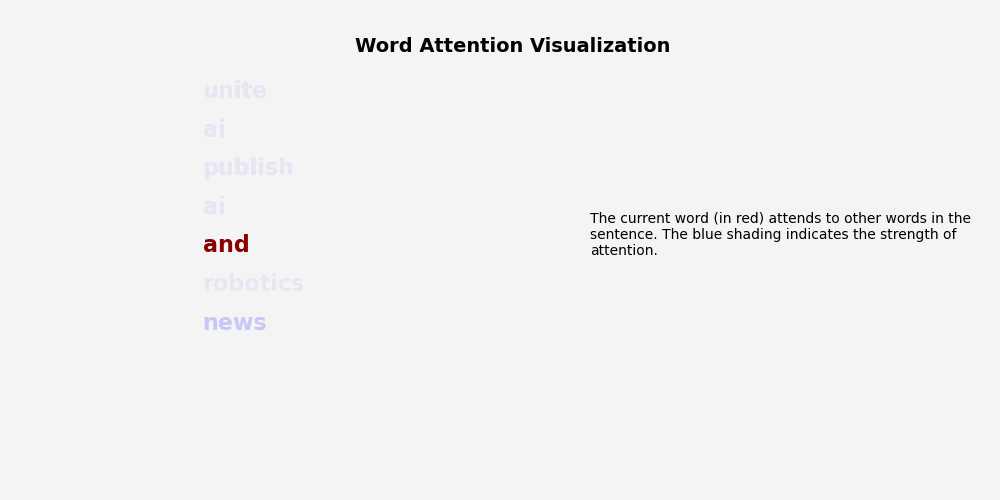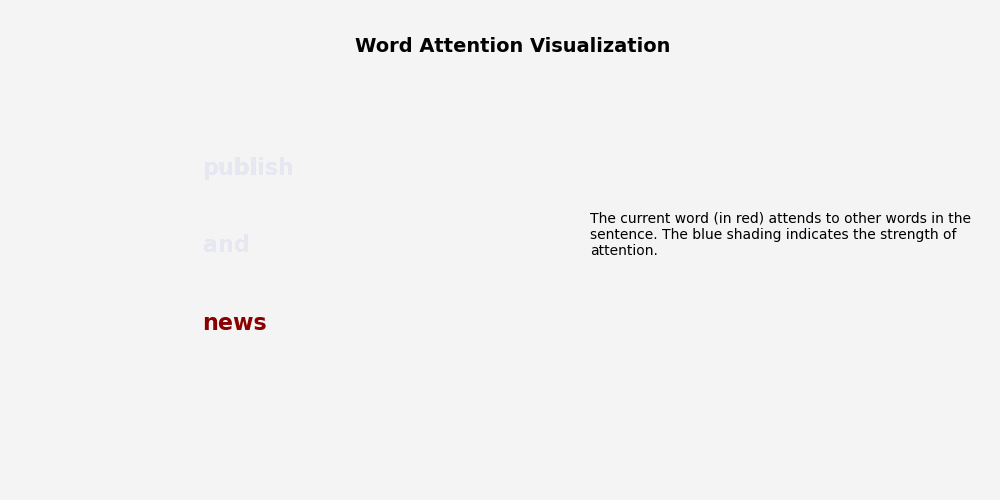
- स्व-ध्यान स्पष्टीकरण
ट्रांसफॉर्मर में ध्यान तंत्र इस चयनात्मक ध्यान को प्राप्त करने के लिए डिज़ाइन किया गया है। यह इनपुट पाठ के विभिन्न हिस्सों के महत्व का मूल्यांकन करता है और जब प्रतिक्रिया उत्पन्न करने के लिए कहां “देखना” है, यह तय करता है। यह पुरानी वास्तुकला से एक प्रस्थान है जैसे कि आरएनएन जो पूरे इनपुट पाठ का सार एकल ‘स्टेट’ या ‘मेमोरी’ में भरने की कोशिश करते हैं।
ध्यान के कार्य को एक कुंजी-मूल्य पुनर्प्राप्ति प्रणाली के रूप में समझा जा सकता है। किसी वाक्य में अगले शब्द की भविष्यवाणी करने की कोशिश में, प्रत्येक पूर्ववर्ती शब्द एक ‘कुंजी’ प्रदान करता है जो इसकी संभावित प्रासंगिकता का संकेत देता है, और ये कुंजियाँ वर्तमान संदर्भ या क्वेरी से कितनी अच्छी तरह मेल खाती हैं, इसके आधार पर वे भविष्यवाणी में एक «वैल्यू» या भार का योगदान करती हैं।
इन उन्नत एआई गहरे शिक्षण मॉडल को विभिन्न अनुप्रयोगों में बिना किसी समस्या के एकीकृत किया गया है, जैसे कि गूगल के सर्च इंजन में बेर्ट के साथ सुधार से लेकर गिटहब के कोपायलट तक, जो बड़े भाषा मॉडल (एलएलएम) की क्षमता का उपयोग करके सरल कोड स्निपेट को पूर्ण स्रोत कोड में परिवर्तित करता है।
बड़े भाषा मॉडल (एलएलएम) जैसे जीपीटी-4, बर्ड, और एलएलएमए विशाल निर्माण हैं जो मानव भाषा, कोड और अधिक को समझने और उत्पन्न करने के लिए डिज़ाइन किए गए हैं। उनका विशाल आकार, जो अरबों से लेकर खरबों पैरामीटर तक है, एक परिभाषित विशेषता है। इन एलएलएम को व्यापक मात्रा में पाठ डेटा के साथ खिलाया जाता है, जिससे उन्हें मानव भाषा की जटिलताओं को समझने में मदद मिलती है। इन मॉडलों की एक उल्लेखनीय विशेषता उनकी “फ्यू-शॉट” सीखने की क्षमता है। पारंपरिक मॉडल के विपरीत जिन्हें विशिष्ट प्रशिक्षण डेटा की बड़ी मात्रा में आवश्यकता होती है, एलएलएम कुछ ही उदाहरणों (या “शॉट्स”) से सामान्यीकरण कर सकते हैं।
मध्य-2023 के बाद के समय में बड़े भाषा मॉडल की स्थिति — मूल लेख के अनुसार
| मॉडल नाम | विकासकर्ता | पैरामीटर | उपलब्धता और पहुंच | उल्लेखनीय विशेषताएं और टिप्पणियां |
| जीपीटी-4 | ओपनएआई | 1.5 ट्रिलियन (अंग्रेज़ी मूल का अपुष्ट आँकड़ा; OpenAI की तकनीकी रिपोर्ट में मॉडल का आकार नहीं बताया गया है) | ओपन सोर्स नहीं, केवल एपीआई एक्सेस | विभिन्न कार्यों पर प्रभावशाली प्रदर्शन; छवियों और पाठ को संसाधित कर सकता है, अधिकतम इनपुट लंबाई 32,768 टोकन |
| जीपीटी-3 | ओपनएआई | 175 बिलियन | ओपन सोर्स नहीं, केवल एपीआई एक्सेस | थोड़े-शॉट और शून्य-शॉट सीखने की क्षमता प्रदर्शित की; प्राकृतिक भाषा में पाठ पूर्णता करता है |
| ब्लूम | बिगसाइंस | 176 बिलियन | डाउनलोड करने योग्य मॉडल, होस्टेड एपीआई उपलब्ध | वैश्विक सहयोग द्वारा विकसित बहुभाषी एलएलएम; 13 प्रोग्रामिंग भाषाओं का समर्थन करता है |
| लाम्डा | गूगल | 173 बिलियन | ओपन सोर्स नहीं, कोई एपीआई या डाउनलोड नहीं | संवाद पर प्रशिक्षित; लगभग किसी भी विषय पर बात करना सीख सकता है |
| एमटी-एनएलजी | एनवीडिया /माइक्रोसॉफ्ट | 530 बिलियन | आवेदन द्वारा एपीआई एक्सेस | मेगाट्रॉन वास्तुकला का उपयोग विभिन्न एनएलपी कार्यों के लिए करता है |
| एलएलएमए | मेटा एआई | 7बी से 65बी) | आवेदन द्वारा डाउनलोड करने योग्य | शोध, सरकार और अकादमिक क्षेत्र में लोगों को पहुंच प्रदान करके एआई को लोकतांत्रिक बनाने के लिए डिज़ाइन किया गया |
एलएलएम का उपयोग कैसे किया जाता है?
एलएलएम का उपयोग कई तरीकों से किया जा सकता है, जिनमें शामिल हैं:
- प्रत्यक्ष उपयोग: किसी पूर्व-प्रशिक्षित एलएलएम का उपयोग पाठ उत्पन्न करने या संसाधित करने के लिए। उदाहरण के लिए, जीपीटी-4 का उपयोग ब्लॉग पोस्ट लिखने के लिए बिना किसी अतिरिक्त फाइन-ट्यूनिंग के
- फाइन-ट्यूनिंग: किसी विशिष्ट कार्य के लिए एक पूर्व-प्रशिक्षित एलएलएम को अनुकूलित करना, जिसे स्थानांतरण सीखने के रूप में जाना जाता है। एक उदाहरण टी5 को किसी विशिष्ट उद्योग के दस्तावेजों के लिए सारांश उत्पन्न करने के लिए अनुकूलित करना होगा
- सूचना पुनर्प्राप्ति: एलएलएम का उपयोग बड़े पैमाने पर संरचनाओं के हिस्से के रूप में करना, जो सूचना को पुनः प्राप्त और वर्गीकृत कर सकती हैं।

- चैटजीपीटी फाइन ट्यूनिंग आर्किटेक्चर
मल्टी-हेड अटेंशन: एक क्यों जब आप कई हो सकते हैं?
हालांकि, एकल ध्यान तंत्र पर निर्भर रहना सीमित हो सकता है। पाठ के विभिन्न शब्द या अनुक्रम विभिन्न प्रकार के संबंध या प्रासंगिकता हो सकते हैं। यहीं पर मल्टी-हेड अटेंशन आता है। एकल ध्यान भार के बजाय, मल्टी-हेड अटेंशन कई सेट का उपयोग करता है, जिससे मॉडल इनपुट पाठ में विविध संबंधों की एक समृद्ध विविधता को पकड़ सकता है। प्रत्येक ध्यान “सिर” विभिन्न हिस्सों या पाठ के पहलुओं पर ध्यान केंद्रित कर सकता है, और उनके संयुक्त ज्ञान का उपयोग अंतिम भविष्यवाणी के लिए किया जाता है।
चैटजीपीटी: सबसे लोकप्रिय जनरेटिव एआई टूल
जीपीटी के 2018 में आगमन के साथ, मॉडल मूल रूप से 12 परतों, 12 ध्यान सिर और 120 मिलियन पैरामीटर पर बनाया गया था, जो मुख्य रूप से बुककोर्पस नामक डेटासेट पर प्रशिक्षित किया गया था। यह एक प्रभावशाली शुरुआत थी, जो भविष्य के भाषा मॉडल की एक झलक प्रदान करता था।
जीपीटी-2, 2019 में पेश किया गया, परतों और ध्यान सिर में चार गुना वृद्धि का दावा करता था। इसके पैरामीटर गणना 1.5 बिलियन तक छलांग लगा गई। इस उन्नत संस्करण को वेबटेक्स नामक डेटासेट से प्रशिक्षित किया गया था, जिसमें विभिन्न रेडिट लिंक्स से 40GB पाठ था।
जीपीटी-3, मई 2020 में लॉन्च किया गया, में 96 परतें, 96 ध्यान सिर और 175 बिलियन पैरामीटर थे। जीपीटी-3 को जो अलग बनाता था वह इसका विविध प्रशिक्षण डेटा था, जिसमें कॉमनक्रॉल, वेबटेक्स, अंग्रेजी विकिपीडिया, पुस्तक संग्रह और अन्य स्रोत शामिल थे, जो कुल 570 जीबी थे।
चैटजीपीटी के कार्यों की जटिलता एक सुरक्षित रहस्य बनी हुई है। हालांकि, ‘मानव प्रतिक्रिया से प्रबलित सीखने’ (आरएलएचएफ) नामक एक प्रक्रिया इसके विकास में महत्वपूर्ण होने के लिए जानी जाती है। एक पूर्व चैटजीपीटी परियोजना से उत्पन्न, यह तकनीक जीपीटी-3.5 मॉडल को लिखित निर्देशों के साथ अधिक संरेखित करने में महत्वपूर्ण थी।
चैटजीपीटी का प्रशिक्षण एक त्रिस्तरीय दृष्टिकोण का पालन करता है:
- पर्यवेक्षित फाइन-ट्यूनिंग: मानव-लिखित संवादात्मक इनपुट और आउटपुट को संकलित करना और अंतर्निहित जीपीटी-3.5 मॉडल को परिष्कृत करना
- पुरस्कार मॉडलिंग: मानव द्वारा मॉडल के विभिन्न आउटपुट को उनकी गुणवत्ता के आधार पर रैंक करना, जो संदर्भ को ध्यान में रखते हुए एक रिवार्ड मॉडल को प्रशिक्षित करने में मदद करता है, जो बातचीत का संदर्भ देखते हुए प्रत्येक आउटपुट को स्कोर देता है
- प्रबलित सीखना: संवादात्मक संदर्भ में मॉडल द्वारा एक प्रतिक्रिया का प्रस्ताव, जिसे पुरस्कार मॉडल द्वारा मूल्यांकन किया जाता है और प्रॉक्सिमल पॉलिसी ऑप्टिमाइजेशन (पीपीओ) नामक एक अल्गोरिदम का उपयोग करके अनुकूलित किया जाता है
चैटजीपीटी के साथ शुरुआत करने वालों के लिए, एक व्यापक शुरुआती गाइड यहां पाया जा सकता है। यदि आप चैटजीपीटी के साथ प्रॉम्प्ट इंजीनियरिंग में गहराई से जाना चाहते हैं, तो हमारे पास एक उन्नत गाइड भी है जो नवीनतम और अत्याधुनिक प्रॉम्प्ट तकनीकों पर प्रकाश डालता है, जो ‘चैटजीपीटी और उन्नत प्रॉम्प्ट इंजीनियरिंग: एआई क्रांति को बढ़ावा देना‘ पर उपलब्ध है।
विसरण और बहु-माध्यमीय मॉडल
वीएई और GAN जैसे मॉडल अपने आउटपुट को एकल पास के माध्यम से उत्पन्न करते हैं, इसलिए वे जो उत्पन्न करते हैं उसमें बंद हो जाते हैं, विसरण मॉडल ने ‘पुनरावृत्ति सुधार‘ की अवधारणा को पेश किया है। इस विधि के माध्यम से, वे पिछले चरणों से त्रुटियों को सुधारते हुए, और धीरे-धीरे एक अधिक परिष्कृत परिणाम का उत्पादन करते हैं।
विसरण मॉडल के केंद्र में “शोर जोड़कर विकृत करना” और “सुधार” की कला है। उनके प्रशिक्षण चरण में, एक सामान्य छवि को धीरे-धीरे विभिन्न स्तरों के शोर जोड़कर विकृत किया जाता है। यह शोरयुक्त संस्करण मॉडल को दिया जाता है, जो इसे ‘शोर मुक्त’ या ‘विकृति से मुक्त’ करने का प्रयास करता है। इस प्रक्रिया के माध्यम से, मॉडल सुधार में महारत हासिल करता है, और सूक्ष्म और महत्वपूर्ण विचलन दोनों को समझने में सक्षम हो जाता है।

- मिडजॉर्नी से उत्पन्न छवि
उत्पादन की प्रक्रिया प्रशिक्षण के बाद नए छवियों का है जो आकर्षक है। एक पूरी तरह से यादृच्छिक इनपुट से, यह मॉडल की भविष्यवाणियों का उपयोग करके लगातार सुधारा जाता है। उद्देश्य न्यूनतम चरणों के साथ एक उत्कृष्ट छवि प्राप्त करना है। विकृति के स्तर को नियंत्रित करने के लिए एक “शोर अनुसूची” तंत्र है, जो विभिन्न चरणों पर लागू किए जाने वाले शोर की मात्रा को नियंत्रित करता है। एक अनुसूचक, जैसा कि “diffusers” लाइब्रेरी में देखा जा सकता है, स्थापित अल्गोरिदम के आधार पर इन शोरयुक्त संस्करणों की प्रकृति को निर्धारित करता है।
विसरण मॉडल के लिए एक आवश्यक वास्तुकला पृष्ठभूमि कई मॉडलों के लिए UNet है – एक कन्वोल्यूशनल न्यूरल नेटवर्क जो आउटपुट के स्थानिक आयाम को इनपुट के स्थानिक आयाम के अनुरूप होने वाले कार्यों के लिए अनुकूलित है। यह डाउनसैंपलिंग और अपसैंपलिंग परतों का मिश्रण है, जो उच्च-रिज़ॉल्यूशन डेटा को बनाए रखने के लिए जटिल रूप से जुड़े हुए हैं, जो छवि से संबंधित आउटपुट के लिए महत्वपूर्ण है।
जनरेटिव मॉडल की दुनिया में गहराई से, ओपनएआई का DALL-E 2 एक चमकता उदाहरण है जो पाठ और दृश्य एआई क्षमताओं के संलयन को प्रदर्शित करता है। यह एक त्रिस्तरीय संरचना का उपयोग करता है:
DALL-E 2 एक त्रिस्तरीय वास्तुकला प्रदर्शित करता है:
- पाठ एनकोडर: यह पाठ प्रोम्प्ट को एक अवधारणात्मक एम्बेडिंग में परिवर्तित करता है एक लेटेंट स्पेस में। यह मॉडल शून्य से नहीं शुरू होता है। यह ओपनएआई के कंट्रास्टिव लैंग्वेज-इमेज प्री-ट्रेनिंग (CLIP) डेटासेट पर निर्भर करता है। सीएलआईपी दृश्य और पाठ डेटा के बीच एक पुल के रूप में कार्य करता है, जो प्राकृतिक भाषा का उपयोग करके दृश्य अवधारणाओं को सीखता है। कॉन्ट्रास्टिव लर्निंग की एक प्रक्रिया के माध्यम से, यह छवियों को उनके संबंधित पाठ विवरणों के साथ मेल खाता है।
- प्रायर: पाठ एनकोडर से प्राप्त पाठ एम्बेडिंग को फिर एक छवि एम्बेडिंग में परिवर्तित किया जाता है। DALL-E 2 ने इस कार्य के लिए ऑटोरेग्रेसिव और विसरण दोनों विधियों का परीक्षण किया, जिसमें बाद वाला बेहतर परिणाम दिखाता है। ऑटोरेग्रेसिव मॉडल, जैसे कि ट्रांसफॉर्मर और पिक्सेलसीएनएन में, क्रमिक रूप से आउटपुट उत्पन्न करते हैं। दूसरी ओर, विसरण मॉडल, जैसे कि DALL-E 2 में उपयोग किया जाता है, पाठ एम्बेडिंग की मदद से यादृच्छिक शोर को भविष्यवाणी की गई छवि एम्बेडिंग में परिवर्तित करते हैं।
- डिकोडर: प्रक्रिया का चरम भाग, यह पाठ प्रोम्प्ट और प्रायर चरण से छवि एम्बेडिंग के आधार पर अंतिम दृश्य आउटपुट का उत्पादन करता है। DALL-E 2 के डिकोडर का वास्तुकला एक अन्य मॉडल, GLIDE से ली गई है, जो पाठ संकेतों से वास्तविक छवियां उत्पन्न कर सकता है।

- DALL-E मॉडल की सरलीकृत वास्तुकला
पाइथन उपयोगकर्ता जो Langchain में रुचि रखते हैं, उन्हें हमारा विस्तृत ट्यूटोरियल देखना चाहिए जो मूल बातों से लेकर उन्नत तकनीकों तक सब कुछ कवर करता है।
जनरेटिव एआई के अनुप्रयोग
पाठ संबंधी डोमेन
पाठ से शुरुआत करते हुए, जनरेटिव एआई को चैटबॉट जैसे चैटजीपीटी द्वारा मौलिक रूप से बदल दिया गया है। प्राकृतिक भाषा प्रसंस्करण (एनएलपी) और बड़े भाषा मॉडल (एलएलएम) पर भारी निर्भरता के साथ, ये संस्थाएं कोड उत्पन्न करने, भाषा अनुवाद करने, सारांश बनाने और भावना विश्लेषण जैसे कार्यों को करने में सक्षम हैं। चैटजीपीटी ने व्यापक रूप से अपनाया गया है, और लाखों के लिए एक मानक बन गया है। इसके अलावा, एलएलएम जैसे जीपीटी-4, PaLM और BLOOM पर आधारित संवादात्मक एआई प्लेटफ़ॉर्म, पाठ उत्पन्न करने, प्रोग्रामिंग में सहायता करने और यहां तक कि गणितीय तर्क प्रदान करने में सक्षम हैं।
व्यावसायिक दृष्टिकोण से, ये मॉडल मूल्यवान हो गए हैं। व्यवसाय उन्हें जोखिम प्रबंधन, इन्वेंट्री अनुकूलन, और मांग की भविष्यवाणी जैसे विभिन्न संचालन के लिए नियुक्त करते हैं। कुछ उल्लेखनीय उदाहरणों में बिंग एआई, गूगल का बार्ड, और चैटजीपीटी एपीआई शामिल हैं।
कला
छवियों की दुनिया में जनरेटिव एआई, विशेष रूप से 2022 में DALL-E 2 की शुरुआत के बाद से, नाटकीय परिवर्तन देखे गए हैं। यह प्रौद्योगिकी, जो पाठ प्रोम्प्ट से छवियां उत्पन्न कर सकती है, कलात्मक और पेशेवर दोनों परिणामों के साथ है। उदाहरण के लिए, मिडजॉर्नी ने इस तकनीक का उपयोग करके आश्चर्यजनक रूप से वास्तविक छवियां उत्पन्न की हैं। इस हाल के पोस्ट मिडजॉर्नी को एक विस्तृत गाइड में समझाया गया है, जो प्लेटफ़ॉर्म और इसकी प्रॉम्प्ट इंजीनियरिंग जटिलताओं को समझाता है। इसके अलावा, अल्पाका एआई और फोटोरूम एआई जैसे प्लेटफ़ॉर्म जनरेटिव एआई का उपयोग उन्नत छवि संपादन कार्यों जैसे पृष्ठभूमि हटाने, वस्तु हटाने और यहां तक कि चेहरा पुनर्स्थापना के लिए करते हैं।
वीडियो उत्पादन
वीडियो उत्पादन, जनरेटिव एआई की दुनिया में अभी भी अपने शुरुआती चरण में, वादा दिखा रहा है। इमेजन वीडियो, मेटा मेक ए वीडियो, और रनवे जेन-2 जैसे प्लेटफ़ॉर्म सीमाओं को आगे बढ़ा रहे हैं, भले ही वास्तविक रूप से यथार्थवादी आउटपुट अभी भी दूर की कौड़ी हैं। ये मॉडल डिजिटल मानव वीडियो बनाने के लिए महत्वपूर्ण उपयोगिता प्रदान करते हैं, जिनमें सिंथेसिया और सुपरक्रिएटर जैसे अनुप्रयोग अग्रणी हैं। उल्लेखनीय रूप से, टावस एआई एक अनोखा बिक्री बिंदु प्रदान करता है जो व्यक्तिगत दर्शकों के लिए वीडियो को व्यक्तिगत बनाता है, जो व्यवसायों के लिए एक वरदान है।
कोड सृजन
कोडिंग, हमारी डिजिटल दुनिया का एक अभिन्न अंग, जनरेटिव एआई से अछूता नहीं रहा है। चैटजीपीटी एक पसंदीदा उपकरण होने के अलावा, कई अन्य एआई अनुप्रयोग कोडिंग उद्देश्यों के लिए विकसित किए गए हैं। ये प्लेटफ़ॉर्म, जैसे कि गिटहब कोपायलट, अल्फाकोड, और कोडकंप्लीट, कोडिंग सहायक के रूप में कार्य करते हैं और यहां तक कि पाठ प्रोम्प्ट से कोड उत्पन्न कर सकते हैं। आकर्षक बात यह है कि इन उपकरणों की अनुकूलन क्षमता है। कोडेक्स, जो गिटहब कोपायलट के पीछे की ताकत है, को व्यक्तिगत कोडिंग शैली के अनुसार अनुकूलित किया जा सकता है, जनरेटिव एआई की व्यक्तिगतीकरण क्षमता को रेखांकित करता है।
निष्कर्ष
मानव रचनात्मकता और मशीन गणना को मिलाकर, जनरेटिव एआई एक अमूल्य उपकरण बन गया है, जिसमें चैटजीपीटी और DALL-E 2 जैसे प्लेटफ़ॉर्म संभावनाओं की सीमाओं को आगे बढ़ा रहे हैं। पाठ सामग्री बनाने से लेकर दृश्य उत्कृष्टता को आकार देने तक, उनके अनुप्रयोग व्यापक और विविध हैं।
जैसा कि किसी भी प्रौद्योगिकी के साथ होता है, नैतिक प्रभाव महत्वपूर्ण हैं। जबकि जनरेटिव एआई असीमित रचनात्मकता का वादा करता है, इसका जिम्मेदारी से उपयोग करना और संभावित पूर्वाग्रहों और डेटा मैनिपुलेशन की शक्ति के प्रति जागरूक रहना महत्वपूर्ण है।
चैटजीपीटी जैसे उपकरण अधिक सुलभ होते जा रहे हैं, अब शुरुआती प्रयोग करने और प्रयोग करने का सही समय है। चाहे आप एक कलाकार, कोडर या प्रौद्योगिकी उत्साही हों, जनरेटिव एआई की दुनिया अन्वेषण के लिए तैयार अनगिनत संभावनाओं से भरी हुई है। क्रांति क्षितिज पर नहीं है; यह अब और यहीं है। तो, इसमें कूदो!


