
प्रॉम्प्ट इंजीनियरिंग
ChatGPT और उन्नत प्रॉम्प्ट इंजीनियरिंग: एआई के विकास को गति देना

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें

मुख्य बिंदुरीऐक्ट और चेन-ऑफ-थॉट जैसी उन्नत प्रॉम्प्ट इंजीनियरिंग तकनीकें एआई हॉल्यूसिनेशन को कम…
और देखें
- रीऐक्ट और चेन-ऑफ-थॉट जैसी उन्नत प्रॉम्प्ट इंजीनियरिंग तकनीकें एआई हॉल्यूसिनेशन को कम करने और तर्कशक्ति सुधारने के लिए अत्यंत महत्वपूर्ण हैं।
- सुस्पष्ट प्रॉम्प्ट चैटजीपीटी के आउटपुट की गुणवत्ता नियंत्रित करने और प्रासंगिक, उपयोगकर्ता-अनुकूल प्रतिक्रियाएँ सुनिश्चित करने के लिए आवश्यक हैं।
- फ्यू-शॉट लर्निंग जीपीटी-3 जैसे मॉडलों को बिना महंगे फाइन-ट्यूनिंग या कस्टम डेटासेट के नए कार्यों के अनुकूल बनने की अनुमति देती है।
ओपनएआई ने क्रांतिकारी उपकरणों जैसे ओपनएआई जिम को विकसित करने में महत्वपूर्ण भूमिका निभाई है, जो रीइन्फोर्समेंट लर्निंग एल्गोरिदम के प्रशिक्षण के लिए डिज़ाइन किया गया है, और जीपीटी-एन मॉडल। स्पॉटलाइट DALL-E पर भी है, एक एआई मॉडल जो पाठ से छवियों को बनाता है। ओपनएआई के चैटजीपीटी जैसे मॉडल ने भी काफी ध्यान आकर्षित किया है, एक बड़े भाषा मॉडल के क्षेत्र में एक उत्कृष्ट उदाहरण है।
जीपीटी-4: प्रॉम्प्ट इंजीनियरिंग
चैटजीपीटी ने चैटबॉट लैंडस्केप को बदल दिया है, उपयोगकर्ता इनपुट के लिए मानव जैसी प्रतिक्रियाएं प्रदान करता है और विभिन्न डोमेन में इसके अनुप्रयोगों का विस्तार किया है – सॉफ्टवेयर विकास और परीक्षण से लेकर व्यवसाय संचार और यहां तक कि कविता के निर्माण तक।
व्यवसायों और व्यक्तियों के हाथों में, जीपीटी-4, उदाहरण के लिए, गणित और जीव विज्ञान से लेकर कानूनी अध्ययन तक विभिन्न विषयों में ज्ञान का एक अथाह भंडार हो सकता है। ऐसे परिष्कृत और सुलभ एआई मॉडल भविष्य के काम, शिक्षा और रचनात्मकता को पुनरपरिभाषित करने के लिए तैयार हैं।

जेनरेटिव मॉडल जैसे जीपीटी-4 मौजूदा इनपुट के आधार पर नई डेटा बना सकते हैं। यह विशिष्ट विशेषता उन्हें विभिन्न कार्यों को करने में सक्षम बनाती है, जिनमें पाठ, छवियों, संगीत और वीडियो का निर्माण शामिल है।
ओपनएआई मॉडल और चैटजीपीटी के संदर्भ में, प्रॉम्प्ट उपयोगकर्ता द्वारा मॉडल को प्रदान किया गया इनपुट है, आमतौर पर पाठ के रूप में। प्रॉम्प्ट इन मॉडलों द्वारा उत्पन्न आउटपुट को नियंत्रित करने का प्राथमिक साधन है, जिससे उन्हें सफल और प्रासंगिक बातचीत के लिए महत्वपूर्ण बना दिया जाता है।
प्रॉम्प्ट गुणवत्ता का प्रभाव
एआई प्रणालियों के साथ उपयोगी और अर्थपूर्ण बातचीत में शामिल होने के लिए अच्छी तरह से परिभाषित प्रॉम्प्ट का उपयोग करना महत्वपूर्ण है। खराब परिभाषित प्रॉम्प्ट उपयोगकर्ता के लिए सहायक नहीं हो सकते हैं और यहां तक कि भ्रामक सामग्री का कारण भी बन सकते हैं।
प्रॉम्प्ट गुणवत्ता के प्रभाव को प्रदर्शित करने के लिए, आइए चैटजीपीटी को दिए गए दो अलग-अलग प्रॉम्प्ट की तुलना करें। पहला प्रॉम्प्ट, जो खराब परिभाषित है और पूर्व ज्ञान की मान्यता है, उपयोगकर्ता के लिए संभावित रूप से अप्रभावी प्रतिक्रिया उत्पन्न कर सकता है। दूसरी ओर, दूसरा प्रॉम्प्ट अधिक संदर्भ और उदाहरण प्रदान करता है, जिससे एक अधिक प्रासंगिक और समझने योग्य प्रतिक्रिया सुनिश्चित होती है।
प्रॉम्प्ट 1: “कॉनवोल्यूशनल न्यूरल नेटवर्क के बारे में मुझे बताएं।”
प्रतिक्रिया 1: “कॉनवोल्यूशनल न्यूरल नेटवर्क (सीएनएन) मल्टी-लेयर परसेप्ट्रॉन नेटवर्क हैं जो पूरी तरह से जुड़े हुए परतों और पूलिंग परतों से बने होते हैं। वे आमतौर पर छवि पहचान कार्यों में उपयोग किए जाते हैं। प्रक्रिया में इनपुट छवियों पर फिल्टर लागू करना और पूलिंग परतों का उपयोग करके उन्हें डाउनस्केल करना शामिल है।”
प्रॉम्प्ट 2: “मैं कॉनवोल्यूशनल न्यूरल नेटवर्क के बारे में सीखना चाहता हूं, लेकिन मेरे पास कृत्रिम न्यूरल नेटवर्क का कोई पूर्व ज्ञान नहीं है। कृपया एक शुरुआती लोगों के लिए सरल व्याख्या प्रदान करें और छवि पहचान में सीएनएन का उपयोग करने का एक उदाहरण दें।”
प्रतिक्रिया 2: “कॉनवोल्यूशनल न्यूरल नेटवर्क (सीएनएन) मुख्य रूप से छवि पहचान कार्यों के लिए उपयोग किए जाने वाले एक प्रकार के न्यूरल नेटवर्क हैं। अन्य न्यूरल नेटवर्क के विपरीत, वे कॉनवोल्यूशनल परतों और पूलिंग परतों का लाभ उठाते हैं छवियों को संसाधित करने के लिए। कल्पना कीजिए कि आपके पास एक बिल्ली की छवि है। सीएनएन छवि में विभिन्न विशेषताओं की पहचान कर सकता है, जैसे कि व्हिस्कर, कान और पूंछ, फिल्टर लागू करके और पूलिंग परतों का उपयोग करके छवि को डाउनसैंपल करके। यह प्रक्रिया सीएनएन को छवियों में वस्तुओं को पहचानने में अत्यधिक प्रभावी बनाती है।”
दोनों प्रतिक्रियाओं की तुलना करके, यह स्पष्ट है कि एक अच्छी तरह से परिभाषित प्रॉम्प्ट एक अधिक प्रासंगिक और उपयोगकर्ता-अनुकूल प्रतिक्रिया की ओर ले जाता है। प्रॉम्प्ट डिज़ाइन और इंजीनियरिंग बढ़ते क्षेत्र हैं जो एआई मॉडल जैसे चैटजीपीटी के आउटपुट गुणवत्ता को अनुकूलित करने का लक्ष्य रखते हैं।
इस लेख के आगे के खंडों में, हम बड़े भाषा मॉडल (एलएलएम) को परिष्कृत करने के लिए उन्नत पद्धतियों की दुनिया में गहराई से जाएंगे, जिनमें प्रॉम्प्ट इंजीनियरिंग तकनीक और रणनीतियां शामिल हैं। इनमें फ्यू-शॉट लर्निंग, रिएक्ट, चेन-ऑफ-थॉट, आरएजी और अधिक शामिल हैं।
उन्नत इंजीनियरिंग तकनीक
आगे बढ़ने से पहले, एलएलएम के साथ एक प्रमुख मुद्दे को समझना महत्वपूर्ण है, जिसे ‘हॉल्यूसिनेशन’ के रूप में जाना जाता है। एलएलएम के संदर्भ में, ‘हॉल्यूसिनेशन’ का अर्थ है इन मॉडलों की प्रवृत्ति जो आउटपुट उत्पन्न कर सकती है जो तर्कसंगत लग सकती है लेकिन वास्तविक वास्तविकता या दिए गए इनपुट संदर्भ में निहित नहीं है।
यह समस्या एक हालिया मामले में स्पष्ट रूप से उजागर हुई थी जहां एक रक्षा वकील ने चैटजीपीटी का उपयोग किया था कानूनी अनुसंधान के लिए। एआई टूल, अपनी हॉल्यूसिनेशन समस्या के कारण, गैर-मौजूद कानूनी मामलों का हवाला दिया। इस चूक का महत्वपूर्ण परिणाम था, जिससे कार्यवाही के दौरान भ्रम और विश्वसनीयता कम हो गई। यह घटना एलएलएम में ‘हॉल्यूसिनेशन’ समस्या को संबोधित करने की तत्काल आवश्यकता की याद दिलाती है।
हमारी प्रॉम्प्ट इंजीनियरिंग तकनीकों का अन्वेषण इन मॉडलों की प्रभावशीलता और सुरक्षा में सुधार करने का लक्ष्य रखता है। उनकी क्षमता को बढ़ाकर, हम नवाचारी अनुप्रयोगों के लिए मार्ग प्रशस्त करते हैं जैसे कि जानकारी निकालना। इसके अलावा, यह बाहरी उपकरणों और डेटा स्रोतों के साथ एलएलएम को निर्बाध रूप से एकीकृत करने के लिए दरवाजे खोलता है, उनके संभावित उपयोगों की श्रृंखला को व्यापक बनाता है।
शून्य और कुछ-शॉट लर्निंग: उदाहरणों के साथ अनुकूलन
जेनरेटिव प्रीट्रेन्ड ट्रांसफॉर्मर (जीपीटी-3) ने जेनरेटिव एआई मॉडल के विकास में एक महत्वपूर्ण मोड़ का प्रतिनिधित्व किया, क्योंकि यह ‘कुछ-शॉट लर्निंग‘ की अवधारणा को पेश किया। यह विधि अपनी क्षमता के कारण एक गेम-चेंजर थी कि यह व्यापक फाइन-ट्यूनिंग की आवश्यकता के बिना प्रभावी ढंग से काम कर सकता है। जीपीटी-3 फ्रेमवर्क “लैंग्वेज मॉडल फ्यू-शॉट लर्नर्स हैं” में चर्चा की गई है, जहां लेखकों ने दिखाया है कि मॉडल विभिन्न उपयोग के मामलों में उत्कृष्टता से कैसे काम करता है बिना कस्टम डेटासेट या कोड की आवश्यकता के।
फाइन-ट्यूनिंग के विपरीत, जिसमें विभिन्न उपयोग के मामलों को हल करने के लिए निरंतर प्रयास की आवश्यकता होती है, कुछ-शॉट मॉडल विभिन्न अनुप्रयोगों के लिए अधिक अनुकूलनीय साबित होते हैं। हालांकि फाइन-ट्यूनिंग कुछ मामलों में मजबूत समाधान प्रदान कर सकती है, यह पैमाने पर महंगा हो सकता है, जिससे कुछ-शॉट मॉडल का उपयोग प्रॉम्प्ट इंजीनियरिंग के साथ मिलकर व्यावहारिक बन जाता है।
कल्पना कीजिए कि आप अंग्रेजी से फ्रेंच में अनुवाद करने का प्रयास कर रहे हैं। कुछ-शॉट लर्निंग में, आप जीपीटी-3 को कुछ अनुवाद उदाहरण प्रदान करेंगे, जैसे “sea otter -> loutre de mer”। जीपीटी-3, जो एक उन्नत मॉडल है, तब सटीक अनुवाद प्रदान करने में सक्षम होगा। शून्य-शॉट लर्निंग में, आपको कोई उदाहरण प्रदान नहीं करना होगा, और जीपीटी-3 अभी भी अंग्रेजी से फ्रेंच में प्रभावी ढंग से अनुवाद करेगा।
‘कुछ-शॉट लर्निंग’ शब्द का अर्थ है कि मॉडल को ‘सीखने’ के लिए एक सीमित संख्या में उदाहरण दिए जाते हैं। इस संदर्भ में, ‘सीखना’ मॉडल के पैरामीटर या वजन को अद्यतन करने को संदर्भित नहीं करता है, बल्कि इसके प्रदर्शन को प्रभावित करता है।

जीपीटी-3 पेपर में कुछ-शॉट लर्निंग
शून्य-शॉट लर्निंग इस अवधारणा को एक कदम आगे ले जाती है। शून्य-शॉट लर्निंग में, मॉडल को कार्य पूरा करने के लिए कोई उदाहरण प्रदान नहीं किया जाता है। मॉडल को अपने प्रारंभिक प्रशिक्षण पर आधारित प्रदर्शन करने की अपेक्षा की जाती है, जिससे यह खुले डोमेन प्रश्न-उत्तर देने वाले दृश्यों जैसे चैटजीपीटी के लिए आदर्श बन जाता है।
कई मामलों में, एक मॉडल जो शून्य-शॉट लर्निंग में कुशल है, वह शून्य-, एकल- और कुछ-शॉट लर्निंग दृश्यों के बीच स्विच करने में सक्षम हो सकता है। यह लचीलापन बड़े मॉडल की संभावनाओं को बढ़ाता है, विभिन्न डोमेन में उनके अनुप्रयोगों को व्यापक बनाता है।
शून्य-शॉट लर्निंग विधियां तेजी से लोकप्रिय हो रही हैं। ये विधियां अपनी क्षमता के लिए जानी जाती हैं जो उन्हें प्रशिक्षण के दौरान न देखी गई वस्तुओं को पहचानने में सक्षम बनाती हैं। यहाँ कुछ-शॉट प्रॉम्प्ट का एक व्यावहारिक उदाहरण है:
अंग्रेजी वाक्यों का फ्रेंच में अनुवाद करें:
'sea otter' का अनुवाद 'loutre de mer' है
'sky' का अनुवाद 'ciel' है
'cloud' का फ्रेंच में क्या अनुवाद है?'
मॉडल को कुछ उदाहरण प्रदान करके और फिर एक प्रश्न पूछकर, हम मॉडल को वांछित आउटपुट उत्पन्न करने के लिए प्रभावी ढंग से मार्गदर्शन कर सकते हैं। इस मामले में, जीपीटी-3 संभवतः ‘cloud’ का फ्रेंच में सही अनुवाद ‘nuage’ प्रदान करेगा।
आगे हम प्रॉम्प्ट इंजीनियरिंग की बारीकियों और इन्फरेंस के दौरान मॉडल के प्रदर्शन को बेहतर बनाने में इसकी भूमिका पर चर्चा करेंगे। यह भी देखेंगे कि विभिन्न उपयोगों के लिए कम लागत वाले और विस्तार योग्य समाधान बनाने में इसका उपयोग कैसे किया जा सकता है।
जैसा कि हम जीपीटी मॉडल में प्रॉम्प्ट इंजीनियरिंग तकनीकों की जटिलताओं में गहराई से जाते हैं, यह हमारे पिछले पोस्ट ‘चैटजीपीटी में प्रॉम्प्ट इंजीनियरिंग के लिए आवश्यक गाइड‘ को उजागर करना महत्वपूर्ण है। यह गाइड विभिन्न उपयोग के मामलों में एआई मॉडल को प्रभावी ढंग से निर्देश देने के लिए रणनीतियों के अंतर्दृष्टि प्रदान करता है।
हमारी पिछली चर्चाओं में, हमने बड़े भाषा मॉडल (एलएलएम) जैसे शून्य-शॉट और कुछ-शॉट लर्निंग के लिए मूल प्रॉम्प्ट विधियों में गहराई से जाने के साथ-साथ निर्देश प्रॉम्प्टिंग पर भी चर्चा की। इन तकनीकों में महारत हासिल करना आगे की जटिल प्रॉम्प्ट इंजीनियरिंग चुनौतियों से निपटने के लिए आवश्यक है।
अधिकांश एलएलएम की सीमित संदर्भ-विंडो के कारण फ्यू-शॉट लर्निंग की सीमाएँ हैं। उचित सुरक्षा उपाय न होने पर मॉडल को संभावित रूप से हानिकारक आउटपुट देने के लिए गुमराह किया जा सकता है। कई मॉडल तर्क-आधारित कार्यों और कई चरणों वाले निर्देशों का पालन करने में भी कठिनाई अनुभव करते हैं।
इसलिए चुनौती मौजूदा एलएलएम का उपयोग जटिल कार्यों के लिए करना है। अधिक उन्नत मॉडल बनाना या पुराने मॉडलों को सुधारना एक समाधान हो सकता है, लेकिन इसमें काफी प्रयास लगता है। सवाल यह है कि बेहतर समस्या-समाधान के लिए वर्तमान मॉडलों को कैसे अनुकूलित किया जाए।
रचनात्मक कार्यों में इन तकनीकों का उपयोग भी दिलचस्प है। Unite.AI का लेख Mastering AI Art: A Concise Guide to Midjourney and Prompt Engineering बताता है कि कला और एआई का मेल कैसे प्रभावशाली रचनाएँ दे सकता है।
चेन-ऑफ-थॉट प्रॉम्प्टिंग
चेन-ऑफ-थॉट प्रॉम्प्टिंग बड़े भाषा मॉडल (एलएलएम) की ऑटोरिग्रेसिव गुणों का लाभ उठाती है, जो एक दिए गए अनुक्रम में अगले शब्द की भविष्यवाणी करने में उत्कृष्ट होते हैं। मॉडल को अपनी सोच प्रक्रिया को स्पष्ट करने के लिए प्रेरित करके, यह एक अधिक विस्तृत, विधिपूर्वक विचारों के उत्पादन को प्रेरित करता है, जो अक्सर सटीक जानकारी के साथ मेल खाता है। यह संरेखण मॉडल की प्रवृत्ति से उत्पन्न होता है जो जानकारी को एक विचारशील और क्रमिक तरीके से संसाधित और वितरित करता है, एक मानव विशेषज्ञ की तरह जो एक जटिल अवधारणा के माध्यम से एक श्रोता को मार्गदर्शन करता है। एक सरल बयान जैसे “मुझे चरण-दर-चरण बताएं कि …” अक्सर इस अधिक विस्तृत, विस्तृत आउटपुट को ट्रिगर करने के लिए पर्याप्त होता है।
शून्य-शॉट चेन-ऑफ-थॉट प्रॉम्प्टिंग
जबकि पारंपरिक सीओटी प्रॉम्प्टिंग प्रदर्शन के साथ प्रशिक्षण की आवश्यकता होती है, एक उभरता हुआ क्षेत्र शून्य-शॉट सीओटी प्रॉम्प्टिंग है। यह दृष्टिकोण, कोजिमा एट अल द्वारा पेश किया गया (2022), मूल प्रॉम्प्ट में “चरण-दर-चरण सोचें” वाक्यांश जोड़कर नवाचारी रूप से जोड़ता है।
आइए एक उन्नत प्रॉम्प्ट बनाएं जहां चैटजीपीटी को एआई और एनएलपी अनुसंधान पत्रों से मुख्य बिंदुओं को सारांशित करने का काम सौंपा जाता है।
इस प्रदर्शन में, हम मॉडल की क्षमता का उपयोग करेंगे जो जटिल जानकारी को अकादमिक पाठों से समझने और सारांशित करने में सक्षम है। कुछ-शॉट लर्निंग दृष्टिकोण का उपयोग करके, आइए चैटजीपीटी को एआई और एनएलपी अनुसंधान पत्रों से मुख्य निष्कर्षों को सारांशित करने के लिए सिखाएं:
1. पत्र का शीर्षक: "ध्यान ही सब कुछ है"
मुख्य निष्कर्ष: ट्रांसफॉर्मर मॉडल की शुरुआत की, जिसमें क्रमिक परतों के बजाय ध्यान तंत्र पर जोर दिया गया।
2. पत्र का शीर्षक: "बीईआरटी: भाषा समझने के लिए गहरे द्विदिश नेटवर्क का पूर्व-प्रशिक्षण"
मुख्य निष्कर्ष: बीईआरटी की शुरुआत की, जो गहरे द्विदिश मॉडल के पूर्व-प्रशिक्षण की प्रभावशीलता को प्रदर्शित करता है, विभिन्न एनएलपी कार्यों पर अत्याधुनिक परिणाम प्राप्त करता है।
अब, इन उदाहरणों के संदर्भ में, निम्नलिखित पत्र से मुख्य निष्कर्षों को सारांशित करें:
पत्र का शीर्षक: "बड़े भाषा मॉडल में प्रॉम्प्ट इंजीनियरिंग: एक परीक्षा"
यह प्रॉम्प्ट न केवल एक स्पष्ट सोच श्रृंखला बनाए रखता है, बल्कि कुछ-शॉट लर्निंग दृष्टिकोण का भी उपयोग करता है ताकि मॉडल को निर्देशित किया जा सके कि कैसे जटिल कार्यों को पूरा किया जाए, जो प्रॉम्प्ट इंजीनियरिंग से संबंधित है।
रिएक्ट प्रॉम्प्ट
रिएक्ट, या “तर्क और कार्रवाई”, गूगल (GOOGL ) द्वारा “रिएक्ट: भाषा मॉडल में तर्क और कार्रवाई का समन्वय” पत्र में पेश किया गया था, और यह कैसे भाषा मॉडल एक कार्य के साथ बातचीत करते हैं, इसे क्रांतिकारी बना दिया।
एक मानव शेफ की कल्पना करें जो रसोई में है: वे न केवल कार्यों की एक श्रृंखला (सब्जियों को काटना, पानी को उबालना, सामग्री को हिलाना) करते हैं, बल्कि मानसिक तर्क या आंतरिक बोली (अब सब्जियां कट जाने के बाद, मुझे बर्तन को स्टोव पर रखना चाहिए) में भी संलग्न होते हैं। यह निरंतर मानसिक संवाद प्रक्रिया को रणनीतिक बनाने में मदद करता है, इसे अनुकूलित करता है अचानक हुए परिवर्तनों के लिए (मैं जैतून का तेल खत्म हो गया है, मैं मक्खन का उपयोग करूंगा), और कार्यों की श्रृंखला को याद रखने में मदद करता है। रिएक्ट इस मानवीय क्षमता की नकल करता है, मॉडल को नए कार्यों को जल्दी से सीखने और नए या अनिश्चित परिस्थितियों में मानव की तरह मजबूत निर्णय लेने में सक्षम बनाता है।
रिएक्ट चेन-ऑफ-थॉट (सीओटी) प्रणालियों के साथ एक सामान्य समस्या, हॉल्यूसिनेशन का सामना करने में सक्षम है। सीओटी, हालांकि एक प्रभावी तकनीक है, बाहरी दुनिया के साथ बातचीत करने की क्षमता की कमी के कारण तथ्यों की कल्पना और त्रुटि प्रसार का कारण बन सकती है। रिएक्ट, हालांकि, इसे बाहरी स्रोतों के साथ बातचीत करके मुआवजा देता है, जिससे प्रणाली न केवल अपने तर्क को मान्य कर सकती है बल्कि बाहरी दुनिया से नवीनतम जानकारी के आधार पर अपने ज्ञान को अद्यतन कर सकती है।
रिएक्ट का मूल कार्य एक उदाहरण के माध्यम से समझाया जा सकता है जो हॉटपोटक्यूए से है, जो उच्च-क्रम तर्क की आवश्यकता वाला एक कार्य है। प्रश्न प्राप्त करने पर, रिएक्ट मॉडल प्रश्न को प्रबंधनीय भागों में तोड़ देता है, एक कार्रवाई योजना बनाता है, एक तर्क संबंधी निशान उत्पन्न करता है (विचार), और एक प्रासंगिक कार्रवाई की पहचान करता है; यह Apple (AAPL ) Remote के बारे में विकिपीडिया जैसे बाहरी स्रोत पर जानकारी खोजने का निर्णय ले सकता है (कार्रवाई), और प्राप्त जानकारी के आधार पर अपनी समझ को अद्यतन करता है (अवलोकन)। विचार-क्रिया-अवलोकन चरणों के माध्यम से, रिएक्ट जानकारी प्राप्त करने के लिए अपने तर्क को परिष्कृत करता है और यह निर्धारित करता है कि आगे क्या प्राप्त करने की आवश्यकता है।
नोट: HotpotQA विकिपीडिया से तैयार 113,000 प्रश्न-उत्तर युग्मों का डेटासेट है। इसके प्रश्नों के उत्तर देने के लिए कई दस्तावेजों पर तर्क करना पड़ता है। वहीं, गेमीफिकेशन से तैयार CommonsenseQA 2.0 में, अंग्रेज़ी मूल के अनुसार, 14,343 हाँ/नहीं वाले प्रश्न हैं, जिन्हें सामान्य समझ की जाँच करने और मॉडल को भ्रमित करने के लिए बनाया गया है।
प्रक्रिया इस प्रकार दिख सकती है:
- विचार: “मुझे एप्पल रिमोट और इसके संगत उपकरणों के बारे में खोज करने की आवश्यकता है।”
- कार्रवाई: “एप्पल रिमोट संगत उपकरणों” को बाहरी स्रोत पर खोजें।
- अवलोकन: बाहरी स्रोत से प्राप्त परिणामों से संगत उपकरणों की सूची प्राप्त करें।
- विचार: “खोज परिणामों के आधार पर, कई उपकरण हैं जो मूल रूप से एप्पल रिमोट के साथ बातचीत करने के लिए डिज़ाइन किए गए थे, लेकिन कार्यक्रम में मूल रूप से जुड़े कार्यक्रम को नियंत्रित करने में सक्षम हैं।”
परिणाम एक गतिशील, तर्कसंगत प्रक्रिया है जो बातचीत की जानकारी के आधार पर विकसित हो सकती है, जिससे अधिक सटीक और विश्वसनीय प्रतिक्रियाएं संभव हो सकती हैं।

हॉटपोटक्यूए और ALFWorld (https://arxiv.org/pdf/2210.03629.pdf) को हल करने में चार प्रॉम्प्टिंग विधियों—Standard, Chain-of-Thought, Act-Only और ReAct—की तुलनात्मक प्रस्तुति
रिएक्ट एजेंटों का डिज़ाइन एक विशेषज्ञ कार्य है, इसकी जटिल उद्देश्यों को प्राप्त करने की क्षमता को देखते हुए। उदाहरण के लिए, एक बातचीत एजेंट, जो बेस रिएक्ट मॉडल पर बनाया गया है, बातचीत मेमोरी को एकीकृत करता है ताकि समृद्ध बातचीत प्रदान की जा सके। हालांकि, इस कार्य की जटिलता को लैंगचेन जैसे उपकरणों द्वारा सुव्यवस्थित किया जाता है, जो इन एजेंटों को डिज़ाइन करने के लिए मानक बन गया है।
संदर्भ-विश्वासी प्रॉम्प्टिंग
पत्र ‘बड़े भाषा मॉडल के लिए संदर्भ-विश्वासी प्रॉम्प्टिंग‘ पर जोर देता है कि जबकि एलएलएम ने ज्ञान-संचालित एनएलपी कार्यों में महत्वपूर्ण सफलता दिखाई है, उनकी पैरामेट्रिक ज्ञान पर अत्यधिक निर्भरता उन्हें संदर्भ-संवेदनशील कार्यों में भटका सकती है। उदाहरण के लिए, जब एक भाषा मॉडल पुराने तथ्यों पर प्रशिक्षित होता है, तो यह गलत उत्तर दे सकता है यदि यह संदर्भ संकेतों को नजरअंदाज करता है।
यह समस्या ज्ञान संघर्ष के उदाहरणों में स्पष्ट है, जहां संदर्भ में तथ्य एलएलएम के पूर्व-प्रशिक्षित ज्ञान से भिन्न होते हैं। एक उदाहरण के रूप में, एक एलएलएम जो 2022 विश्व कप से पहले के डेटा पर प्रशिक्षित है, जो संदर्भ में संकेत देता है कि फ्रांस ने टूर्नामेंट जीता है, फिर भी पिछले विजेता, यानी 2018 में जीतने वाली टीम को अभी भी वर्तमान चैंपियन के रूप में दावा कर सकता है। यह एक क्लासिक मामला है ‘ज्ञान संघर्ष’।
सारांश में, एलएलएम में ज्ञान संघर्ष तब उत्पन्न होता है जब संदर्भ में प्रदान की गई नई जानकारी मॉडल के पूर्व-प्रशिक्षित ज्ञान के विरोधाभासी होती है। मॉडल की पूर्व-प्रशिक्षित ज्ञान पर निर्भरता की प्रवृत्ति गलत आउटपुट का कारण बन सकती है। दूसरी ओर, एलएलएम में हॉल्यूसिनेशन ऐसे उत्तरों का उत्पादन है जो यथार्थवादी लग सकते हैं लेकिन मॉडल के प्रशिक्षण डेटा या प्रदान किए गए संदर्भ में निहित नहीं हैं।
एक और मुद्दा तब उत्पन्न होता है जब प्रदान किए गए संदर्भ में पर्याप्त जानकारी नहीं होती है ताकि प्रश्न का सटीक उत्तर दिया जा सके, एक स्थिति जिसे संयम के साथ भविष्यवाणी के रूप में जाना जाता है। उदाहरण के लिए, यदि एक एलएलएम से माइक्रोसॉफ्ट (MSFT ) के संस्थापक के बारे में पूछा जाए तो संदर्भ में यह जानकारी नहीं होने पर यह अनुमान लगाने से इनकार कर देना चाहिए।
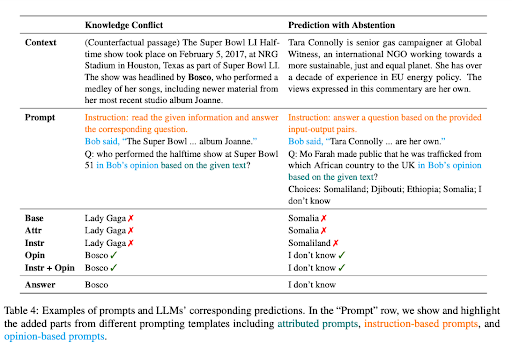
ज्ञान संघर्ष और संयम की शक्ति के और उदाहरण
इन दृश्यों में एलएलएम की संदर्भ विश्वासीयता में सुधार करने के लिए, शोधकर्ताओं ने विभिन्न प्रॉम्प्टिंग रणनीतियों का प्रस्ताव दिया। ये रणनीतियां एलएलएम की प्रतिक्रियाओं को संदर्भ के प्रति अधिक संवेदनशील बनाने का लक्ष्य रखती हैं, न कि अपने पूर्व-प्रशिक्षित ज्ञान पर।
एक ऐसी रणनीति यह है कि प्रॉम्प्ट को राय-आधारित प्रश्नों के रूप में तैयार किया जाए, जहां संदर्भ को एक कथाकार के बयान के रूप में व्याख्या किया जाता है, और प्रश्न इस कथाकार की राय से संबंधित होता है। यह दृष्टिकोण एलएलएम का ध्यान प्रस्तुत संदर्भ पर केंद्रित करता है, न कि अपने पूर्व-प्रशिक्षित ज्ञान पर।
प्रॉम्प्ट में तथ्य-विपरीत उदाहरण जोड़ना भी ज्ञान संघर्ष के मामलों में विश्वासीयता बढ़ाने का एक प्रभावी तरीका साबित हुआ है। ये प्रदर्शन झूठे तथ्यों वाले दृश्यों को प्रस्तुत करते हैं, जो मॉडल को संदर्भ पर अधिक ध्यान केंद्रित करने और सटीक प्रतिक्रियाएं प्रदान करने के लिए मार्गदर्शन करते हैं।
निर्देश फाइन-ट्यूनिंग
निर्देश फाइन-ट्यूनिंग एक पर्यवेक्षित शिक्षण चरण है जो मॉडल को विशिष्ट निर्देश प्रदान करने पर केंद्रित है, जैसे “सूर्योदय और सूर्यास्त के बीच के अंतर की व्याख्या करें।” निर्देश को एक उपयुक्त उत्तर के साथ जोड़ा जाता है, जैसे “सूर्योदय सूर्य के क्षितिज से ऊपर आने का क्षण है सुबह में, जबकि सूर्यास्त सूर्य के क्षितिज से नीचे जाने का बिंदु है शाम को।” इस विधि के माध्यम से, मॉडल निर्देशों का पालन करना और उन्हें निष्पादित करना सीखता है।
यह दृष्टिकोण एलएलएम को प्रॉम्प्ट करने की प्रक्रिया को काफी प्रभावित करता है, जिससे प्रॉम्प्टिंग शैली में एक क्रांतिकारी परिवर्तन होता है। एक निर्देश फाइन-ट्यून किए गए एलएलएम को तुरंत शून्य-शॉट कार्यों को निष्पादित करने की अनुमति देता है, प्रतिक्रिया प्रदान करता है जो कार्य के लिए उपयुक्त हैं। यदि एलएलएम अभी तक फाइन-ट्यून नहीं किया गया है, तो कुछ-शॉट लर्निंग दृष्टिकोण की आवश्यकता हो सकती है, जिसमें प्रॉम्प्ट में कुछ उदाहरण शामिल होते हैं ताकि मॉडल को वांछित प्रतिक्रिया की ओर मार्गदर्शन किया जा सके।
“जीपीटी-4 के साथ निर्देश ट्यूनिंग” में जीपीटी-4 का उपयोग एलएलएम के फाइन-ट्यूनिंग के लिए निर्देश-आधारित डेटा उत्पन्न करने का प्रयास किया गया है। उन्होंने 52,000 अद्वितीय निर्देश-आधारित प्रविष्टियों का एक समृद्ध डेटासेट का उपयोग किया, जो अंग्रेजी और चीनी दोनों में है।
डेटासेट एलएलएम के निर्देश ट्यूनिंग में एक महत्वपूर्ण भूमिका निभाता है, विशेष रूप से एलएलएमए मॉडल के लिए, जो खुले स्रोत एलएलएम श्रृंखला है, जिससे नए कार्यों पर शून्य-शॉट प्रदर्शन में सुधार होता है। उल्लेखनीय परियोजनाएं जैसे स्टैनफोर्ड अल्पाका ने प्रभावी ढंग से स्व-निर्देश ट्यूनिंग का उपयोग किया है, जो मानव इरादे के साथ एलएलएम को संरेखित करने का एक कुशल तरीका है, जो उन्नत निर्देश-ट्यून किए गए शिक्षक मॉडल द्वारा उत्पन्न डेटा का लाभ उठाता है।

निर्देश ट्यूनिंग शोध का प्राथमिक उद्देश्य एलएलएम की शून्य-शॉट और कुछ-शॉट सामान्यीकरण क्षमताओं को बढ़ाना है। आगे के डेटा और मॉडल स्केलिंग से मूल्यवान अंतर्दृष्टि प्राप्त हो सकती है। वर्तमान जीपीटी-4 डेटा आकार 52K और बेस एलएलएमए मॉडल आकार 7 बिलियन पैरामीटर पर, जीपीटी-4 निर्देश-आधारित डेटा एकत्र करने और इसे अन्य डेटा स्रोतों के साथ जोड़ने की क्षमता के साथ-साथ बड़े एलएलएमए मॉडल को प्रशिक्षित करने की क्षमता के लिए बड़ी संभावनाएं हैं जो बेहतर प्रदर्शन प्रदान कर सकते हैं।
एसटीएआर: तर्क के साथ तर्क की शुरुआत
एलएलएम की क्षमता विशेष रूप से जटिल तर्क कार्यों जैसे गणित या सामान्य ज्ञान प्रश्न-उत्तर में दिखाई देती है। हालांकि, एक भाषा मॉडल को तर्क उत्पन्न करने के लिए प्रेरित करने की प्रक्रिया – एक क्रमिक तर्क की श्रृंखला या “तर्क श्रृंखला” – अपने सेट के साथ चुनौतियां पेश करती है। यह अक्सर बड़े तर्क डेटासेट का निर्माण या केवल कुछ-शॉट अनुमान पर निर्भर रहने के कारण सटीकता में समझौता करने की आवश्यकता होती है।
“स्व-शिक्षित तर्कसंगत” (एसटीएआर) इस चुनौती के लिए एक नवाचारी समाधान प्रदान करता है। यह एक सरल लूप का उपयोग करके मॉडल की तर्क क्षमता को लगातार बेहतर बनाने के लिए एक प्रक्रिया को रोजगार देता है। इस प्रक्रिया की शुरुआत में, मॉडल को कुछ तर्क उदाहरणों का उपयोग करके कई प्रश्नों के उत्तर देने के लिए तर्क उत्पन्न करने के लिए कहा जाता है। यदि उत्पन्न उत्तर गलत हैं, तो मॉडल फिर से तर्क उत्पन्न करने का प्रयास करता है, इस बार सही उत्तर प्रदान करता है। मॉडल तब उन सभी तर्कों पर फाइन-ट्यून किया जाता है जो सही उत्तरों में परिणत होते हैं, और प्रक्रिया दोहराई जाती है।

स्टार पद्धति, अपने फाइन-ट्यूनिंग लूप और सामान्य ज्ञान प्रश्न-उत्तर डेटासेट पर एक नमूना तर्क-व्याख्याओं के निर्माण (https://arxiv.org/pdf/2203.14465.pdf) को प्रदर्शित करता है
एक व्यावहारिक उदाहरण के रूप में, एसटीएआर मॉडल से पूछा जा सकता है कि एक छोटे कुत्ते को ले जाने के लिए क्या उपयोग किया जा सकता है, जिसमें विकल्प शामिल हैं जैसे कि तैराकी पूल से लेकर टोकरी तक। एसटीएआर मॉडल तर्क उत्पन्न करता है कि उत्तर कुछ ऐसा होना चाहिए जो चीजों को पकड़ने में सक्षम हो, और निष्कर्ष निकालता है कि एक टोकरी, जो चीजों को पकड़ने के लिए डिज़ाइन की गई है, सही उत्तर है।
एसटीएआर का दृष्टिकोण अद्वितीय है क्योंकि यह मॉडल की मौजूदा तर्क क्षमता का लाभ उठाता है। यह तर्क-व्याख्याओं के निर्माण और समस्या समाधान की एक प्रक्रिया को रोजगार देता है, जो मॉडल को स्वयं अपने तर्क को सुधारने और बढ़ाने में सक्षम बनाता है। हालांकि, एसटीएआर के लूप में सीमाएं हैं; मॉडल उन समस्याओं को हल करने में विफल हो सकता है जिन्हें वह हल करने में विफल रहता है क्योंकि यह उन समस्याओं के लिए कोई सीधा प्रशिक्षण संकेत प्राप्त नहीं करता है। एसटीएआर इस मुद्दे को तर्कीकरण की शुरुआत करके संबोधित करता है। हर उस समस्या के लिए जिसे मॉडल सही ढंग से हल नहीं कर पाता, यह मॉडल को सही उत्तर प्रदान करके एक नया तर्क उत्पन्न करता है, जिससे मॉडल पीछे की ओर तर्क करने में सक्षम होता है।
एसटीएआर, इसलिए, एक मापनीय बूटस्ट्रैपिंग विधि के रूप में कार्य करता है जो मॉडल को अपने तर्क को सिखाने और साथ ही साथ जटिल समस्याओं को हल करने में सक्षम बनाता है। एसटीएआर के अनुप्रयोग गणित, शब्द समस्याओं और सामान्य ज्ञान तर्क में आशाजनक परिणाम दिखाते हैं, CommonsenseQA पर इसने फ्यू-शॉट बेसलाइन और सीधे उत्तरों की भविष्यवाणी के लिए फाइन-ट्यून की गई बेसलाइन, दोनों से बेहतर प्रदर्शन किया और 30 गुना बड़े मॉडल के तुलनीय परिणाम दिए।
टैग किए गए संदर्भ प्रॉम्प्ट
‘टैग किए गए संदर्भ प्रॉम्प्ट‘ की अवधारणा मॉडल को इनपुट में अतिरिक्त संदर्भ प्रदान करने के लिए टैग का उपयोग करने के इर्द-गिर्द घूमती है। ये टैग मूल रूप से एआई के लिए मार्गदर्शक के रूप में कार्य करते हैं, जो संदर्भ को सटीक रूप से व्याख्या करने और तथ्यात्मक प्रतिक्रिया उत्पन्न करने में मदद करते हैं।
एक दोस्त के साथ बातचीत की कल्पना करें जिसमें आप एक विशिष्ट विषय, जैसे ‘शतरंज’ पर चर्चा कर रहे हैं। आप एक बयान देते हैं और फिर इसे ‘(स्रोत: विकिपीडिया)’ जैसे संदर्भ के साथ टैग करते हैं। अब, आपका दोस्त, जो एआई मॉडल है, जानता है कि आपकी जानकारी कहां से आ रही है। यह दृष्टिकोण एआई की प्रतिक्रियाओं को अधिक विश्वसनीय बनाने में मदद करता है, हॉल्यूसिनेशन या गलत तथ्यों के उत्पादन के जोखिम को कम करता है।
टैग किए गए संदर्भ प्रॉम्प्ट का एक अनोखा पहलू यह है कि वे एआई मॉडल की ‘संदर्भ बुद्धिमत्ता’ में सुधार करने की क्षमता रखते हैं। उदाहरण के लिए, पत्र में विभिन्न विषयों पर सारांशित विकिपीडिया लेखों और हाल ही में प्रकाशित पुस्तक के खंडों से निकाले गए प्रश्नों का उपयोग करके यह प्रदर्शित किया जाता है। प्रश्न टैग किए जाते हैं, जो मॉडल को अतिरिक्त संदर्भ प्रदान करते हैं कि जानकारी का स्रोत क्या है।
यह अतिरिक्त संदर्भ प्रतिक्रियाओं को उत्पन्न करने में अत्यधिक लाभदायक साबित हो सकता है जो न केवल सटीक हैं बल्कि प्रदान किए गए संदर्भ के अनुरूप भी हैं। यह एआई के आउटपुट को अधिक विश्वसनीय और विश्वासपात्र बनाने में मदद करता है।
निष्कर्ष: आशाजनक तकनीकों और भविष्य की दिशाओं की एक झलक
ओपनएआई का चैटजीपीटी बड़े भाषा मॉडल (एलएलएम) की क्षमता को जटिल कार्यों को प्रभावी ढंग से हल करने में प्रदर्शित करता है। उन्नत तकनीकों जैसे कुछ-शॉट लर्निंग, रिएक्ट प्रॉम्प्टिंग, चेन-ऑफ-थॉट, और एसटीएआर, हमें विभिन्न अनुप्रयोगों में इनकी क्षमता का लाभ उठाने में सक्षम बनाते हैं। जैसा कि हम इन पद्धतियों की बारीकियों में गहराई से जाते हैं, हम खोजते हैं कि वे एआई के परिदृश्य को कैसे आकार दे रहे हैं, मानव और मशीनों के बीच समृद्ध और सुरक्षित इंटरैक्शन प्रदान करते हैं।
हॉल्यूसिनेशन, पैरामेट्रिक ज्ञान पर अत्यधिक निर्भरता, और संदर्भ-संवेदनशील कार्यों में चुनौतियों के बावजूद, ये एआई मॉडल, सही प्रॉम्प्ट इंजीनियरिंग के साथ, परिवर्तनकारी उपकरण साबित हुए हैं। निर्देश फाइन-ट्यूनिंग, संदर्भ-विश्वासी प्रॉम्प्टिंग, और बाहरी डेटा स्रोतों के साथ एकीकरण उनकी तर्क, सीखने और अनुकूलन क्षमता को और बढ़ाते हैं।


