
निगरानी
कम गुणवत्ता वाले सिंथेटिक चेहरे चेहरा पहचान में सुधार कर सकते हैं

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें
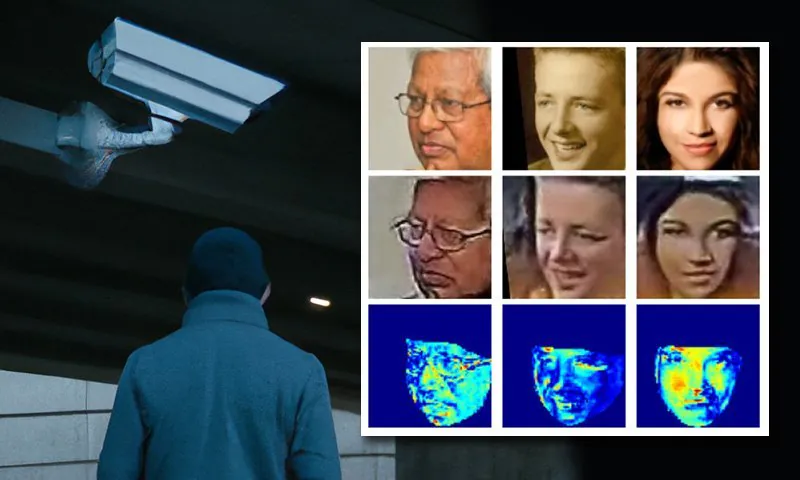
मुख्य बिंदुवास्तविक निगरानी फुटेज जैसी शैली में बनाए गए सिंथेटिक चेहरे उस डोमेन अंतराल को पाट सकते…
और देखें
- वास्तविक निगरानी फुटेज जैसी शैली में बनाए गए सिंथेटिक चेहरे उस डोमेन अंतराल को पाट सकते हैं जो पहचान की सटीकता को गंभीर रूप से प्रभावित करता है।
- पुरानी CCTV प्रणालियाँ तकनीकी ऋण से ग्रस्त हैं, जिसके कारण वे आधुनिक चेहरा पहचान प्रशिक्षण के लिए खराब डेटा स्रोत बन जाती हैं।
- प्रतिकूल तकनीकें केवल पहचान की सटीकता के लिए खतरा बनने के बजाय उसे मजबूत भी बना सकती हैं।
मिशिगन स्टेट यूनिवर्सिटी के शोधकर्ताओं ने एक तरीका खोजा है जिससे सिंथेटिक चेहरे डीपफेक्स दृश्य से ब्रेक ले सकते हैं और दुनिया में कुछ अच्छा कर सकते हैं – चेहरा पहचान प्रणालियों को अधिक सटीक बनाने में मदद करके।
उन्होंने जिस नए नियंत्रण योग्य चेहरा संश्लेषण मॉड्यूल (सीएफएसएम) को विकसित किया है, वह वास्तविक दुनिया के वीडियो निगरानी फुटेज की शैली में चेहरों को पुन: उत्पन्न करने में सक्षम है, बजाय इसके कि लोकप्रिय ओपन सोर्स डेटासेट में उपयोग किए जाने वाले मशहूर हस्तियों के अपेक्षाकृत एकसमान उच्च-गुणवत्ता वाले चित्रों पर निर्भर रहे। ये डेटासेट वास्तविक CCTV प्रणालियों की सभी कमियाँ नहीं दर्शाते, जैसे धुँधले चेहरे, कम रिज़ॉल्यूशन और सेंसर नॉइज़, जो पहचान की सटीकता को प्रभावित कर सकते हैं।

नियंत्रण योग्य चेहरा संश्लेषण मॉड्यूल (सीएफएसएम) के लिए अवधारणात्मक वास्तुकला। स्रोत: http://cvlab.cse.msu.edu/pdfs/Liu_Kim_Jain_Liu_ECCV2022.pdf
सीएफएसएम का उद्देश्य विशेष रूप से सिर की स्थिति, अभिव्यक्तियों या डीपफेक प्रणालियों के उद्देश्य के अन्य सभी सामान्य गुणों को प्रामाणिक रूप से अनुकरण करना नहीं है, बल्कि लक्ष्य पहचान प्रणाली की शैली में वैकल्पिक दृश्यों की एक श्रृंखला उत्पन्न करना है, शैली स्थानांतरण का उपयोग करके।
प्रणाली लक्ष्य प्रणाली के शैली डोमेन की नकल करने और अपने आउटपुट को उस डोमेन में रिज़ॉल्यूशन तथा विभिन्न प्रकार की विशिष्ट खामियों के अनुसार अनुकूलित करने के लिए डिज़ाइन की गई है। इसका उपयोग उन पुरानी प्रणालियों में हो सकता है जिन्हें लागत के कारण शायद अपग्रेड न किया जाए। कभी अत्याधुनिक रहे उनके आउटपुट की गुणवत्ता अब इतनी कम है कि वे नई पीढ़ी की चेहरा पहचान तकनीकों में बहुत कम योगदान दे पाते हैं।
प्रणाली का परीक्षण करते समय, शोधकर्ताओं ने पाया कि यह शोर और कम गुणवत्ता वाले डेटा के साथ चेहरा पहचान प्रणालियों में मौजूदा सर्वश्रेष्ठ तकनीकों की तुलना में उल्लेखनीय लाभ प्रदान करता है।

लक्ष्य चेहरा पहचान मॉडल को लक्ष्य प्रणालियों की सीमाओं के अनुकूल होने के लिए प्रशिक्षित करना। स्रोत: http://cvlab.cse.msu.edu/pdfs/Liu_Kim_Jain_Liu_ECCV2022_supp.pdf
उन्होंने प्रक्रिया का एक उपयोगी उप उत्पाद भी पाया – लक्ष्य डेटासेट की विशेषताएँ बताना और उनकी आपस में तुलना करना अब संभव है। इससे भविष्य में विभिन्न CCTV प्रणालियों के लिए तुलना, बेंचमार्किंग और विशेष डेटासेट तैयार करना आसान हो जाता है।
इसके अलावा, विधि को मौजूदा डेटासेट पर लागू किया जा सकता है, जो डी फैक्टो डोमेन अनुकूलन करता है और उन्हें चेहरा पहचान प्रणालियों के लिए अधिक उपयुक्त बनाता है।
नया पत्र शीर्षक नियंत्रित और निर्देशित चेहरा संश्लेषण अनियंत्रित चेहरा पहचान के लिए है, जो अमेरिकी खुफिया निदेशक कार्यालय (ओडीएनआई, आईएआरपीए में) द्वारा आंशिक रूप से समर्थित है, और एमएसयू के कंप्यूटर साइंस एंड इंजीनियरिंग विभाग में चार शोधकर्ताओं से आता है।
विशेष सामग्री
कम गुणवत्ता वाला चेहरा पहचान (एलक्यूएफआर) पिछले कुछ वर्षों में एक उल्लेखनीय अध्ययन क्षेत्र बन गया है। क्योंकि नागरिक और नगरपालिका अधिकारियों ने वीडियो निगरानी प्रणालियों को लचीला और दीर्घकालिक बनाने के लिए निर्मित किया है (संसाधनों को इस समस्या के लिए आवर्ती रूप से पुनः आवंटित नहीं करना चाहते हैं), कई ‘विरासत’ निगरानी नेटवर्क तकनीकी ऋण के शिकार हो गए हैं, अपनी मशीन लर्निंग डेटा स्रोत के रूप में अनुकूलन के संदर्भ में।

विभिन्न ऐतिहासिक और हाल के वीडियो निगरानी प्रणालियों में चेहरे के रिज़ॉल्यूशन के विभिन्न स्तर। स्रोत: https://arxiv.org/pdf/1805.11519.pdf
सौभाग्य से, यह एक ऐसा कार्य है जो डिफ्यूज़न मॉडल और अन्य शोर-आधारित मॉडल असामान्य रूप से अच्छी तरह से हल करने के लिए अनुकूल हैं। हाल के वर्षों में कई सबसे लोकप्रिय और प्रभावी छवि संश्लेषण प्रणालियां उपस्केलिंग करती हैं कम गुणवत्ता वाली छवियों को अपने पाइपलाइन के हिस्से के रूप में, जबकि यह तंत्रिका संपीड़न तकनीकों के लिए भी आवश्यक है (छवियों और फिल्मों को तंत्रिका डेटा के रूप में बचाने के तरीके बजाय बिटमैप डेटा के रूप में)।
चेहरा पहचान की एक चुनौती यह है कि न्यूनतम संभव विशेषताओं से अधिकतम संभव सटीकता प्राप्त करना है जो कम गुणवत्ता वाली छवियों से निकाला जा सकता है। यह प्रतिबंध केवल इसलिए नहीं है क्योंकि यह कम रिज़ॉल्यूशन पर एक चेहरा पहचानने या बनाने में सक्षम होने के लिए उपयोगी है, बल्कि इसलिए भी क्योंकि प्रशिक्षण में उपलब्ध स्थानीय जीपीयू पर उपलब्ध वीआरएएम के आकार पर तकनीकी सीमाएं हैं।
इस संदर्भ में, ‘विशेषताएं’ शब्द भ्रमित करने वाला है, क्योंकि ऐसी विशेषताएं पार्क बेंचों के डेटासेट से भी प्राप्त की जा सकती हैं। कंप्यूटर दृष्टि क्षेत्र में, ‘विशेषताएं’ विशिष्ट विशेषताओं को संदर्भित करता है जो छवियों से प्राप्त की जाती हैं – किसी भी छवियों, चाहे वह एक चर्च की रेखाएं हों, एक पहाड़, या चेहरे की विशेषताओं का विभाजन एक चेहरे के डेटासेट में।
चूंकि कंप्यूटर दृष्टि एल्गोरिदम अब छवियों और वीडियो फुटेज को अपस्केल करने में सक्षम हैं, विभिन्न विधियों का प्रस्ताव किया गया है कम गुणवत्ता वाले या अन्यथा क्षयित विरासत निगरानी सामग्री को ‘सुधारने’ के लिए, जिससे यह संभव हो सकता है कानूनी उद्देश्यों के लिए ऐसे संवर्द्धन का उपयोग करना, जैसे कि अपराध जांच से संबंधित एक विशिष्ट व्यक्ति को एक दृश्य में रखना।
इसके अलावा, गलत पहचान की संभावना के अलावा, जो कभी-कभी सुर्खियाँ एकत्र करती है, सिद्धांत रूप में यह आवश्यक नहीं होना चाहिए कम गुणवत्ता वाले फुटेज को हाइपर-रिज़ॉल्यूशन या अन्यथा परिवर्तित करने के लिए एक व्यक्ति की सकारात्मक पहचान करने के लिए, क्योंकि एक चेहरा पहचान प्रणाली जो कम स्तर की विशेषताओं पर केंद्रित है उसे उस स्तर की रिज़ॉल्यूशन और स्पष्टता की आवश्यकता नहीं होनी चाहिए। इसके अलावा, ऐसे परिवर्तन व्यावहारिक रूप से महंगे हैं, और पुनरावृत्ति प्रश्न उनकी संभावित वैधता और कानूनी स्थिति के बारे में उठाते हैं।
मशहूर हस्तियों की अधिक निम्न-गुणवत्ता वाली तस्वीरों की आवश्यकता
यह अधिक उपयोगी होगा यदि एक चेहरा पहचान प्रणाली विरासत प्रणालियों के रूप में मौजूद आउटपुट से विशेषताएं (यानी, मानव विशेषताओं की मशीन लर्निंग विशेषताएं) निकाल सके, उच्च रिज़ॉल्यूशन पहचान और मौजूदा, आसानी से बदली न जा सकने वाली और अक्सर अपूरणीय वीडियो निगरानी प्रणालियों में उपलब्ध निम्न-गुणवत्ता वाली छवियों के बीच संबंध को बेहतर ढंग से समझकर।
समस्या यह है कि मानकों का एक मुद्दा है: सामान्य वेब-एकत्रित डेटासेट जैसे एमएस-सेलेब-1एम और वेबफेस260एम (अन्य लोगों के बीच), शोध समुदाय द्वारा अपनाए गए हैं क्योंकि वे निरंतर बेंचमार्क प्रदान करते हैं जिनके खिलाफ शोधकर्ता अपनी प्रगति को माप सकते हैं वर्तमान राज्य के खिलाफ।

माइक्रोसॉफ्ट के लोकप्रिय एमएस-सेलेब1म डेटासेट के उदाहरण。 स्रोत: https://www.microsoft.com/en-us/research/project/ms-celeb-1m-challenge-recognizing-one-million-celebrities-real-world/
हालांकि, लेखकों का तर्क है कि इन डेटासेट पर प्रशिक्षित चेहरा पहचान (एफआर) एल्गोरिदम कई पुराने निगरानी प्रणालियों के आउटपुट के ‘दृश्य डोमेन’ के लिए उपयुक्त सामग्री नहीं हैं।
लेख में कहा गया है*:
‘[सर्वश्रेष्ठ उपलब्ध तकनीक] (एसओटीए) एफआर मॉडल वास्तविक दुनिया की निगरानी छवियों (अनियंत्रित) पर अच्छा काम नहीं करते हैं क्योंकि डोमेन शिफ्ट समस्या है, अर्थात् वेब-तलाशी ली गई हस्तियों के चेहरों से प्राप्त बड़े पैमाने पर प्रशिक्षण डेटासेट (अर्ध-नियंत्रित) में वास्तविक दुनिया की निगरानी प्रणालियों के आउटपुट में मौजूद विविधताओं की कमी होती है, जैसे कि सेंसर शोर, कम रिज़ॉल्यूशन, मोशन ब्लर, टर्बुलेंस प्रभाव, आदि। ‘
‘उदाहरण के लिए, 1:1 सत्यापन सटीकता जो एक एसओटीए मॉडल द्वारा अनियंत्रित आईजेबी-एस डेटासेट पर रिपोर्ट की जाती है, अर्ध-नियंत्रित एलएफडब्ल्यू पर लगभग 30% कम है। ‘
‘एक संभावित उपाय यह हो सकता है एक बड़े पैमाने पर अनियंत्रित चेहरा डेटासेट का निर्माण करना। हालांकि, दसियों हज़ार व्यक्तियों वाले एक प्रशिक्षण डेटासेट का निर्माण करना मैनुअल लेबलिंग की ऊँची लागत के कारण अत्यंत कठिन है। ‘
लेखक विभिन्न पूर्व विधियों का उल्लेख करते हैं जिन्होंने ऐतिहासिक या कम लागत वाली निगरानी प्रणालियों के आउटपुट के विविध प्रकार के प्रकार को ‘मेल’ करने का प्रयास किया है, लेकिन नोट करते हैं कि वे ‘अंधे’ संवर्द्धन से निपटते हैं। इसके विपरीत, सीएफएसएम प्रशिक्षण के दौरान वास्तविक दुनिया के आउटपुट से लक्ष्य प्रणाली से सीधी प्रतिक्रिया प्राप्त करता है और शैली स्थानांतरण के माध्यम से उस डोमेन की नकल करने के लिए खुद को अनुकूलित करता है।

अभिनेत्री नताली पोर्टमैन, जो कंप्यूटर दृष्टि समुदाय में प्रमुख डेटासेट के हिस्से के रूप में जानी जाती हैं, सीएफएसएम द्वारा लक्ष्य मॉडल के डोमेन से प्रतिक्रिया पर आधारित शैली-मिलान वाले डोमेन अनुकूलन का प्रदर्शन करती हैं।
लेखकों द्वारा डिज़ाइन की गई वास्तुकला फास्ट ग्रेडिएंट साइन मेथड (एफजीएसएम) का उपयोग करके लक्ष्य प्रणाली के वास्तविक आउटपुट से प्राप्त शैलियों और विशेषताओं को अलग करने और ‘आयात’ करने के लिए किया जाता है। पाइपलाइन का हिस्सा जो छवि पीढ़ी के लिए समर्पित है बाद में प्रशिक्षण के साथ बेहतर हो जाएगा और लक्ष्य प्रणाली के लिए अधिक वफादार हो जाएगा। लक्ष्य प्रणाली के निम्न-आयामी शैली स्थान से मिलने वाली प्रतिक्रिया निम्न-स्तरीय होती है और सबसे व्यापक रूप से निकाले गए दृश्य विवरणकों से मेल खाती है।
लेखक टिप्पणी करते हैं:
‘एफआर मॉडल से प्रतिक्रिया के साथ, संश्लेषित छवियां एफआर प्रदर्शन के लिए अधिक लाभकारी हैं, जिससे एफआर मॉडल की सामान्यीकरण क्षमता में काफी सुधार होता है। ‘
परीक्षण
शोधकर्ताओं ने अपनी प्रणाली का परीक्षण करने के लिए एमएसयू के अपने पिछले काम को एक टेम्पलेट के रूप में उपयोग किया। उसी प्रायोगिक प्रोटोकॉल के आधार पर, उन्होंने वेब-तलाशी ली गई हस्तियों की तस्वीरों से युक्त एमएस-सेलेब-1एम को लेबल वाले प्रशिक्षण डेटासेट के रूप में उपयोग किया। न्यायसंगतता के लिए, उन्होंने एमएस1एम-वी2 को भी शामिल किया, जिसमें 3.9 मिलियन छवियां हैं जिनमें 85,700 वर्ग हैं।
लक्ष्य डेटा चीनी विश्वविद्यालय हांगकांग से वाइडरफेस डेटासेट था। यह चुनौतीपूर्ण स्थितियों में चेहरा पता लगाने के कार्यों के लिए डिज़ाइन किया गया एक विशेष रूप से विविध सेट छवियों का है। इस सेट से 70,000 छवियों का उपयोग किया गया था।
मूल्यांकन के लिए, प्रणाली का चार चेहरा पहचान बेंचमार्क के खिलाफ परीक्षण किया गया था: आईजेबी-बी, आईजेबी-सी, आईजेबी-एस, और टिनीफेस।
सीएफएसएम को एमएस-सेलेब-1एम के प्रशिक्षण डेटा का लगभग 10% के साथ प्रशिक्षित किया गया था, जो लगभग 0.4 मिलियन छवियां हैं, 32 बैच आकार के तहत 125,000 पुनरावृत्तियों के लिए एडम ऑप्टिमाइज़र के तहत 1e-4 की बहुत कम सीखने की दर पर।
लक्ष्य चेहरा पहचान मॉडल ने रेसनेट-50 का एक संशोधन प्रशिक्षण के दौरान आर्कफेस लॉस फंक्शन के साथ बैकबोन के रूप में उपयोग किया था। इसके अलावा, एक मॉडल को सीएफएसएम के साथ एक ablation और तुलनात्मक व्यायाम के रूप में प्रशिक्षित किया गया था (परिणाम तालिका में ‘आर्कफेस’ के रूप में चिह्नित)।

सीएफएसएम के लिए प्राथमिक परीक्षणों के परिणाम। उच्च संख्या बेहतर है।
लेखक प्राथमिक परिणामों पर टिप्पणी करते हैं:
‘आर्कफेस मॉडल दोनों चेहरा पहचान और सत्यापन कार्यों में सभी बेसलाइन्स को पार करता है, और एक नया सर्वश्रेष्ठ उपलब्ध तकनीक प्रदर्शन हासिल करता है। ‘
विभिन्न विरासत या कम-स्पेक्ड निगरानी प्रणालियों की विशेषताओं से डोमेन निकालने की क्षमता लेखकों को इन फ्रेमवर्क के बीच वितरण समानता की तुलना और मूल्यांकन करने और प्रत्येक प्रणाली को एक दृश्य शैली के संदर्भ में प्रस्तुत करने में सक्षम बनाती है जिसे बाद के कार्य में उपयोग किया जा सकता है।

विभिन्न डेटासेट से उदाहरण स्पष्ट रूप से शैली में अंतर प्रदर्शित करते हैं।
लेखक आगे टिप्पणी करते हैं कि उनकी प्रणाली कुछ प्रौद्योगिकियों का लाभ उठा सकती है जिन्हें अब तक शोध और दृष्टि समुदाय द्वारा केवल समस्याओं के रूप में देखा जाता है:
‘[सीएफएसएम] दिखाता है कि प्रतिकूल हेरफेर हमलावर होने के अलावा दृष्टि कार्यों में पहचान सटीकता में वृद्धि करने के लिए काम कर सकता है। इसके अलावा, हम सीखे गए शैली आधार पर एक डेटासेट समानता मेट्रिक को परिभाषित करते हैं, जो लेबल या पूर्वानुमानकर्ता पर निर्भर हुए बिना शैली में अंतर को पकड़ता है। ‘
‘हम मानते हैं कि हमारा शोध अनियंत्रित एफआर के लिए एक नियंत्रित और निर्देशित चेहरा संश्लेषण मॉडल की शक्ति को प्रस्तुत करता है और डेटासेट अंतर की समझ प्रदान करता है। ‘
* मेरा लेखकों के इनलाइन संदर्भों को हाइपरलिंक में परिवर्तन।
पहली बार 1 अगस्त 2022 को प्रकाशित।


