एआई की मूल बातें
कोडिंग और AI: कृत्रिम बुद्धिमत्ता में शुरुआती का मार्ग

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें
आप पेशेवर प्रोग्रामिंग अनुभव के बिना भी AI सीखना शुरू कर सकते हैं, लेकिन विश्वसनीय सिस्टम बनाने के लिए अंततः पर्याप्त कोडिंग, डेटा और मूल्यांकन कौशल की आवश्यकता होती है ताकि आप उपकरणों के कार्य को जांच सकें। सबसे तेज़ मार्ग मूलभूत सिद्धांतों से जुड़ी छोटी परियोजनाओं की श्रृंखला है, न कि असंबंधित ट्यूटोरियल्स की लंबी यात्रा।
AI-सहायता प्राप्त कोडिंग सिंटैक्स समझा सकती है, उदाहरण उत्पन्न कर सकती है, और डिबग करने में मदद कर सकती है। इसके आउटपुट को एक मसौदा के रूप में मानें: इसे चलाएँ, परीक्षण करें, दस्तावेज़ पढ़ें, और डेटा व अनुमतियों को समझें इससे पहले कि आप इस पर भरोसा करें।
मुख्य बिंदु
- बुनियादी Python, नोटबुक्स, Git, कमांड लाइन, और त्रुटियों को पढ़ना सीखें।
- एजेंट्स या बड़े मॉडल्स पर जाने से पहले एक छोटा सुपरवाइज्ड लर्निंग प्रोजेक्ट बनाएं।
- ट्रेन, वैलिडेशन, और टेस्ट डेटा का सही उपयोग करें; एक सरल बेसलाइन से तुलना करें।
- AI को फीडबैक लूप में मदद करने दें, लेकिन कोड, स्रोत, लाइसेंस, सुरक्षा और परिणामों को स्वयं सत्यापित करें।
चरण 1: प्रोग्रामिंग मूलभूत
वेरिएबल्स, कलेक्शन्स, कंडीशन्स, लूप्स, फ़ंक्शन्स, मॉड्यूल्स, फ़ाइलें, एनवायरनमेंट्स और एक्सेप्शन सीखें। CSV पढ़ने, रिकॉर्ड्स को ट्रांसफ़ॉर्म करने, दस्तावेज़ित API को कॉल करने, टेस्ट लिखने, और Git के माध्यम से बदलावों को ट्रैक करने का अभ्यास करें।
कोड लिखने से पहले उन्नत गणित की आवश्यकता नहीं है, लेकिन जैसे-जैसे प्रासंगिक हो, बुनियादी प्रायिकता, वेक्टर, औसत, वितरण और ग्राफ़ सीखना चाहिए। कम्प्यूटेशनल थिंकिंग एक अस्पष्ट लक्ष्य को परीक्षण योग्य चरणों में बदलने में मदद करती है।
चरण 2: एक पूर्ण ML प्रोजेक्ट
एक छोटा सार्वजनिक डेटासेट और एक स्पष्ट भविष्यवाणी प्रश्न चुनें। डेटा का अन्वेषण करें, स्वतंत्र विभाजन बनाएं, एक बेसलाइन बनाएं, एक सरल मॉडल को ट्रेन करें, त्रुटियों की जांच करें, और सीमाओं को लिखें। जब उपयुक्त हो, तो कस्टम न्यूरल नेटवर्क से पहले scikit-learn का उपयोग करें।
यह प्रोजेक्ट मशीन-लर्निंग अवधारणाओं को ठोस बनाता है: फीचर्स, लेबल्स, लीकज, ओवरफ़िटिंग, मीट्रिक्स, पुनरुत्पादनशीलता, और मॉडल स्कोर तथा उपयोगी निर्णय के बीच अंतर।
चरण 3: डीप लर्निंग और भाषा मॉडल्स
टेंसर, बैच, लॉस, ग्रेडिएंट डिसेंट, और बैकप्रोपेगेशन को एक छोटे इमेज या टेक्स्ट मॉडल के माध्यम से सीखें। फिर API या ओपन लाइब्रेरी के जरिए एक प्री‑ट्रेंड मॉडल का उपयोग करें, प्रॉम्प्ट्स और संस्करणों को रिकॉर्ड करें, और इसे एक सरल विधि से तुलना करें।
एक सीमित एप्लिकेशन में जेनरेटिव AI का अन्वेषण करें जिसमें रिट्रीवल या टूल उपयोग हो। वैलिडेशन, उद्धरण, अनुमतियां, और फॉलबैक जोड़ें ताकि प्रोजेक्ट सिस्टम इंजीनियरिंग के साथ-साथ प्रॉम्प्टिंग भी सिखाए।
AI कोडिंग सहायक को जानबूझकर उपयोग करें
छोटी फ़ंक्शन, टेस्ट, व्याख्याएँ, किनारी मामलों, और दस्तावेज़ीकरण संदर्भों के लिए पूछें। स्थैतिक जांच और टेस्ट चलाएँ, डिपेंडेंसी बदलावों की समीक्षा करें, और बिना अनुमति के कभी भी सीक्रेट्स या निजी डेटा पेस्ट न करें। यदि आप किसी महत्वपूर्ण लाइन को समझा नहीं पा रहे हैं, तो गति कम करें।
एक उपयोगी पोर्टफ़ोलियो प्रश्न, डेटा अधिकार, बेसलाइन, विधि, मूल्यांकन, त्रुटियों और आप क्या सुधारेंगे, यह दर्शाता है। पूर्ण, दस्तावेज़ीकृत छोटे प्रोजेक्ट बड़े डेमो से कॉपी किए कोड की तुलना में अधिक निर्णयशीलता दिखाते हैं।
समस्या से प्रोटोटाइप तक का व्यावहारिक सीखने का मार्ग
‘AI सीखना’ जैसी व्यापक आकांक्षा के बजाय एक विशिष्ट कार्य और प्रतिनिधिक उदाहरणों का छोटा सेट लेकर शुरू करें। सपोर्ट संदेशों को वर्गीकृत करना, इनवॉइस फ़ील्ड निकालना, या स्वीकृत दस्तावेज़ों से प्रश्नों के उत्तर देना देखे जा सकने वाले इनपुट और आउटपुट प्रदान करता है। मॉडल या टूल चुनने से पहले एक अच्छा परिणाम कैसा दिखेगा, यह लिखें।
नो‑कोड इंटरफ़ेस प्रॉम्प्टिंग, डेटा तैयारी, मूल्यांकन, और वर्कफ़्लो डिज़ाइन सिखा सकते हैं, लेकिन वे तकनीकी निर्णय की आवश्यकता को नहीं हटाते। टेबल, फ़ाइलें, API, ऑथेंटिकेशन, वेरिएबल्स, कंडीशन्स, और बुनियादी आँकड़े सीखें। ये अवधारणाएँ बताती हैं कि डेटा कैसे चलता है, इंटीग्रेशन क्यों विफल होते हैं, और मॉडल परिणाम क्या मतलब रखता है—और क्या नहीं।
एक सरल नियम, खोज विधि, स्प्रेडशीट, या छोटे मॉडल से बेसलाइन बनाएं। फिर उसी टेस्ट केस पर AI दृष्टिकोण की तुलना करें। बेसलाइन दिखाती है कि जटिलता मूल्य जोड़ती है या नहीं और शुरुआती को एक ठोस डिबगिंग लक्ष्य देती है। टेस्ट डेटा को उन उदाहरणों से अलग रखें जो सिस्टम को कॉन्फ़िगर या प्रॉम्प्ट करने के लिए उपयोग किए जाते हैं।
प्रॉम्प्टिंग, API और कोड में परिवर्तन
एक उपयोगी प्रॉम्प्ट कार्य, प्रासंगिक संदर्भ, प्रतिबंध, आउटपुट स्कीमा, और आवश्यक होने पर उदाहरण बताता है। प्रॉम्प्ट में बदलाव सॉफ़्टवेयर बदलाव होते हैं: उन्हें संस्करणित करें, एक स्थिर मूल्यांकन सेट के खिलाफ परीक्षण करें, और विफलताओं की जांच करें। मॉडल से मिलने वाले प्रवाहपूर्ण व्याख्याओं को यह प्रमाण न मानें कि उत्तर या उद्धृत साक्ष्य सही हैं।
वर्कफ़्लो बिल्डर मॉडल कॉल्स को फ़ॉर्म, डेटाबेस, फ़ाइलों और बिज़नेस एप्लिकेशन से जोड़ते हैं। समझें कि प्रत्येक चरण कौन सा डेटा तृतीय पक्षों को भेजता है, क्रेडेंशियल्स कैसे संग्रहीत होते हैं, और टाइमआउट या रीट्राई पर क्या होता है। प्रोटोटाइप को वास्तविक उपयोगकर्ताओं के साथ उपयोग करने से पहले इनपुट वैलिडेशन, संरचित आउटपुट, रेट लिमिट, मानव अनुमोदन, और लॉग जोड़ें।
कोड तब मूल्यवान बनता है जब वर्कफ़्लो को कस्टम लॉजिक, दोहराने योग्य टेस्ट, स्केलेबिलिटी, प्रदर्शन, पोर्टेबिलिटी, या विस्तृत सुरक्षा नियंत्रणों की आवश्यकता होती है। Python और JavaScript सामान्य प्रवेश बिंदु हैं, लेकिन भाषा की महत्ता मूलभूत सिद्धांतों से कम होती है: फ़ंक्शन, डेटा स्ट्रक्चर, पैकेज, त्रुटियां, वर्ज़न कंट्रोल, और टेस्ट। उत्पन्न कोड को केवल पढ़ने और सुरक्षित रूप से चलाने के बाद ही उपयोग करें।
पोर्टफ़ोलियो प्रोजेक्ट्स, मूल्यांकन, और करियर विकास
एक मजबूत शुरुआती प्रोजेक्ट समस्या, उपयोगकर्ता, डेटा अनुमतियां, बेसलाइन, आर्किटेक्चर, मूल्यांकन सेट, मीट्रिक्स, विफलताएं, जोखिम, और अगले कदमों का दस्तावेज़ीकरण करता है। मूल्यांकन के बिना एक परिष्कृत इंटरफ़ेस एक छोटे, पुनरुत्पादनीय प्रयोग से कम दर्शाता है। कोड, स्क्रीनशॉट, प्रॉम्प्ट या लॉग प्रकाशित करने से पहले निजी डेटा और सीक्रेट्स को हटा दें।
मॉडल की प्रभावशालीता के बजाय कार्य की सफलता का मूल्यांकन करें। वर्गीकरण को क्लास‑विशिष्ट प्रिसीजन और रिकॉल चाहिए; निष्कर्षण को फ़ील्ड सटीकता चाहिए; रिट्रीवल को साक्ष्य कवरेज चाहिए; जनरेशन को तथ्यात्मकता, उपयोगिता, सुरक्षा, लेटेंसी, और लागत चाहिए। विभिन्न भाषाओं, किनारी मामलों, और प्रभावित समूहों में प्रदर्शन की समीक्षा करें, और यह निर्धारित करें कि कब मानव को निर्णय लेना चाहिए।
AI कार्य में प्रोडक्ट मैनेजमेंट, डोमेन विशेषज्ञता, डेटा ऑपरेशन्स, मूल्यांकन, डिजाइन, सुरक्षा, नीति, और परिवर्तन प्रबंधन के साथ-साथ मॉडल विकास शामिल है। एक डोमेन में गहराई बनाएं और विभिन्न भूमिकाओं के साथ सहयोग के लिए पर्याप्त तकनीकी साक्षरता रखें। विश्वसनीय पोर्टफ़ोलियो ट्रेड‑ऑफ़ और सीमाओं को समझाते हैं, न कि हर प्रोटोटाइप को उत्पादन‑तैयार ऑटोमेशन के रूप में प्रस्तुत करते हैं।
व्यावहारिक उदाहरण: एक शुरुआती दस्तावेज़ ट्रायेज़ सहायक बनाता है
एक शिक्षार्थी सार्वजनिक या अनुमत दस्तावेज़ों का छोटा सेट इकट्ठा करता है और तीन श्रेणियों के साथ एक ‘अनिश्चित’ परिणाम परिभाषित करता है। वे लिखित नियम का उपयोग करके उदाहरणों को लेबल करते हैं, एक टेस्ट सेट आरक्षित करते हैं, और स्प्रेडशीट में कीवर्ड बेसलाइन लागू करते हैं। एक नो‑कोड मॉडल या API फिर एक संरचित श्रेणी और विश्वसनीयता लौटाता है, जिसे समान मामलों से तुलना की जाती है। गलत और अस्पष्ट उदाहरण सीखने की सामग्री बनते हैं, न कि डेमो में छिपे हुए।
वर्कफ़्लो एक फ़ाइल स्वीकार करता है, टेक्स्ट निकालता है, असमर्थित फ़ॉर्मेट हटाता है, मॉडल को एक स्थिर स्कीमा के साथ कॉल करता है, प्रतिक्रिया को वैलिडेट करता है, और अनिश्चित मामलों को समीक्षा के लिए भेजता है। यह केवल आवश्यक फ़ील्ड्स संग्रहीत करता है और प्रॉम्प्ट या साझा स्क्रीनशॉट में कभी भी क्रेडेंशियल्स शामिल नहीं करता। शिक्षार्थी मॉडल का नाम, प्रॉम्प्ट संस्करण, लेटेंसी, लागत, और आउटपुट रिकॉर्ड करता है ताकि परिवर्तन को स्मृति से नहीं, बल्कि परीक्षण द्वारा मूल्यांकन किया जा सके।
एक पोर्टफ़ोलियो रिपोर्ट प्रति‑क्लास प्रिसीजन और रिकॉल, गोपनीयता धारणाएं, विफलता उदाहरण, और प्रोटोटाइप व उत्पादन के बीच की सीमा दर्शाती है। अगला कोडिंग कदम एक नाज़ुक मैनुअल इंटीग्रेशन को छोटे परीक्षणित फ़ंक्शन या API से बदल सकता है। यह प्रगति ट्रांसफ़रेबल स्किल्स सिखाती है: समस्या परिभाषा, डेटा गुणवत्ता, मूल्यांकन, इंटरफ़ेस, त्रुटि प्रबंधन, सुरक्षा, और संचार। ये मूलभूत सिद्धांत एक सफल उदाहरण के बाद एक जटिल एजेंट बनाने का दावा करने से अधिक महत्वपूर्ण हैं।
व्यावहारिक कार्यान्वयन चेकलिस्ट
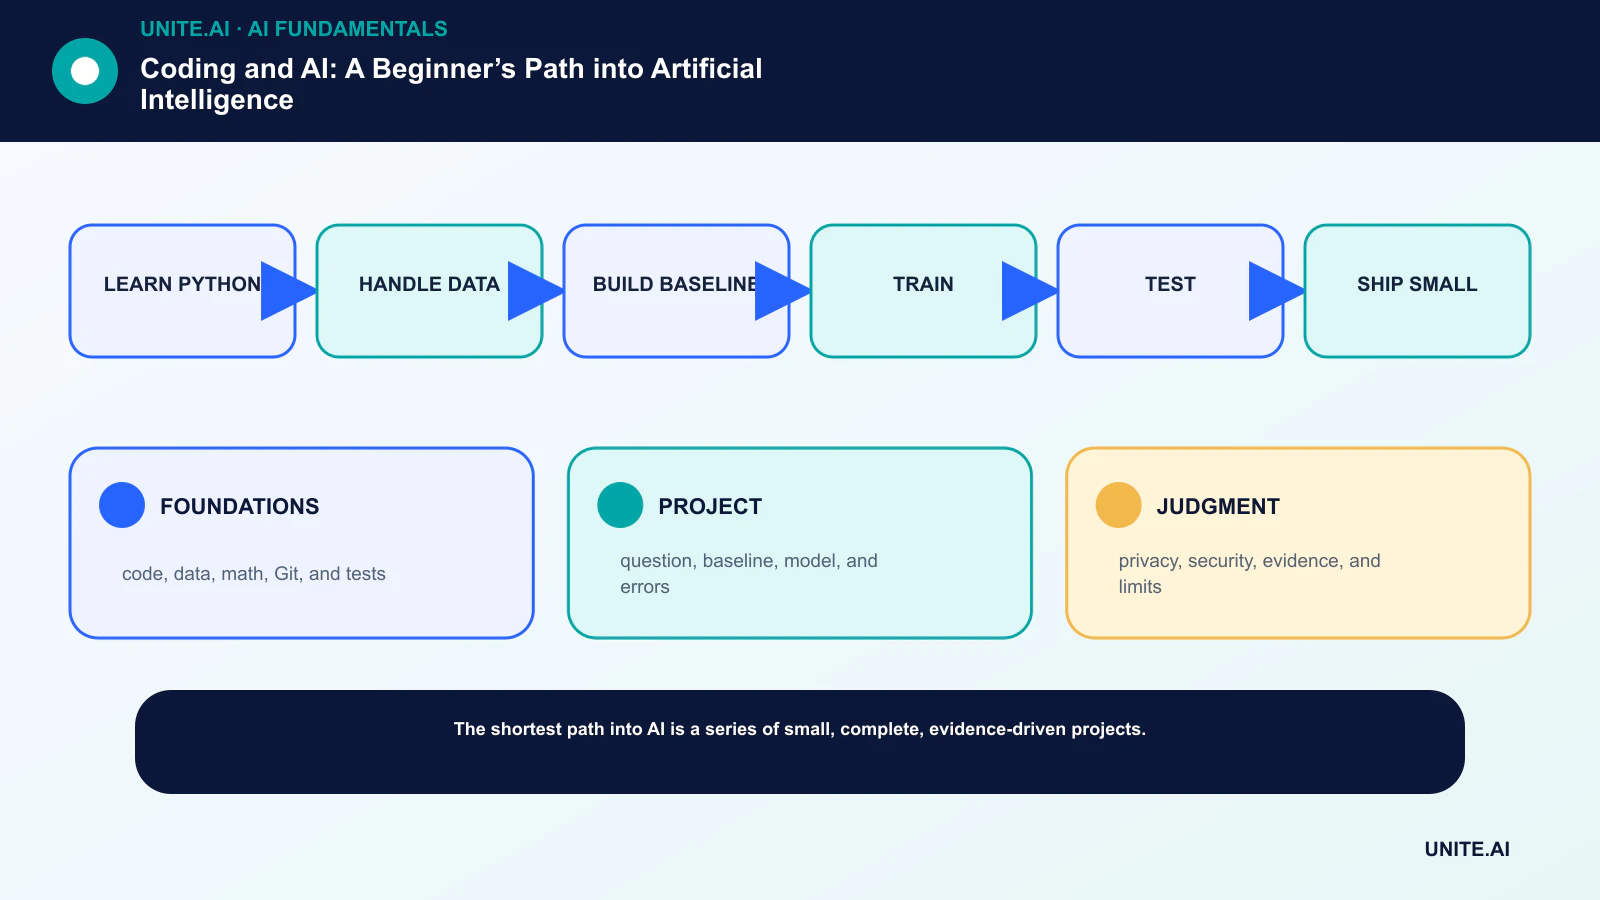
धारणा को एक सीमित, परीक्षण योग्य वर्कफ़्लो में बदलें: python सीखें → डेटा संभालें → बेसलाइन बनाएं → ट्रेन करें → टेस्ट करें → छोटा शिप करें। एक उत्तरदायी मालिक का नाम रखें, डेटा और डिपेंडेंसीज़ का दस्तावेज़ बनाएं, एक सरल बेसलाइन स्थापित करें, स्वीकृति और रोक मानदंड सेट करें, प्रतिनिधिक विफलताओं का परीक्षण करें, और दायरे का विस्तार करने से पहले मॉनिटरिंग, रोलबैक, और समीक्षा को परिभाषित करें। संस्करण और धारणाओं को रिकॉर्ड करें ताकि दूसरी टीम परिणाम को पुनः उत्पन्न कर सके और परिवर्तन समझ सके।
लॉन्च से पहले, उन लोगों के साथ एक दस्तावेज़ीकृत रेडीनेस रिव्यू चलाएँ जो सिस्टम बनाते, संचालित करते, सुरक्षित रखते और उससे प्रभावित होते हैं। सामान्य मामलों, सीमा शर्तों, डिपेंडेंसी विफलताओं, और दुरुपयोग का परीक्षण करें; साक्ष्य और अनसुलझे जोखिमों को सुरक्षित रखें। निर्धारित करें कि कौन रिलीज़ को मंजूरी दे सकता है, थ्रेशहोल्ड बदल सकता है, आउटपुट को ओवरराइड कर सकता है, या संचालन को रोक सकता है। वास्तविक‑दुनिया डेटा आने पर निर्णय को पुनः देखें, क्योंकि तकनीकी रूप से सफल पायलट व्यापक पैमाने पर विश्वसनीय प्रदर्शन की गारंटी नहीं देता।
- FOUNDATIONS: कोड, डेटा, गणित, Git, और टेस्ट।
- PROJECT: प्रश्न, बेसलाइन, मॉडल, और त्रुटियां।
- JUDGMENT: गोपनीयता, सुरक्षा, साक्ष्य, और सीमाएं।
अक्सर पूछे जाने वाले प्रश्न
क्या AI में काम करने के लिए मुझे कंप्यूटर साइंस की डिग्री चाहिए?
नहीं। भूमिकाओं में इंजीनियरिंग, रिसर्च, प्रोडक्ट, डिजाइन, ऑपरेशन्स, डेटा, मूल्यांकन, नीति, और डोमेन विशेषज्ञता शामिल हैं। प्रत्येक में कोडिंग की आवश्यकता की गहराई अलग होती है।
शुरुआती को कौन सी प्रोग्रामिंग भाषा सीखनी चाहिए?
Python एक व्यावहारिक प्रथम विकल्प है क्योंकि इसकी सिंटैक्स सहज है और इसका डेटा एवं ML इकोसिस्टम व्यापक है। मूल समस्या‑समाधान कौशल अन्य भाषाओं में भी लागू होते हैं।
मुख्य संदर्भ