
Fondamentaux de l’IA
Qu’est‑ce que Albumentations ? Augmentation d’images pour la vision par ordinateur

 Ajouter Unite.AI à vos sources préférées sur Google
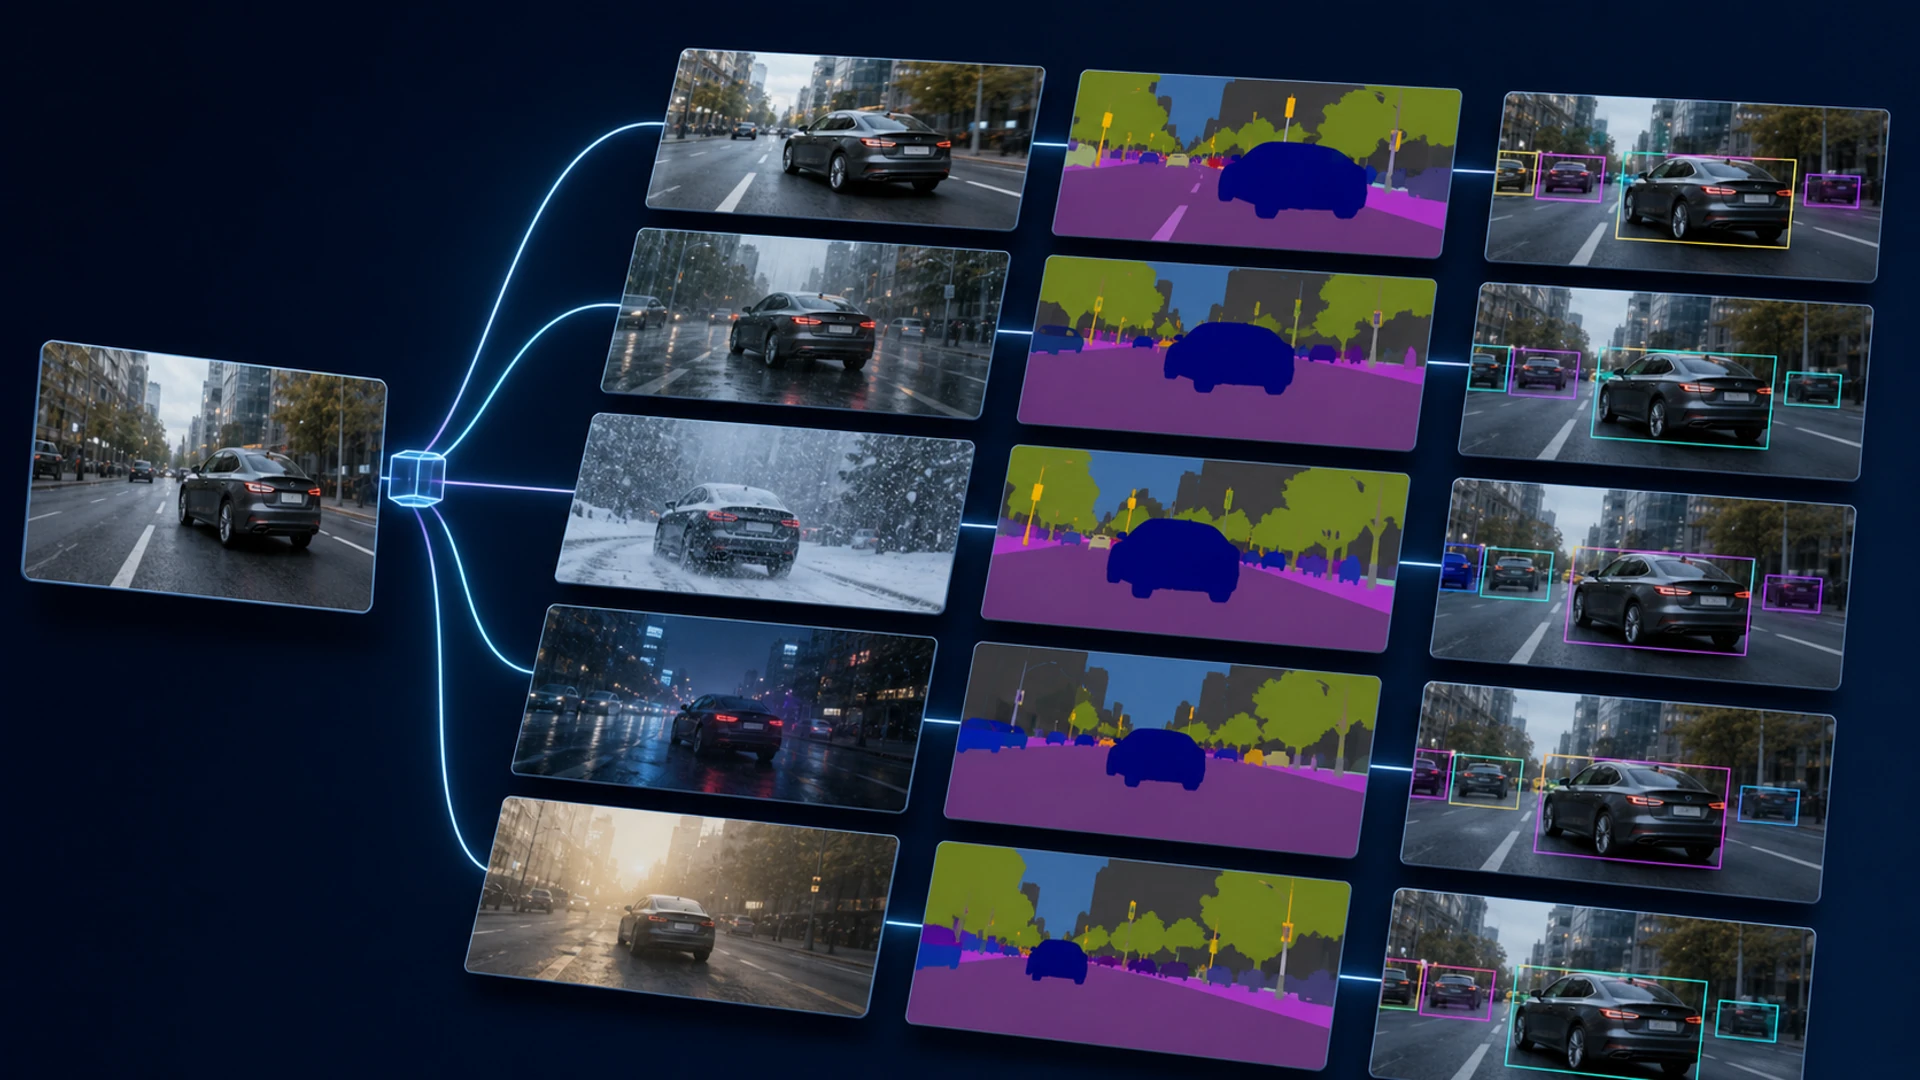
Albumentations est une bibliothèque Python open‑source d’augmentation d’images. Elle applique des transformations géométriques et photométriques aléatoires tout en maintenant les cibles associées — comme les masques de segmentation, les boîtes englobantes et les points clés — alignées avec l’image.
L’augmentation repose sur une hypothèse d’invariance: elle indique au modèle que les modifications sélectionnées ne doivent pas modifier l’étiquette de la tâche. Une bibliothèque rapide facilite les expériences, mais seul le savoir‑faire du domaine et la validation peuvent déterminer si une transformation est légitime.
Points clés
- Composer des transformations probabilistes en un pipeline d’entraînement reproductible.
- Transformer les images et les cibles spatiales conjointement ; valider explicitement les conventions des boîtes et des points clés.
- Appliquer une augmentation aléatoire aux données d’entraînement, pas à la distribution de validation ou de test non modifiée.
- Mesurer les effets par classe et par sous‑groupe, car une augmentation plus forte peut aider un cas et en nuire à un autre.
Fonctionnement d’un pipeline Albumentations
Un pipeline reçoit une image et des cibles nommées, échantillonne les transformations selon leurs probabilités et renvoie un dictionnaire des sorties mises à jour. Les transformations géométriques peuvent recadrer, pivoter, retourner ou déformer ; les transformations photométriques peuvent modifier la couleur, le contraste, le flou ou le bruit.
La bibliothèque s’intègre aux piles d’entraînement tout en restant centrée sur l’augmentation. Pour la vision par ordinateur, cette séparation permet d’évaluer les politiques de données indépendamment du cadre du modèle.
Conserver la cohérence géométrique des étiquettes
Un recadrage qui modifie une image doit également recadrer son masque et mettre à jour ou supprimer les boîtes et points clés affectés. Configurez le format des coordonnées, les champs d’étiquettes, la visibilité minimale, le découpage et les règles de filtrage, puis visualisez les lots avant l’entraînement.
L’interpolation diffère selon la cible: une image peut utiliser l’interpolation bilinéaire, tandis qu’un masque de classe nécessite généralement une interpolation au plus proche voisin afin d’éviter d’inventer des valeurs de catégorie. Une mauvaise gestion des cibles peut corrompre silencieusement le jeu de données.
Choisir des transformations issues du contexte de déploiement
Un retournement horizontal peut être valable pour des photos de faune mais inapproprié pour du texte, des panneaux de signalisation, la latéralité médicale ou du matériel asymétrique. Les changements de couleur peuvent améliorer la robustesse à l’éclairage, mais supprimer une caractéristique diagnostique lorsque la couleur porte une signification.
Commencez par une variation de nuisance plausible, ajoutez une famille à la fois et inspectez les exemples difficiles. Reliez les choix à des hypothèses de sur‑apprentissage plutôt que de supposer que davantage de variété synthétique est toujours bénéfique.
Reproductibilité et évaluation
Enregistrez la version de la bibliothèque, la configuration du pipeline, les probabilités, la stratégie de graine aléatoire, l’ordre de prétraitement et la normalisation. L’aléatoire doit varier les échantillons d’entraînement tout en maintenant la reproductibilité des expériences au niveau de chaque exécution.
Conservez les images de validation et de test représentatives et non augmentées, sauf pour le prétraitement déterministe. Comparez la précision, la calibration, les erreurs par classe et la robustesse. Les matrices de confusion peuvent révéler quand une augmentation déplace l’erreur plutôt que de la réduire.
Composition, probabilités et cibles
Compose applique une séquence de transformations, chacune avec une probabilité. Les constructions OneOf ou SomeOf échantillonnent parmi des alternatives, et les probabilités imbriquées déterminent la distribution réelle. La politique d’augmentation effective est donc un programme stochastique ; enregistrez‑la et examinez les fréquences échantillonnées plutôt que de lire chaque probabilité isolément.
Des cibles supplémentaires permettent à plusieurs images ou masques de partager la même géométrie, ce qui est utile pour les paires stéréo, les images avant‑après ou les annotations multiples. La prise en charge des boîtes englobantes nécessite un format déclaré tel que Pascal VOC, COCO, YOLO ou les coordonnées Albumentations. Les formats de points clés peuvent inclure l’angle ou l’échelle, et les transformations doivent en préserver la sémantique.
Les recadrages peuvent supprimer toutes les cibles. Décidez s’il faut rééchantillonner, conserver un exemple de fond ou le filtrer, car chaque choix modifie la distribution des classes. Les pipelines de détection et de segmentation doivent consigner les boîtes rejetées, les fractions visibles et les échantillons vides afin de révéler les dommages d’étiquettes silencieux.
Conception de politiques selon la tâche
La classification tolère souvent les recadrages, les changements de couleur, le flou et l’occlusion tant que la classe reste visible. La détection nécessite que les objets et les boîtes soient transformés conjointement. La segmentation requiert une géométrie de masque exacte. L’estimation de pose doit préserver les points clés et peut nécessiter un échange d’étiquettes gauche‑droite après un retournement.
L’imagerie médicale peut interdire les retournements, les changements de couleur agressifs ou l’interpolation qui modifie l’intensité quantitative. La télédétection doit prendre en compte l’orientation, la saison, les bandes du capteur et l’échelle géospatiale. L’analyse de documents doit préserver la lisibilité et la mise en page. Le domaine définit l’invariance ; la bibliothèque ne fait qu’exécuter celle‑ci.
Mélanger des méthodes telles que MixUp, CutMix, Mosaic ou le copier‑coller crée des étiquettes composites et peut se produire dans le chargeur de données ou le cadre plutôt que dans Albumentations. Leur interaction avec les transformations de base, la normalisation et le batch doit être testée. Des politiques fortes peuvent ralentir la convergence ou modifier la calibration même lorsque la précision finale s’améliore.
Performance, débogage et conception d’expériences
L’augmentation s’exécute sur le CPU sauf si un autre chemin est utilisé. Mesurez le débit du chargeur de données, le nombre de workers, le coût du décodage, les copies mémoire et le temps d’inactivité du GPU. Des transformations plus rapides ne sont utiles que si elles ne modifient pas la sémantique. Mettez en cache les étapes de décodage ou de prétraitement immuables lorsque le stockage et la reproductibilité le permettent.
Visualisez des grilles d’échantillons originaux et transformés avec chaque superposition de cible. Ajoutez des tests automatisés pour les allers‑retours de coordonnées, les valeurs de masque, la forme, le type de données et la relecture déterministe. Placez les graines au bon niveau ; une augmentation identique sur tous les workers peut réduire involontairement la diversité.
Effectuez des ablations par rapport à une référence fixe: aucune augmentation, des transformations de base plausibles, puis des politiques plus fortes. Répétez les graines et rapportez la variance. Évaluez les données propres, les corruptions pertinentes et les sous‑groupes séparément. Conservez une politique uniquement lorsque son bénéfice survit aux tests hors‑échantillon et que les images transformées restent crédibles pour les experts du domaine.
Concevoir et valider un pipeline Albumentations
Commencez par les variations attendues après le déploiement: angle de la caméra, recadrage, mise à l’échelle, illumination, compression, flou, conditions météorologiques, occlusion et bruit du capteur. Choisissez des transformations qui préservent l’étiquette et correspondent à ces mécanismes. Un retournement horizontal peut être valable pour les animaux mais invalide pour le texte, l’orientation du trafic ou l’anatomie asymétrique. Des changements de couleur forts peuvent détruire les informations diagnostiquement pertinentes même si l’image paraît encore plausible.
Albumentations compose les transformations et applique les changements spatiaux de façon cohérente aux images, masques, boîtes englobantes et points clés lorsqu’il est correctement configuré. Déclarez explicitement les formats de coordonnées, la visibilité minimale, l’interpolation et la gestion des masques. Visualisez des centaines d’échantillons augmentés avec les annotations superposées, testez les cas vides et limites, et enregistrez les paramètres aléatoires pour le débogage. Divisez les données par sujet ou scène avant l’augmentation afin que les images liées ne se propagent pas entre l’entraînement et le test.
Comparez aucune augmentation, une augmentation simple et la politique proposée sur un jeu de test non modifié et des jeux de stress réalistes. Suivez la précision spécifique à chaque classe, la localisation, la calibration et les exemples d’échec, pas seulement la perte d’entraînement. Une augmentation excessive peut sous‑adapter la distribution réelle, tandis qu’une augmentation faible peut encourager l’apprentissage de raccourcis. Versionnez le pipeline avec le modèle, semez les exécutions d’évaluation et évitez d’appliquer des transformations d’entraînement aléatoires pendant la validation ou l’inférence, sauf si l’augmentation en temps de test est délibérément évaluée.
Pour la détection et la segmentation, vérifiez le découpage des coordonnées, la surface minimale des boîtes, la visibilité des points clés et l’interpolation utilisée pour les masques catégoriels. L’interpolation au plus proche voisin est généralement requise pour les identifiants de classe, alors que l’interpolation bilinéaire peut créer des étiquettes invalides. Profiliez également le chargeur de données: des transformations agressives peuvent faire de l’augmentation CPU le goulot d’étranglement de l’entraînement. Mettez en cache uniquement les transformations qui sont déterministes et qui préservent la randomisation prévue à travers les époques et les workers.
Liste de contrôle pratique de mise en œuvre
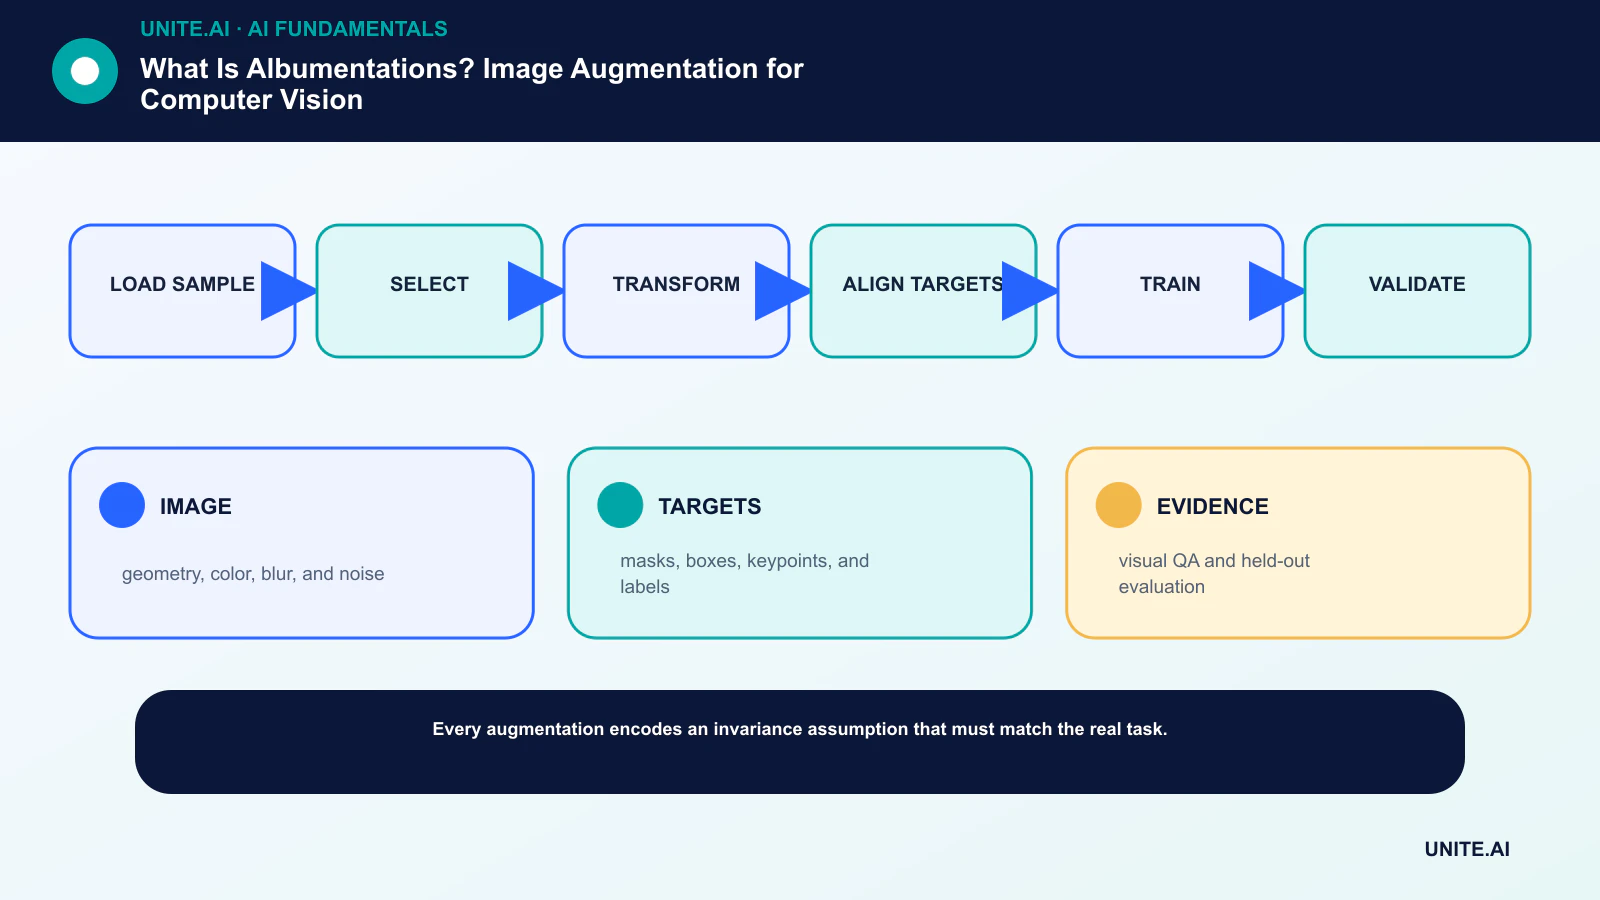
Transformez le concept en un flux de travail délimité et testable: charger un échantillon → sélectionner → transformer → aligner les cibles → entraîner → valider. Désignez un responsable, documentez les données et les dépendances, établissez une référence simple, définissez les critères d’acceptation et d’arrêt, testez les échecs représentatifs, et définissez la surveillance, le retour en arrière et la révision avant d’élargir le périmètre. Enregistrez les versions et les hypothèses afin qu’une autre équipe puisse reproduire le résultat et comprendre les changements.
Avant le lancement, effectuez une revue de préparation documentée avec les personnes qui construisent, exploitent, sécurisent et sont affectées par le système. Testez les cas normaux, les conditions limites, les défaillances de dépendances et les usages abusifs ; conservez les preuves et les risques non résolus. Définissez qui peut approuver la version, modifier un seuil, outrepasser une sortie ou arrêter l’opération. Reconsidérez la décision une fois les données du monde réel disponibles, car un pilote techniquement réussi ne garantit pas une performance fiable à plus grande échelle.
- IMAGE: géométrie, couleur, flou et bruit.
- TARGETS: masques, boîtes, points clés et étiquettes.
- EVIDENCE: QA visuelle et évaluation hors‑échantillon.
Questions fréquemment posées
L’augmentation d’image crée‑t‑elle de nouvelles vérités terrain ?
Non. Elle crée des exemples d’entraînement transformés sous l’hypothèse que les étiquettes restent valides. Une transformation irréaliste ou mal étiquetée introduit du bruit.
Les images de validation doivent‑elles être augmentées ?
Utilisez un redimensionnement et une normalisation déterministes requis par le modèle, mais conservez la distribution d’évaluation fixe. L’augmentation en temps d’inférence est une méthode distincte et doit être signalée explicitement.
Références principales












