
Fondamentaux de l’IA
Qu’est‑ce que le surapprentissage ?

 Ajouter Unite.AI à vos sources préférées sur Google
Le surapprentissage se produit lorsqu’un modèle capture des motifs ou du bruit qui fonctionnent exceptionnellement bien sur ses données d’entraînement mais qui ne généralisent pas aux nouveaux exemples. Un modèle surappris peut afficher une très faible erreur d’entraînement alors que la performance en validation ou en conditions réelles est nettement pire.
Le problème opposé est le sous‑apprentissage: le modèle ou le processus d’entraînement ne parvient pas à capter suffisamment le signal même sur le jeu d’entraînement. Une modélisation de qualité équilibre l’ajustement et la généralisation au lieu de viser une performance d’entraînement parfaite.
Points clés
- La performance d’entraînement seule ne permet pas de diagnostiquer la généralisation.
- L’arrêt précoce doit s’appuyer sur le comportement en validation, jamais sur des décisions répétées sur le jeu de test final.
- Plus de données peuvent aider, mais davantage de caractéristiques ou de capacité peuvent également aggraver le surapprentissage.
- La régularisation, l’augmentation, la validation croisée, la prévention des fuites et une évaluation appropriée traitent des causes différentes.
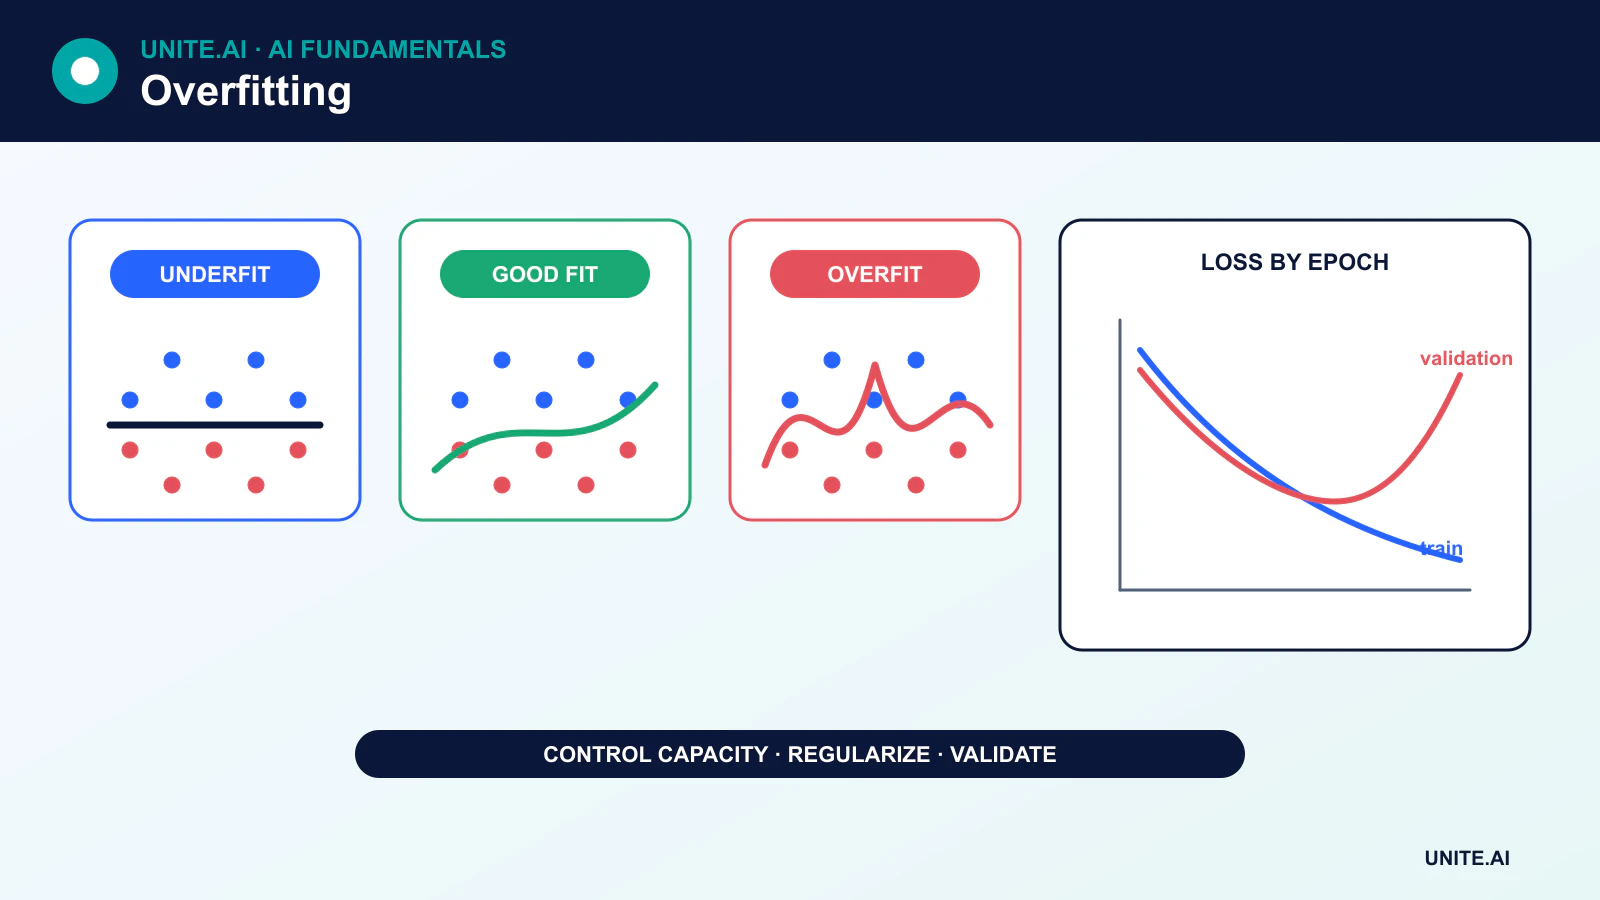
Ajustement, sous‑apprentissage et surapprentissage
Un modèle sous‑apprend lorsque ses hypothèses sont trop restrictives, que ses caractéristiques omettent des signaux importants, que l’optimisation est insuffisante ou que l’entraînement est trop court. Ajouter des caractéristiques pertinentes ou de la capacité peut aider, mais ajouter simplement des caractéristiques arbitraires peut augmenter le bruit et le surapprentissage.
Un modèle surapprend lorsque sa capacité effective est trop élevée par rapport à l’information contenue dans les données d’entraînement. Parmi les exemples, on trouve un arbre de décision profond qui crée de petites feuilles, un polynôme qui suit des fluctuations aléatoires, ou un réseau de neurones qui mémorise les exemples.
Le rôle des données d’entraînement, de validation et de test
- Données d’entraînement ajustent les paramètres du modèle.
- Données de validation sélectionnent l’architecture, les hyperparamètres, les seuils et le moment d’arrêt.
- Données de test fournissent une estimation finale après que ces choix soient finalisés.
Si le jeu de test guide de façon répétée les décisions, il devient partie intégrante du processus de développement et ne fournit plus d’estimation finale impartiale. La validation croisée peut permettre une utilisation plus efficace des données limitées, mais tout pré‑traitement et toute sélection de caractéristiques doivent être effectués à l’intérieur de chaque pli d’entraînement.
Arrêt précoce
Lors de l’entraînement, la perte d’entraînement continue généralement de diminuer. La perte de validation peut d’abord baisser puis augmenter lorsque le modèle se spécialise sur le bruit d’entraînement. L’arrêt précoce conserve le point de contrôle avec le meilleur objectif de validation ou s’arrête après qu’une période de patience définie se soit écoulée sans amélioration de la validation.
Le point de contrôle correct n’est pas celui avec la perte d’entraînement la plus basse. Un jeu de test final distinct est évalué après l’arrêt précoce et la fin des décisions de réglage.
Méthodes de régularisation
Pénalités de poids
La régularisation L2 ou la décroissance de poids décourage les valeurs de paramètres élevées. La régularisation L1 peut favoriser des coefficients parcimonieux. Leurs effets dépendent du modèle et de l’optimiseur ; AdamW, par exemple, découple la décroissance de poids de la mise à jour adaptative.
Dropout et régularisation stochastique
Le dropout masque aléatoirement les activations pendant l’entraînement. D’autres méthodes suppriment des chemins, perturbent les caractéristiques ou lissent les étiquettes. Ces techniques modifient l’objectif d’entraînement et doivent être désactivées ou gérées correctement lors de l’inférence.
Augmentation de données
L’augmentation crée des variations réalistes — comme des recadrages, rotations, bruit ou paraphrases — qui doivent préserver la cible. Des transformations invalides peuvent modifier l’étiquette et nuire au modèle. Pour la vision, des outils tels que Albumentations aident à mettre en place des pipelines contrôlés.
Contrôle de capacité
Des arbres plus peu profonds, moins de paramètres, la sélection de caractéristiques, l’élagage et des classes d’hypothèses plus simples peuvent réduire la variance. L’élagage d’arbre est guidé par des critères, et non par la suppression aléatoire de détails appris.
Les fuites de données peuvent donner l’impression d’une performance exceptionnelle
Une fuite se produit lorsqu’une information indisponible au moment de la prédiction pénètre l’entraînement ou l’évaluation. Parmi les exemples courants, on trouve le réglage de la normalisation sur l’ensemble complet de données, la répartition d’enregistrements répétés entre les plis, l’utilisation de données futures pour prédire le passé, ou l’inclusion d’une caractéristique dérivée de la cible.
La fuite n’est pas un simple surapprentissage, mais elle crée le même écart trompeur entre les résultats hors ligne et le déploiement. La stratégie de division doit respecter le temps, l’identité, le lieu et les processus de génération des données.
Le décalage de distribution est un problème distinct
Un modèle peut se généraliser à sa distribution de test et échouer néanmoins lorsque les données de production changent. De nouveaux appareils, politiques, populations, saisons ou comportements adverses peuvent modifier la relation entrée‑cible. La surveillance et la réévaluation périodique sont nécessaires même si le modèle d’origine n’était pas surappris.
Diagnostiquer le surapprentissage
Utilisez les courbes d’apprentissage, la variance de la validation croisée, les métriques de sous‑groupes, la calibration et l’inspection des erreurs. Si les performances d’entraînement et de validation sont toutes deux faibles, concentrez‑vous sur le sous‑apprentissage, les caractéristiques, les étiquettes ou l’optimisation. Si l’entraînement est solide mais la validation faible, examinez la capacité, les fuites, la régularisation et la représentativité avant de simplement collecter davantage de données.
Pourquoi le surapprentissage se produit et comment le détecter
Le surapprentissage se produit lorsqu’un modèle apprend des motifs qui réduisent l’erreur d’entraînement mais ne se généralisent pas à la population cible. Les causes comprennent une capacité excessive par rapport aux données effectives, du bruit d’étiquettes, des entités répétées, une sélection de caractéristiques flexible, des fuites et un réglage sur le même jeu de validation. Un écart grandissant entre les performances d’entraînement et de validation constitue une preuve courante, mais un petit écart n’exclut pas le surapprentissage si les deux ensembles partagent une contamination ou diffèrent du déploiement. Les courbes d’apprentissage selon le volume de données et la capacité aident à distinguer variance et biais.
La fuite est particulièrement trompeuse: des informations futures, des doublons, un chevauchement de sujets, un pré‑traitement ajusté sur l’ensemble des données ou des étiquettes encodées dans les métadonnées peuvent produire d’excellents scores hors‑échantillon. Divisez selon l’unité qui sera nouvelle lors du déploiement — patient, client, machine, localisation ou temps — avant d’ajuster les transformations ou augmentations. Conservez un jeu de test final scellé pendant le choix des caractéristiques, de l’architecture et des seuils. Si les équipes inspectent de façon répétée les résultats du test, le jeu de test devient un autre jeu de validation et doit être remplacé ou corrigé formellement.
Régularisation, sélection de modèle et dérive en production
Réduisez le surapprentissage avec des données plus représentatives, une capacité moindre, la décroissance de poids, le dropout, l’arrêt précoce, l’augmentation, l’ensemblage ou des contraintes reflétant la structure du domaine. Chaque méthode comporte des compromis: l’augmentation peut déformer les étiquettes, le dropout modifie l’optimisation, et les ensembles augmentent le coût de mise en service. La validation croisée estime la variabilité de la sélection, mais les plis groupés ou temporellement conscients doivent préserver la frontière de déploiement. Comparez avec un modèle simple et rapportez l’incertitude à travers les plis ou les graines plutôt que de choisir la meilleure exécution.
La production peut révéler une forme différente d’échec de généralisation lorsque les entrées, les utilisateurs, les incitations ou les mesures changent. Surveillez les distributions des caractéristiques et des prédictions, la calibration, les résultats des sous‑groupes et la vérité terrain différée. Ne réentraînez pas automatiquement sur des retours non examinés ; les décisions du modèle peuvent façonner les étiquettes qu’il voit plus tard. Diagnostiquez si l’échec provient d’une dérive, de pipelines de données, de changements de politique ou d’une cible invalide. Le surapprentissage est maîtrisé par la conception expérimentale et la discipline du cycle de vie, pas par un seul paramètre de régularisation.
Exemple pratique : éliminer les fuites dans un modèle de fraude
Un classificateur de fraude initial obtient des scores extrêmement élevés parce que des événements de carte et de commerçant répétés apparaissent dans des lignes d’entraînement et de test aléatoires, et que des informations de rétrofacturation enregistrées plusieurs semaines plus tard sont incluses comme caractéristique. L’équipe reconstruit le moment de disponibilité de chaque caractéristique, supprime les champs post‑décision, regroupe par compte et utilise une division temporelle progressive. La performance chute brutalement mais estime désormais la décision réelle. Une base de règles simples et les courbes d’apprentissage guident la complexité requise du modèle.
La régularisation et l’arrêt précoce sont réglés uniquement à l’intérieur des plis historiques. L’évaluation finale rapporte la précision à la capacité de revue, le rappel, la calibration et le coût par type de fraude et segment de client. En production, les étiquettes confirmées arrivent tard et sont biaisées par les transactions examinées, ainsi la surveillance sépare la dérive du score des estimations de résultats. Le réentraînement utilise des cas adjudiqués et une relecture selon la politique actuelle. Le projet privilégie un score honnête plus bas à un score élevé mais fuité qui ne peut survivre au déploiement.
Preuves de mise en œuvre et préparation opérationnelle
Une décision de production nécessite plus qu’une démonstration réussie. Définissez les utilisateurs visés, l’environnement d’exploitation, les entrées, les sorties, les dépendances, le responsable et les conséquences de chaque défaillance importante. Établissez une base reproductible et un jeu d’évaluation versionné avant le réglage. Testez les cas ordinaires, les conditions limites, les entrées malformées ou manquantes, le décalage de distribution, les pannes de dépendances, les usages abusifs, ainsi que les groupes ou environnements les plus susceptibles d’être sous‑servis. Mesurez la qualité de la tâche conjointement avec la calibration ou l’incertitude, la latence, le débit, le coût des ressources, l’accessibilité, la confidentialité et la sécurité. Enregistrez chaque transformation et seuil afin qu’un évaluateur indépendant puisse reproduire le résultat et distinguer la preuve d’un prototype attrayant.
Avant le lancement, attribuez l’autorité pour la publication, les exceptions, les changements, le retour en arrière et la mise hors service. Utilisez un déploiement progressif, conservez un repli sûr et vérifiez la surveillance avec des pannes injectées délibérément. La télémétrie opérationnelle doit révéler la qualité des entrées, le comportement des sorties, la version du modèle ou de la règle, l’état des dépendances, les interventions humaines et les résultats confirmés sans collecter de données sensibles inutiles. Définissez les seuils d’alerte et un responsable de réponse, puis examinez les preuves du monde réel après le déploiement plutôt que de supposer que la performance hors ligne persistera. Réévaluez chaque fois que les sources de données, les utilisateurs, les modèles, les fournisseurs, les politiques, le matériel ou les objectifs changent. Un système maintenu nécessite également des procédures documentées de récupération, d’apprentissage des incidents, de suppression et de conservation, ainsi qu’un point clair où il doit être désactivé ou remplacé.
Foire aux questions
Un modèle simple peut‑il surapprendre ?
Oui. Une sélection répétée de caractéristiques, un réglage de seuils ou une évaluation sur le même jeu de validation peuvent surapprendre le processus de développement même lorsque le modèle final est simple.
Plus de données d’entraînement résout‑il toujours le surapprentissage ?
Non. Des données plus représentatives et correctement étiquetées peuvent aider, mais des données dupliquées, biaisées, fuyantes ou hors‑domaine peuvent ne pas le faire. L’objectif d’apprentissage et la conception de l’évaluation restent importants.
Références principales












