
Fondamentaux de l’IA
Qu’est‑ce que la vision par ordinateur ?

 Ajouter Unite.AI à vos sources préférées sur Google
Computer vision est le domaine qui consiste à créer des systèmes extrayant des informations utiles à partir d’images et de vidéos. Un modèle de vision peut classer une image entière, localiser des objets, étiqueter chaque pixel, lire du texte, estimer la pose, suivre le mouvement, ou associer le contenu visuel au langage.
Les systèmes de vision modernes ne se contentent pas de reproduire le processus précoce de détection des contours de la perception humaine. Ils apprennent des représentations spécifiques à la tâche à partir de données, souvent en utilisant des réseaux de neurones convolutifs, des vision transformers ou des modèles de fondation multimodaux.
Points clés
- La classification, la détection, la segmentation, la reconnaissance optique de caractères (OCR), le suivi et la génération sont des tâches de vision distinctes.
- Les CNN intègrent la localité et le partage de poids ; les vision transformers utilisent l’attention sur les patches d’image.
- Les étiquettes peuvent provenir d’humains, de supervision faible, de données synthétiques ou d’objectifs auto‑supervisés.
- La seule précision est insuffisante : la robustesse, la latence, la confidentialité, les biais et les coûts des défaillances sont importants.
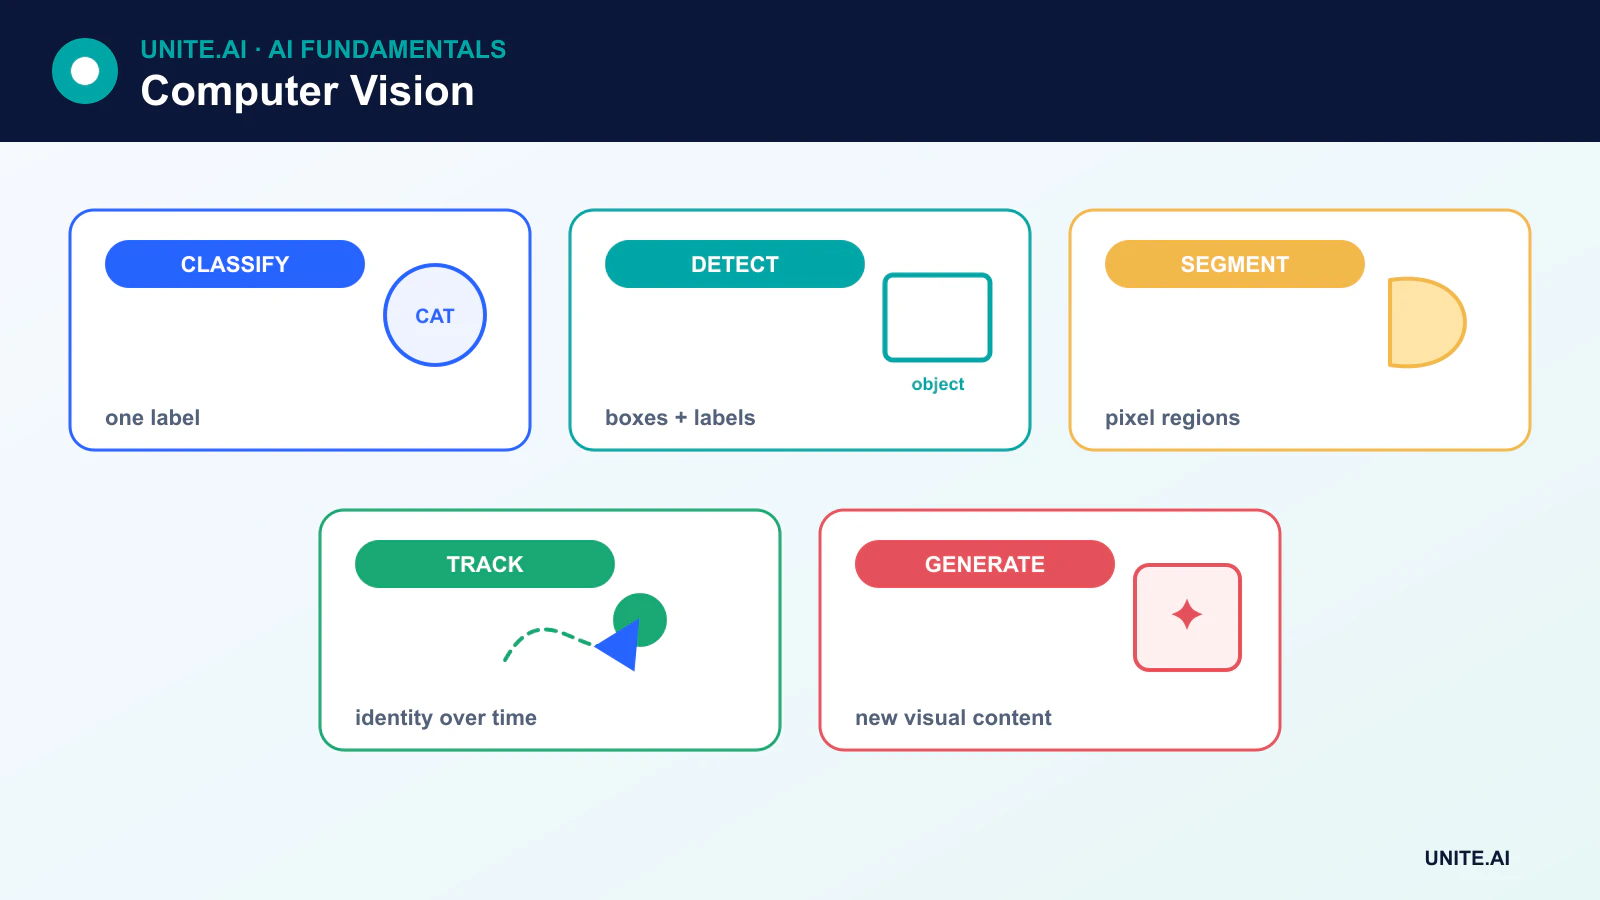
Les principales tâches de vision par ordinateur
- Classification d’image attribue une ou plusieurs étiquettes à une image. Voir comment fonctionne la classification d’image.
- Détection d’objets prédit les catégories et les boîtes englobantes pour plusieurs objets.
- Segmentation sémantique attribue à chaque pixel une classe, tandis que la segmentation d’instance sépare les objets individuels.
- Reconnaissance optique de caractères (OCR) détecte et transcrit le texte.
- Estimation de pose prédit les points clés du corps ou de l’objet.
- Suivi associe les détections à travers les images vidéo.
- Génération et édition d’images produisent ou transforment du contenu visuel, souvent en utilisant des modèles de diffusion.
Comment les images deviennent des entrées de modèle
Une image numérique est déjà des données numériques : un tenseur contenant les valeurs de pixels selon les dimensions spatiales et les canaux. Le pré‑traitement peut redimensionner, normaliser, recadrer ou augmenter l’image. La vidéo ajoute une dimension temporelle, tandis que l’imagerie médicale et scientifique peut ajouter la profondeur, la longueur d’onde ou d’autres modalités.
La vision par ordinateur classique utilisait des caractéristiques de bord, de coin et de texture conçues à la main. Les modèles profonds modernes apprennent généralement les caractéristiques conjointement avec la tâche, bien que les méthodes classiques restent utiles lorsque les données sont limitées, les règles bien comprises ou le calcul doit être minimal.
CNN et caractéristiques locales apprises
Un CNN applique des noyaux appris sur des voisinages locaux. Les premières couches peuvent répondre à des motifs locaux, tandis que les blocs ultérieurs les combinent en représentations pertinentes pour la tâche. Le pooling ou les opérations à pas (strided) réduisent la résolution spatiale, et les connexions résiduelles facilitent l’optimisation des réseaux profonds.
Un classificateur CNN moderne utilise souvent un pooling global plutôt qu’une grande pile de couches entièrement connectées. Les détecteurs et les réseaux de segmentation ajoutent des têtes spécialisées ou des chemins de décodage qui préservent l’information spatiale.
Vision transformers et modèles de base
Un vision transformer divise une image en patches, les intègre, et utilise l’attention pour modéliser leurs relations. Les transformers peuvent s’échelonner efficacement avec de grands ensembles de données et un pré‑entraînement, tandis que les CNN offrent souvent des hypothèses intégrées plus fortes et une meilleure efficacité à plus petite échelle.
Les modèles multimodaux alignent les images avec le texte afin que les utilisateurs puissent rechercher, légender, répondre à des questions ou guider la segmentation à l’aide du langage. Ces modèles élargissent les capacités mais héritent également des faiblesses des vastes données du Web, incluant les stéréotypes, le matériel protégé par le droit d’auteur et une couverture inégale des populations et des environnements.
Étiquettes, auto‑supervision et données synthétiques
Les boîtes englobantes, les masques, les points clés et les légendes peuvent être coûteux à créer. L’apprentissage auto‑supervisé dérive des objectifs à partir des images elles‑mêmes, tandis que la supervision faible utilise des étiquettes bruyantes ou indirectes. Les données synthétiques peuvent ajouter des scénarios rares, mais les écarts de simulation peuvent empêcher le transfert des performances synthétiques au monde réel.
La qualité de l’annotation doit être mesurée. Les étiquettes ambiguës, les limites incohérentes et les objets manquants imposent un plafond à la performance et peuvent masquer des défaillances de sous‑groupes.
Comment les systèmes de vision sont évalués
La classification utilise des métriques telles que la précision, le rappel, le F1 et la calibration. La détection utilise généralement l’intersection sur union et la moyenne de précision (mAP). La segmentation utilise l’intersection sur union ou des mesures de type Dice. Le suivi ajoute des métriques d’identité et de trajectoire.
La métrique doit correspondre au déploiement. Un modèle peut bien se classer sur un benchmark sélectionné et échouer néanmoins sous la pluie, en faible lumière, avec des angles de caméra inhabituels, de nouveaux appareils ou des populations inconnues. L’évaluation doit inclure le décalage de distribution, les conditions adverses et la latence opérationnelle.
Confidentialité, biais et déploiement
Les visages, plaques d’immatriculation, habitations, scanners médicaux et vidéos en milieu de travail peuvent révéler des informations sensibles. La collecte et la conservation doivent suivre une base légale et éthique définie, avec des contrôles d’accès et une minimisation des données. L’analyse faciale et l’identification biométrique méritent une attention particulière car les erreurs et la surveillance peuvent imposer des préjudices inégaux.
Le déploiement en périphérie (edge) peut réduire la latence et le transfert de données. L’Edge AI, la quantification, l’élagage et les accélérateurs spécialisés peuvent rendre les systèmes de vision pratiques sur les caméras, véhicules, robots et appareils mobiles, mais la compression doit être ré‑évaluée pour la précision et les biais.
Des pixels aux tâches visuelles
La vision par ordinateur transforme les images ou vidéos en sorties de tâche telles que la classification, la détection, la segmentation, le suivi, la pose, la profondeur, le flux optique ou la reconnaissance de texte. La définition de la tâche détermine l’annotation : une étiquette d’image ne peut pas entraîner une localisation précise, et une boîte englobante ne peut pas décrire complètement un masque de segmentation. La géométrie de la caméra, les objectifs, l’exposition, l’éclairage, le mouvement, la compression et le point de vue façonnent la distribution des données. Il faut définir l’environnement opérationnel et les conséquences des erreurs avant de choisir un modèle, car une collection d’images de référence peut ne pas représenter le capteur ou la scène déployés.
Un pipeline décode et oriente les médias, les redimensionne ou les découpe en tuiles, normalise les valeurs, applique des augmentations qui préservent les étiquettes, exécute un modèle et post‑traite les logits, boîtes, masques ou pistes. Les détecteurs d’objets utilisent des seuils de confiance et la suppression ; les suiveurs associent les détections dans le temps ; la segmentation peut nécessiter un nettoyage morphologique. Conservez les transformations de coordonnées afin que les sorties s’alignent avec l’image originale. Divisez les données par personne, caméra, lieu ou session de capture pour éviter que des images presque identiques apparaissent à la fois dans les ensembles d’entraînement et de test.
Évaluation, biais, confidentialité et opérations
Les métriques doivent correspondre à la tâche et à l’usage. La classification nécessite une précision et un rappel spécifiques à chaque classe ; la détection utilise l’intersection‑sur‑union et la précision moyenne à travers les seuils ; la segmentation utilise l’IoU ou le Dice ; le suivi ajoute les changements d’identité ; la latence et la durée des événements manqués sont importantes pour la vidéo. Rapporter les résultats selon l’éclairage, la distance, l’appareil, l’occlusion, le teint de peau, l’âge et d’autres conditions pertinentes. Examiner la calibration et les erreurs à forte confiance. Les données synthétiques ou augmentées peuvent combler les lacunes mais nécessitent une comparaison avec les données de déploiement réelles et ne doivent pas divulguer les scènes de test.
La vision peut collecter les spectateurs, les lieux, les données biométriques et les comportements sensibles. Minimisez la capture et la conservation, sécurisez les flux, limitez l’utilisation secondaire et fournissez un avis ou un consentement lorsque nécessaire. Testez les patchs adversaires, la relecture, l’occlusion, les pannes de caméra et le décalage de domaine. Surveillez la santé du capteur, les statistiques d’entrée, les taux de sortie et les résultats confirmés ; maintenez une révision humaine pour les décisions à fort impact. Le flou ou le recadrage peut réduire l’exposition mais peut aussi supprimer des preuves. Un score élevé en laboratoire ne justifie pas les affirmations d’identité, d’émotion ou d’intention au‑delà de la tâche validée.
Exemple pratique : détection de piétons à un croisement d’entrepôt
Des caméras surveillent un passage de véhicules restreint, et le modèle détecte les personnes sans les identifier. Les données couvrent le jour et la nuit, les conditions météorologiques, les vêtements, les occlusions, les utilisateurs de fauteuil roulant, les positions des caméras et les scènes vides, réparties par session d’enregistrement. Le détecteur est évalué selon le rappel d’événement, les fausses alarmes, la localisation, le temps d’avance de l’avertissement et la performance à distance. L’ingénierie de sécurité définit la latence maximale tolérée et les contrôles physiques indépendants.
L’alerte visuelle peut ralentir un véhicule, mais les arrêts d’urgence et les barrières ne dépendent pas du modèle appris. L’obstruction de la caméra, les images figées, la perte de réseau et le dépassement du temps du modèle entraînent des fautes explicites. La conservation des vidéos brutes est minimisée et les accès sont consignés. La surveillance suit la santé du capteur, les taux d’alerte, les incidents examinés et les quasi‑accidents selon les conditions. Tout déplacement de caméra ou modification de la disposition déclenche une re‑validation, car une similarité d’image apparente ne garantit pas la même géométrie ou le même risque.
Évidence de mise en œuvre et préparation opérationnelle
Une décision de production nécessite plus qu’une démonstration réussie. Définissez les utilisateurs prévus, l’environnement opérationnel, les entrées, les sorties, les dépendances, le propriétaire et les conséquences de chaque défaillance importante. Établissez une base de référence reproductible et un jeu d’évaluation versionné avant l’ajustement. Testez les cas ordinaires, les conditions limites, les entrées malformées ou manquantes, le décalage de distribution, les pannes de dépendances, les usages abusifs, ainsi que les groupes ou environnements les plus susceptibles d’être sous‑servis. Mesurez la qualité de la tâche conjointement à la calibration ou à l’incertitude, la latence, le débit, le coût des ressources, l’accessibilité, la confidentialité et la sécurité. Enregistrez chaque transformation et chaque seuil afin qu’un examinateur indépendant puisse reproduire le résultat et distinguer les preuves d’un prototype séduisant.
Avant le lancement, attribuez l’autorité pour la diffusion, les exceptions, les changements, les retours en arrière et la mise hors service. Utilisez un déploiement progressif, conservez une solution de secours sûre, et validez la surveillance avec des pannes intentionnellement injectées. La télémétrie opérationnelle doit révéler la qualité des entrées, le comportement des sorties, la version du modèle ou de la règle, la santé des dépendances, les interventions humaines et les résultats confirmés sans collecter de données sensibles inutiles. Définissez les seuils d’alerte et le responsable de la réponse, puis examinez les preuves du monde réel après le déploiement au lieu de supposer que la performance hors ligne persistera. Réévaluez chaque fois que les sources de données, les utilisateurs, les modèles, les fournisseurs, les politiques, le matériel ou les objectifs changent. Un système maintenu nécessite également une récupération documentée, l’apprentissage des incidents, des procédures de suppression et de conservation, ainsi qu’un point clair où il doit être désactivé ou remplacé.
Foire aux questions
La vision par ordinateur est‑elle identique à la reconnaissance d’image ?
Non. La reconnaissance d’image fait généralement référence à la classification ou à l’identification. La vision par ordinateur inclut également la localisation, la segmentation, la mesure, le suivi, la reconstruction, la génération et le raisonnement sur les informations visuelles.
Un système de vision voit‑il comme un être humain ?
Non. Un modèle traite des entrées numériques selon son architecture et son objectif d’entraînement. Il peut surpasser les humains sur un benchmark étroit tout en échouant face à de petites variations qu’une personne gère aisément.
Références principales












