
Fondamentaux de l’IA
Qu’est‑ce qu’une matrice de confusion ?

 Ajouter Unite.AI à vos sources préférées sur Google
Une matrice de confusion est un tableau qui compte la fréquence à laquelle les prédictions d’un classificateur concordent ou divergent avec les étiquettes connues. Elle révèle quelles classes sont confondues et fournit les effectifs utilisés pour calculer des métriques telles que la précision, le rappel, la spécificité et le F1. C’est l’un des outils de diagnostic essentiels pour les problèmes de classification en apprentissage supervisé.
La matrice elle‑-même n’est pas un score de performance unique. Elle constitue une vue structurée des résultats à un seuil de décision, un jeu de données et une définition de classe donnés.
Points clés
- Pour la classification binaire, les quatre issues sont vrai positif, faux positif, faux négatif et vrai négatif.
- Toujours étiqueter les axes : les bibliothèques et les publications ne placent pas toujours les classes réelles et prédites dans la même orientation.
- La précision (accuracy) peut masquer des erreurs graves lorsque les classes sont déséquilibrées.
- Modifier le seuil de classification modifie la matrice de confusion et le compromis entre précision et rappel.
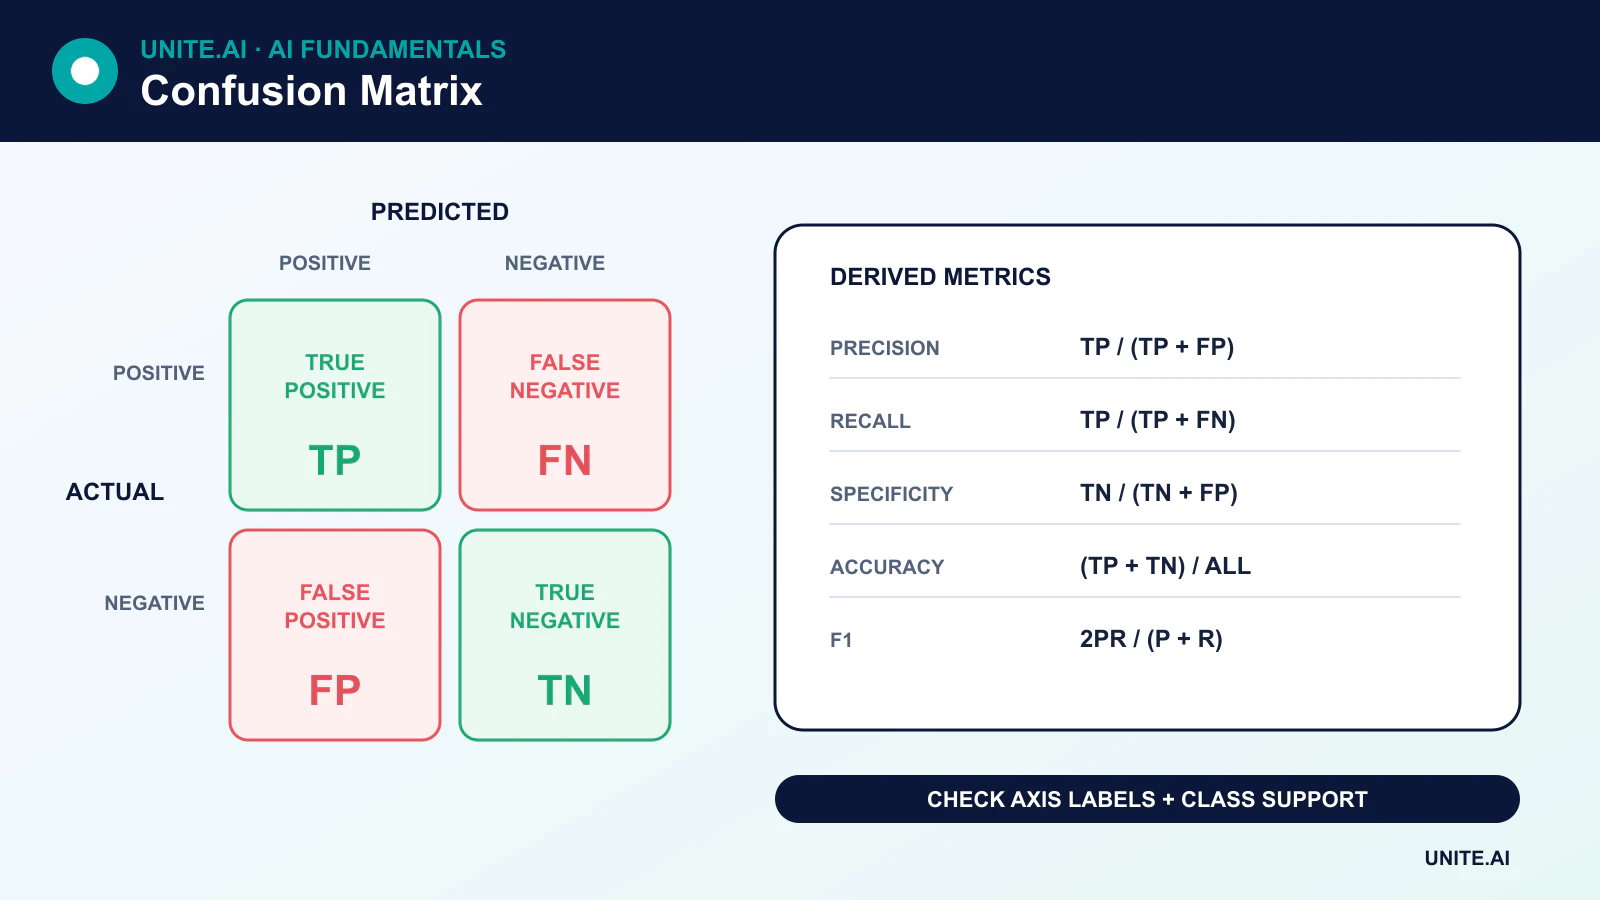
Les quatre issues de la classification binaire
- Vrai positif (VP) : l’exemple est positif et le modèle prédit positif.
- Faux positif (FP) : l’exemple est négatif mais le modèle prédit positif.
- Faux négatif (FN) : l’exemple est positif mais le modèle prédit négatif.
- Vrai négatif (VN) : l’exemple est négatif et le modèle prédit négatif.
Dans la convention de scikit‑learn, les lignes représentent les classes réelles et les colonnes les classes prédites. D’autres visualisations peuvent transposer cet agencement, de sorte que les étiquettes — et non la position des coins — doivent guider l’interprétation.
Métriques dérivées d’une matrice de confusion
Précision
Precision = TP / (TP + FP)
La précision répond : parmi les exemples préditement positifs, quelle proportion était réellement positive ?
Rappel ou sensibilité
Recall = TP / (TP + FN)
Le rappel répond : parmi tous les exemples réellement positifs, quelle proportion le modèle a‑t‑il identifiée ? En classification binaire, le rappel de la classe positive est également appelé sensibilité ou taux de vrais positifs.
Spécificité
Specificity = TN / (TN + FP)
La spécificité est le rappel pour la classe négative : parmi les négatifs réels, quelle proportion le modèle a‑t‑il correctement rejetée ?
Exactitude
Accuracy = (TP + TN) / (TP + TN + FP + FN)
L’exactitude est utile lorsque les classes et les coûts d’erreur sont raisonnablement équilibrés. Elle peut être trompeuse lorsqu’une classe domine.
Score F1
F1 = 2 × (Precision × Recall) / (Precision + Recall)
Le score F1 résume la précision et le rappel à l’aide d’une moyenne harmonique. Il ignore les vrais négatifs, il n’est donc pas le résumé adéquat pour toutes les tâches.
Exemple illustratif
Supposons qu’un jeu de test contienne 1 000 transactions. Cinquante sont frauduleuses. Un modèle en détecte 40 mais signale 30 transactions légitimes :
- TP = 40
- FN = 10
- FP = 30
- TN = 920
Le modèle affiche une exactitude de 96 %, mais sa précision est d’environ 57 % et son rappel de 80 %. Cette haute exactitude est largement due au grand nombre de transactions légitimes. L’acceptabilité de ce modèle dépend du coût des fraudes manquées, de la capacité d’enquête et du degré de calibration de ses scores de risque.
Les seuils modifient la matrice
De nombreux classificateurs produisent un score plutôt qu’une réponse oui/non incontournable. Abaisser le seuil positif augmente généralement le rappel et les faux positifs ; l’élever augmente généralement la précision ou la spécificité tout en manquant davantage de positifs. Le seuil doit être choisi à l’aide de données de validation et de coûts d’erreur réels, et non fixé automatiquement à 0,5.
Les courbes précision‑rappel et ROC résument la performance selon les seuils. Les courbes précision‑rappel sont souvent plus informatives lorsque la classe positive est rare.
Matrice de confusion multiclasse
Pour K classes, la matrice est K × K. Les prédictions correctes se situent sur la diagonale ; les cellules hors diagonale indiquent quelles paires de classes sont confondues. Les métriques par classe peuvent être moyennées de différentes manières :
- Moyenne macro : attribue un poids égal à chaque classe.
- Moyenne pondérée : pondère chaque classe en fonction de son nombre d’exemples.
- Moyenne micro : agrège les effectifs avant de calculer la métrique.
Ne rapporter qu’une seule moyenne peut masquer une mauvaise performance sur les petites classes. Incluez les effectifs et les résultats par classe lorsque les différences sont importantes.
Erreurs courantes
- Lire une matrice transposée sans vérifier les étiquettes des axes.
- Calculer les métriques à partir des données d’entraînement au lieu d’un ensemble de validation approprié.
- Ignorer la prévalence des classes, la stratégie d’échantillonnage ou les entités dupliquées entre les découpes.
- Comparer des matrices générées à différents seuils sans indiquer le changement.
- Considérer tous les faux positifs et faux négatifs comme ayant le même coût.
Une matrice de confusion est donc un outil de diagnostic, pas une évaluation complète. La calibration, l’analyse de sous‑groupes, la robustesse et les conséquences en aval font également partie d’une revue de classification.
Lire chaque cellule et en extraire des métriques utiles
Pour la classification binaire, la matrice de confusion compte les vrais positifs, faux positifs, faux négatifs et vrais négatifs pour une classe positive et un seuil choisis. L’exactitude divise les prédictions correctes par le nombre total de cas ; la précision interroge la fraction des positifs prédits qui étaient corrects ; le rappel interroge la fraction des positifs réels qui ont été trouvés ; la spécificité mesure les négatifs réels correctement rejetés. Le F1 est la moyenne harmonique de la précision et du rappel. Aucun n’est intrinsèquement le meilleur : le dépistage de fraude, le triage médical et le filtrage de spam attribuent des conséquences différentes aux mêmes cellules.
Pour les problèmes multiclasse, les lignes représentent généralement les classes réelles et les colonnes les classes prédites, bien que les conventions varient, il faut donc que les étiquettes soient explicites. Les comptages un‑vers‑tout produisent la précision et le rappel par classe. La moyenne macro pondère les classes de façon égale ; la moyenne micro agrège les décisions et favorise les classes fréquentes ; la moyenne pondérée suit le support de chaque classe. Les tâches multilibellisées autorisent plusieurs étiquettes par élément et nécessitent des définitions par étiquette ou par échantillon. Normaliser par ligne pour examiner les schémas de rappel ou par colonne pour examiner la composition des prédictions, tout en conservant les effectifs bruts afin que les groupes rares ne soient pas exagérés visuellement.
Seuils, incertitude et décisions opérationnelles
Une matrice de confusion résume les décisions binaires à un seuil donné. Utilisez les courbes précision‑rappel ou ROC pour comparer les seuils, puis choisissez un point de fonctionnement en fonction de la capacité, de la prévalence et du coût d’erreur. La calibration vérifie si les probabilités prédites correspondent à la fréquence observée et est distincte du classement. Lorsque la prévalence varie, la précision peut changer même si la sensibilité et la spécificité restent stables. Rapportez les intervalles de confiance ou la variation par bootstrap, et évitez de tirer des conclusions à partir de quelques erreurs dans un petit sous‑groupe.
Auditez les matrices selon le temps, le lieu, le dispositif, la langue et les groupes concernés afin d’identifier les erreurs concentrées. Comparez le modèle au processus décisionnel existant, y compris la révision humaine. Pour les cascades, consignez les erreurs à chaque étape : récupération, classification, application du seuil et action. Surveillez les étiquettes de résultats en temps réel avec leur délai et leur processus de correction. Un F1 apparemment amélioré peut néanmoins augmenter les faux négatifs nuisibles ou dépasser la capacité de révision. La matrice de confusion est un registre décisionnel ; reliez chaque cellule à la personne affectée par l’erreur et à la réponse qui s’ensuit.
Exemple illustratif : choisir un seuil de dépistage médical
Un modèle de dépistage en apprentissage automatique génère un score de risque pour une affection à faible prévalence. L’équipe crée des matrices de confusion selon différents seuils et rapporte la sensibilité, la spécificité, la précision, les faux renvois et les cas manqués avec des intervalles de confiance. Comme la valeur prédictive positive dépend de la prévalence, elle modélise la population cible plutôt que de citer la précision d’un seul jeu de données. Les résultats sont segmentés par dispositif, site, âge, sexe et d’autres groupes justifiés cliniquement.
Les cliniciens choisissent un point de fonctionnement qui maintient la sensibilité requise sans submerger les tests de confirmation. La matrice est convertie en effectifs attendus pour 10 000 personnes dépistées afin que les conséquences soient compréhensibles. Les scores hors des conditions validées ne produisent aucune conclusion automatisée. Le suivi compare les prédictions aux diagnostics confirmés avec retard, suit la capacité et la calibration, et déclenche une révision lorsque la prévalence ou l’acquisition change. La matrice de confusion reste liée au modèle exact, au seuil et à la population.
Preuves d’implémentation et préparation opérationnelle
Une décision de production nécessite plus qu’une démonstration réussie. Définissez les utilisateurs visés, l’environnement opérationnel, les entrées, les sorties, les dépendances, le propriétaire et les conséquences de chaque défaillance importante. Établissez une base de référence reproductible et un jeu d’évaluation versionné avant l’ajustement. Testez les cas ordinaires, les conditions limites, les entrées malformées ou manquantes, les changements de distribution, les pannes de dépendances, les usages abusifs, ainsi que les groupes ou environnements les plus susceptibles d’être sous‑servis. Mesurez la qualité de la tâche conjointement avec la calibration ou l’incertitude, la latence, le débit, le coût des ressources, l’accessibilité, la confidentialité et la sécurité. Enregistrez chaque transformation et chaque seuil afin qu’un évaluateur indépendant puisse reproduire le résultat et distinguer les preuves d’un prototype attrayant.
Avant le lancement, attribuez l’autorité pour la mise en production, les exceptions, les modifications, le retour en arrière et la mise hors service. Utilisez un déploiement progressif, conservez une solution de secours sûre et vérifiez la surveillance avec des pannes injectées délibérément. La télémétrie opérationnelle doit révéler la qualité des entrées, le comportement des sorties, la version du modèle ou de la règle, l’état des dépendances, les interventions humaines et les résultats confirmés sans collecter de données sensibles inutiles. Définissez les seuils d’alerte et un responsable de réponse, puis examinez les preuves du monde réel après le déploiement plutôt que de supposer que la performance hors ligne persistera. Réévaluez chaque fois que les sources de données, les utilisateurs, les modèles, les fournisseurs, les politiques, le matériel ou les objectifs changent. Un système maintenu nécessite également une récupération documentée, un apprentissage des incidents, des procédures de suppression et de conservation, ainsi qu’un point clair où il doit être désactivé ou remplacé.
Foire aux questions
Qu’est‑ce qu’une matrice de confusion normalisée ?
La normalisation divise les effectifs par le total de la classe réelle, le total de la classe prédite ou l’ensemble des observations. Elle facilite la comparaison des taux entre les classes, mais le rapport doit également conserver les effectifs bruts afin que les petits groupes ne soient pas confondus avec des groupes de même taille.
Une matrice de confusion peut‑elle évaluer la régression ?
Pas directement. Une matrice de confusion nécessite des classes discrètes. Regrouper un objectif continu en intervalles supprime de l’information ; la régression doit normalement s’appuyer sur une analyse des résidus et des métriques conçues pour des valeurs continues, telles que le MAE ou le RMSE.
Références principales












