Fondamentaux de l’IA
Comment fonctionne la classification d’images ?

 Ajouter Unite.AI à vos sources préférées sur Google
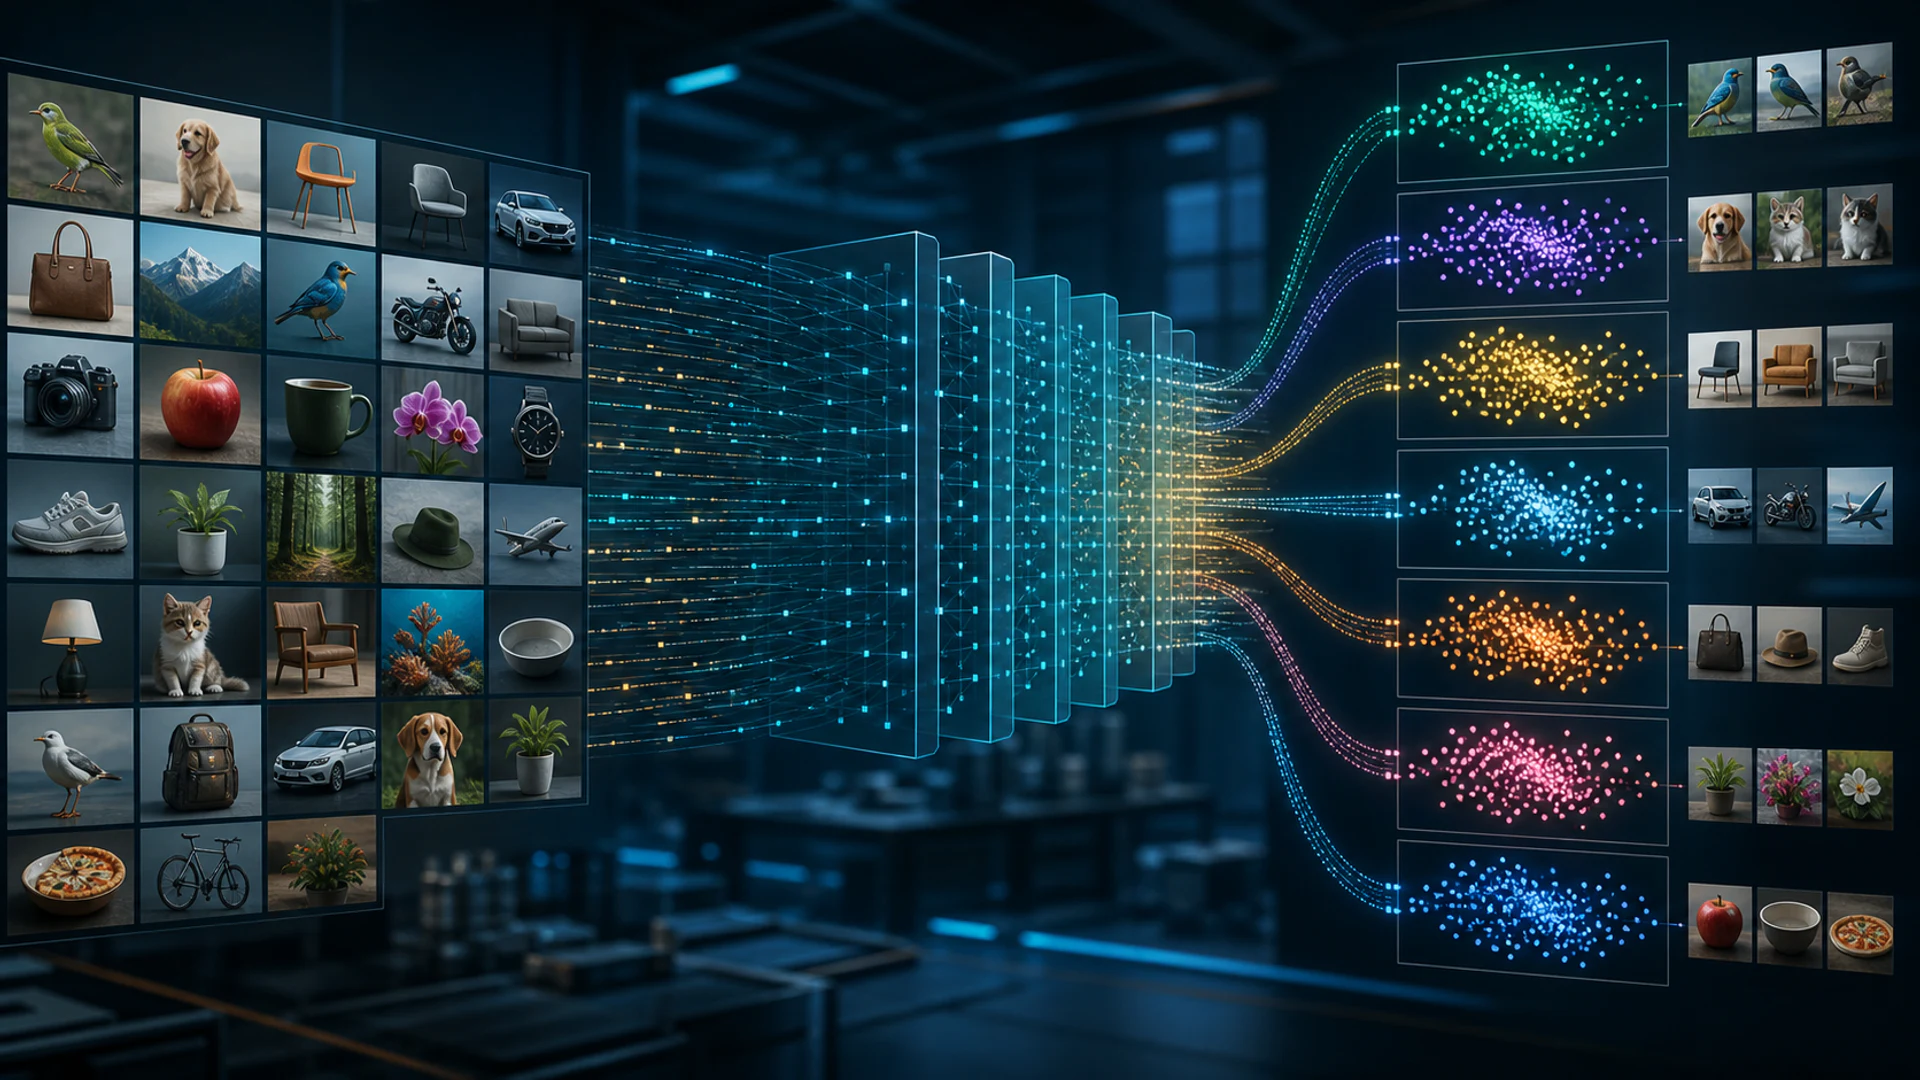
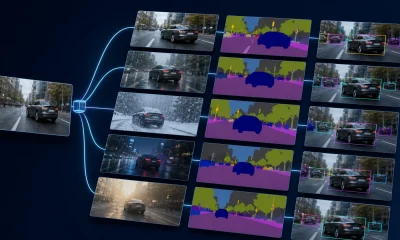
La classification d’images prédit une étiquette pour une image entière. Elle répond à des questions telles que « Quelle catégorie de produit est affichée ? » ou « Cette analyse contient-elle une cible recherchée ? ». Elle ne localise pas chaque objet ni ne délimite ses pixels.
Les systèmes modernes utilisent couramment des réseaux de neurones convolutionnels ou des vision transformers, souvent initialisés avec des poids pré‑entraînés. Des performances fiables dépendent encore des étiquettes, de l’échantillonnage, de l’augmentation, de la calibration et des tests dans des conditions de déploiement réelles.
Points clés
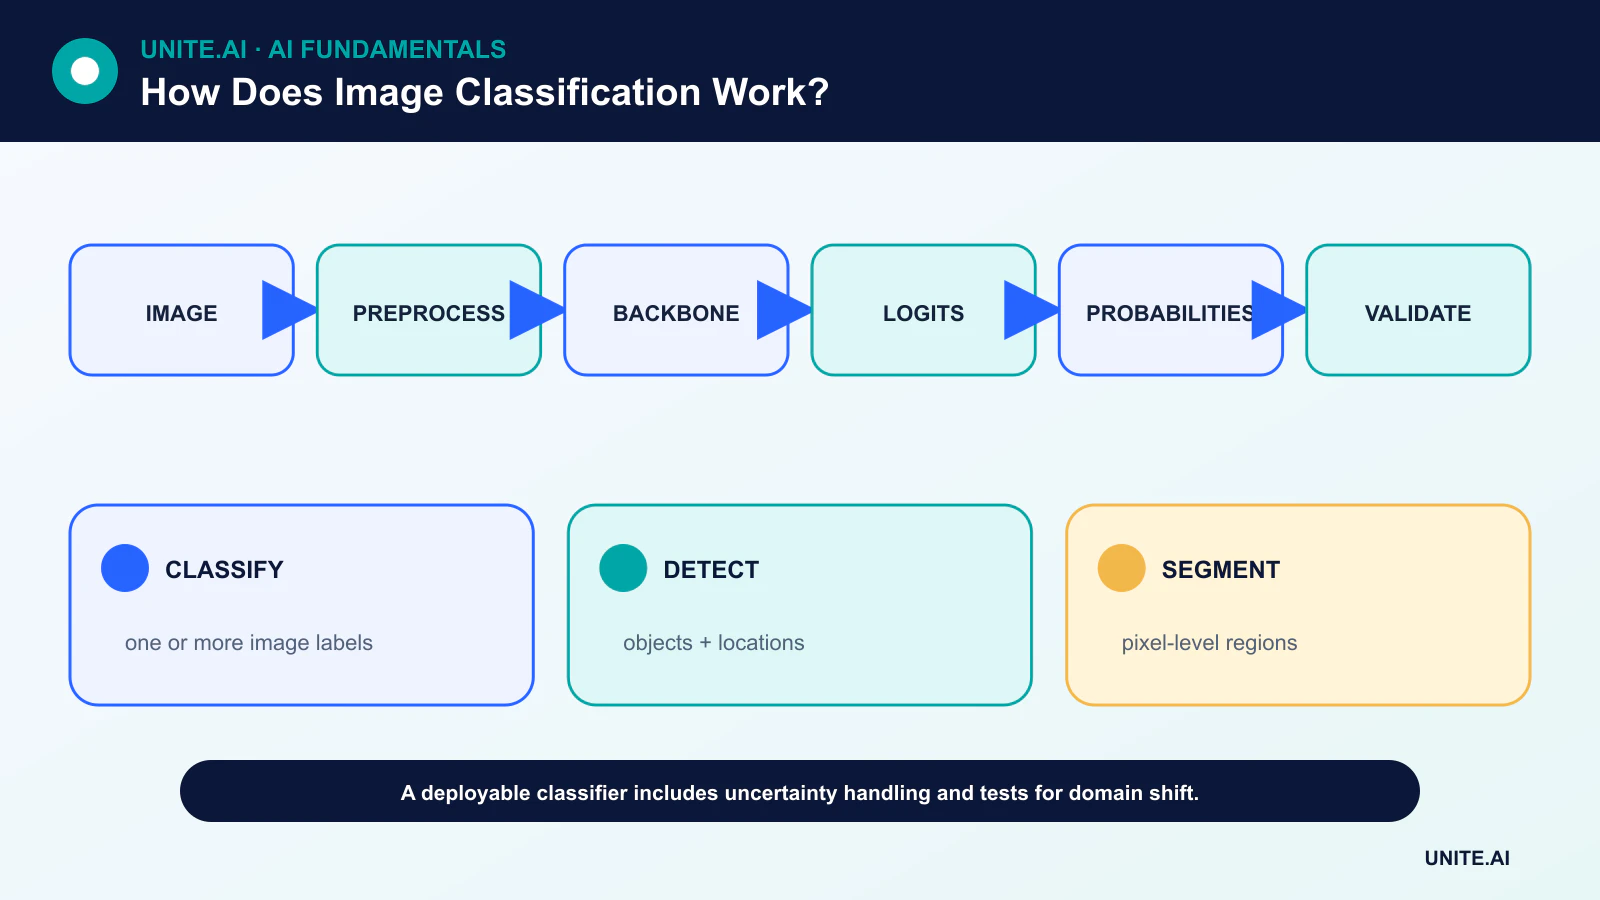
- La classification étiquette l’image entière ; la détection trace des boîtes autour des objets et la segmentation attribue des régions au niveau des pixels.
- Le pré‑entraînement et l’apprentissage par transfert peuvent réduire les besoins en données, mais un décalage de domaine peut annuler cet avantage.
- Une précision globale peut masquer un déséquilibre des classes, des raccourcis fallacieux et une mauvaise calibration.
- La qualité de l’image, le dispositif de capture, la géographie et les changements de flux de travail peuvent tous engendrer un déplacement de distribution.
Des pixels aux scores
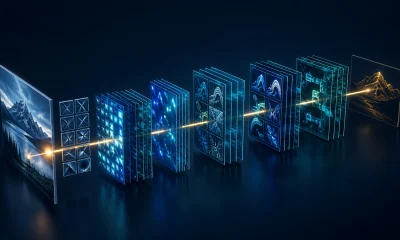
Les images sont redimensionnées ou recadrées, normalisées et converties en tenseurs. L’augmentation des données peut appliquer des transformations conservant les étiquettes, comme des retournements, des recadrages ou des modifications de couleur. Un réseau de base (backbone) transforme les pixels en caractéristiques ; une tête de classification produit des logits qui sont convertis en scores de classe relatifs.
Le prétraitement choisi doit correspondre au déploiement. Un recadrage central qui supprime l’objet pertinent ou un mauvais réglage de normalisation peuvent détériorer les performances même si les poids entraînés restent inchangés.
Réseaux de neurones convolutionnels et vision transformers
Les réseaux de neurones convolutionnels utilisent des filtres locaux et des poids partagés pour construire des caractéristiques spatiales. Les connexions résiduelles ont rendu les CNN très profonds plus faciles à optimiser. Les vision transformers découpent une image en patchs et utilisent l’attention pour modéliser les relations entre eux.
Les comparaisons d’architectures doivent contrôler les données d’entraînement, l’augmentation, la puissance de calcul et la résolution. Le meilleur modèle sur un benchmark public n’est pas forcément le plus adapté à un dispositif en périphérie, à un petit jeu de données ou à une exigence d’explicabilité.
Apprentissage par transfert et conception des données
L’apprentissage par transfert part de poids entraînés sur un jeu de données source plus vaste. Une équipe peut geler le réseau de base, affiner les couches supérieures ou mettre à jour le modèle complet. Le fine‑tuning nécessite généralement un taux d’apprentissage plus faible et un ensemble de validation à l’épreuve des fuites.
Les étiquettes doivent décrire ce qui est visiblement inférable. Si un diagnostic dépend d’un antécédent patient absent de l’image, le classificateur ne peut pas apprendre la décision clinique complète. Les doublons, les images issues d’une même vidéo et les images du même sujet doivent rester dans la même partition.
Métriques, incertitude et raccourcis
La précision top‑1 exige que la classe au score le plus élevé soit correcte ; la précision top‑k accepte que la classe correcte figure parmi les k scores les plus élevés. La précision, le rappel par classe et une matrice de confusion révèlent des erreurs inégales.
Les modèles peuvent exploiter les arrière‑plans, filigranes, équipements d’acquisition ou cadrages au lieu de l’objet visé. Les tests contrefactuels, l’analyse de sous‑groupes et les outils de saillance peuvent aider à découvrir ces raccourcis, mais une carte de chaleur d’explication n’est pas une preuve de raisonnement causal.
Surveillance du déploiement
Les contrôles en production doivent couvrir les fichiers corrompus, les dimensions inattendues, le flou, l’éclairage, les modèles de caméra et les nouvelles classes. La confiance doit être calibrée sur des données similaires à celles du déploiement, et les entrées hors du champ d’application doivent être rejetées ou réexaminées.
Surveiller les étiquettes retardées et les variations du coût d’erreur est essentiel. Un modèle qui semble stable d’après les statistiques d’entrée peut tout de même échouer si la relation entre les pixels et les étiquettes évolue.
Construire un jeu de données de classification d’images
La classification d’images attribue une ou plusieurs étiquettes à une image entière. Elle diffère de la détection, qui localise les objets, et de la segmentation, qui étiquette les pixels. Définissez la portée des classes, la hiérarchie, les règles multi‑étiquettes, les catégories d’arrière‑plan ou inconnues, et les preuves devant être visibles. Rassemblez des caméras, lieux, éclairages, points de vue, distances et sujets représentatifs du déploiement. Effectuez la séparation par sujet, scène, session ou source avant l’augmentation ; des images vidéo adjacentes ou des images de produit dupliquées entre partitions entraînent des fuites importantes.
Les consignes d’annotation doivent couvrir l’occlusion, les objets ambigus, les multiples classes, la faible qualité et l’abstention. Mesurez l’accord et examinez les désaccords systématiques. Un équilibre des classes ne garantit pas la couverture: une classe de maladie peut ne contenir qu’un seul dispositif ou une classe faunique un seul arrière‑plan. Inspectez les métadonnées et les quasi‑doublons, et conservez un jeu de test protégé issu d’une acquisition indépendante. Les données synthétiques et le web‑scraping peuvent élargir la variété mais introduisent des problèmes de licence, de provenance, de style et d’étiquetage qui doivent être évalués sur de vraies images.
Modèles, entraînement et évaluation
Les méthodes classiques combinent des descripteurs ingénierés avec un classificateur ; les systèmes modernes utilisent des réseaux convolutionnels ou des vision transformers, souvent via l’apprentissage par transfert. Les choix de redimensionnement et de recadrage déterminent quelles informations subsistent. L’augmentation doit refléter des variations valides et préserver les étiquettes. Optimisez une fonction de perte adaptée à la tâche, gérez le déséquilibre par pondération ou échantillonnage avec soin, et choisissez les points de contrôle sur les données de validation. Comparez avec une simple ligne de base et ablatez l’augmentation, la résolution et l’initialisation pré‑entraînée pour identifier d’où proviennent les gains.
Rapportez la précision, le rappel, le F1, la matrice de confusion, la précision top‑k lorsque pertinent, la calibration et les performances selon les conditions. Testez le flou, la compression, l’éclairage, le recadrage, l’occlusion, le dispositif et les entrées sans classe prise en charge. Les seuils de confiance peuvent diriger les cas incertains vers une révision ; la probabilité softmax n’est pas une confiance garantie, surtout en cas de déplacement. Les arrière‑plans contrefactuels et les tests d’occlusion révèlent l’apprentissage de raccourcis. Pour les usages liés à la sécurité, évaluez les pannes dans le pire des cas et les conséquences des faux positifs et faux négatifs.
Déploiement et surveillance
Regroupez le décodage, la conversion de couleur, l’orientation, la normalisation, le modèle et la carte des étiquettes. Validez l’artifact exporté ou quantifié sur les appareils cibles et mesurez la latence de bout en bout, la mémoire, la consommation d’énergie et le débit. Surveillez la qualité des images, les distributions d’entrée et de sortie, la calibration, les étiquettes confirmées et l’état des capteurs. Réduisez et sécurisez la conservation des images, notamment pour les visages, les emplacements et les passants. Fournissez un mécanisme de secours pour les entrées corrompues ou hors du champ d’application et revenez aux versions antérieures du modèle. La classification répond à la question définie au niveau de l’image ; elle ne doit pas être extrapolée à une localisation, une identité ou une intention non prises en charge.
Exemple pratique : classification des matériaux recyclables
Une installation photographie les articles sur un convoyeur et attribue la classe de matériau, la contamination et l’inconnu. Les images sont séparées par jour de collecte et lot d’objets, couvrant l’éclairage, les surfaces mouillées, le froissement, le chevauchement et les bandes vides. Un petit CNN et un modèle pré‑entraîné sont comparés à des règles de couleur et de forme. Le rappel par classe, les erreurs de tri, la calibration, le débit et les résultats selon la caméra et l’état du matériau orientent la sélection.
Le pipeline de production vérifie l’exposition de la caméra et le timing du convoyeur, puis envoie les articles incertains vers un flux général plutôt que d’imposer une classe. L’inférence quantifiée est validée sur le matériel exact. La surveillance suit la qualité des entrées, les taux de classe, les rejets et les audits manuels échantillonnés ; un nouvel emballage déclenche une mise à jour des données révisées. Le modèle contrôle un trieur limité avec des protections physiques, et une défaillance du capteur ou du modèle ramène le mécanisme à un état sûr au lieu de rediriger silencieusement le matériau.
Preuves d’implémentation et préparation opérationnelle
Une décision de production nécessite plus qu’une démonstration réussie. Définissez les utilisateurs prévus, l’environnement d’exploitation, les entrées, les sorties, les dépendances, le propriétaire et les conséquences de chaque défaillance importante. Établissez une base reproductible et un jeu d’évaluation versionné avant l’ajustement. Testez les cas ordinaires, les conditions limites, les entrées malformées ou manquantes, le déplacement de distribution, les pannes de dépendances, les usages abusifs, ainsi que les groupes ou environnements les plus susceptibles d’être négligés. Mesurez la qualité de la tâche conjointement avec la calibration ou l’incertitude, la latence, le débit, le coût des ressources, l’accessibilité, la confidentialité et la sécurité. Enregistrez chaque transformation et seuil afin qu’un évaluateur indépendant puisse reproduire le résultat et distinguer les preuves d’un prototype attrayant.
Avant le lancement, attribuez l’autorité pour la mise à jour, les exceptions, les modifications, le retour en arrière et la mise hors service. Utilisez un déploiement progressif, conservez un secours sûr et vérifiez la surveillance avec des pannes injectées délibérément. La télémétrie opérationnelle doit révéler la qualité des entrées, le comportement des sorties, la version du modèle ou de la règle, l’état des dépendances, les interventions humaines et les résultats confirmés sans collecter de données sensibles inutiles. Définissez les seuils d’alerte et le responsable de la réponse, puis examinez les preuves du monde réel après le déploiement plutôt que de supposer que la performance hors ligne persistera. Réévaluez chaque fois que les sources de données, les utilisateurs, les modèles, les fournisseurs, les politiques, le matériel ou les objectifs changent. Un système maintenu nécessite également des procédures documentées de récupération, d’apprentissage des incidents, de suppression et de conservation, ainsi qu’un point clair où il doit être désactivé ou remplacé.
Foire aux questions
Un classificateur d’images peut-il identifier plusieurs objets ?
Un classificateur multi‑étiquette peut indiquer quelles catégories sont présentes, mais il ne localise pas les instances individuelles. La détection d’objets est nécessaire pour obtenir des boîtes ou des décomptes.
Pourquoi un modèle peut‑il échouer sur des photos qui semblent normales à une personne ?
Il peut s’appuyer sur des artefacts de capture, des textures ou des corrélations qui ont changé. De petites différences de prétraitement et le déplacement de domaine peuvent également affecter les caractéristiques apprises.
Références principales