
Fondamentaux de l’IA
Qu’est‑ce que l’apprentissage par transfert ?

 Ajouter Unite.AI à vos sources préférées sur Google
Le transfert d’apprentissage réutilise les connaissances acquises pour un problème afin d’améliorer l’apprentissage sur un problème connexe. Au lieu d’initialiser chaque paramètre aléatoirement, le praticien part d’un modèle ou d’une représentation pré‑entraînée et l’adapte à une tâche cible.
Cette approche est particulièrement utile lorsque le jeu de données cible est petit, que l’étiquetage est coûteux, ou que le pré‑entraînement nécessite plus de calcul que ce que l’équipe cible peut justifier. Entraîner un modèle à partir de zéro constitue l’alternative au transfert d’apprentissage — ce n’est pas un type de transfert d’apprentissage.
Points clés
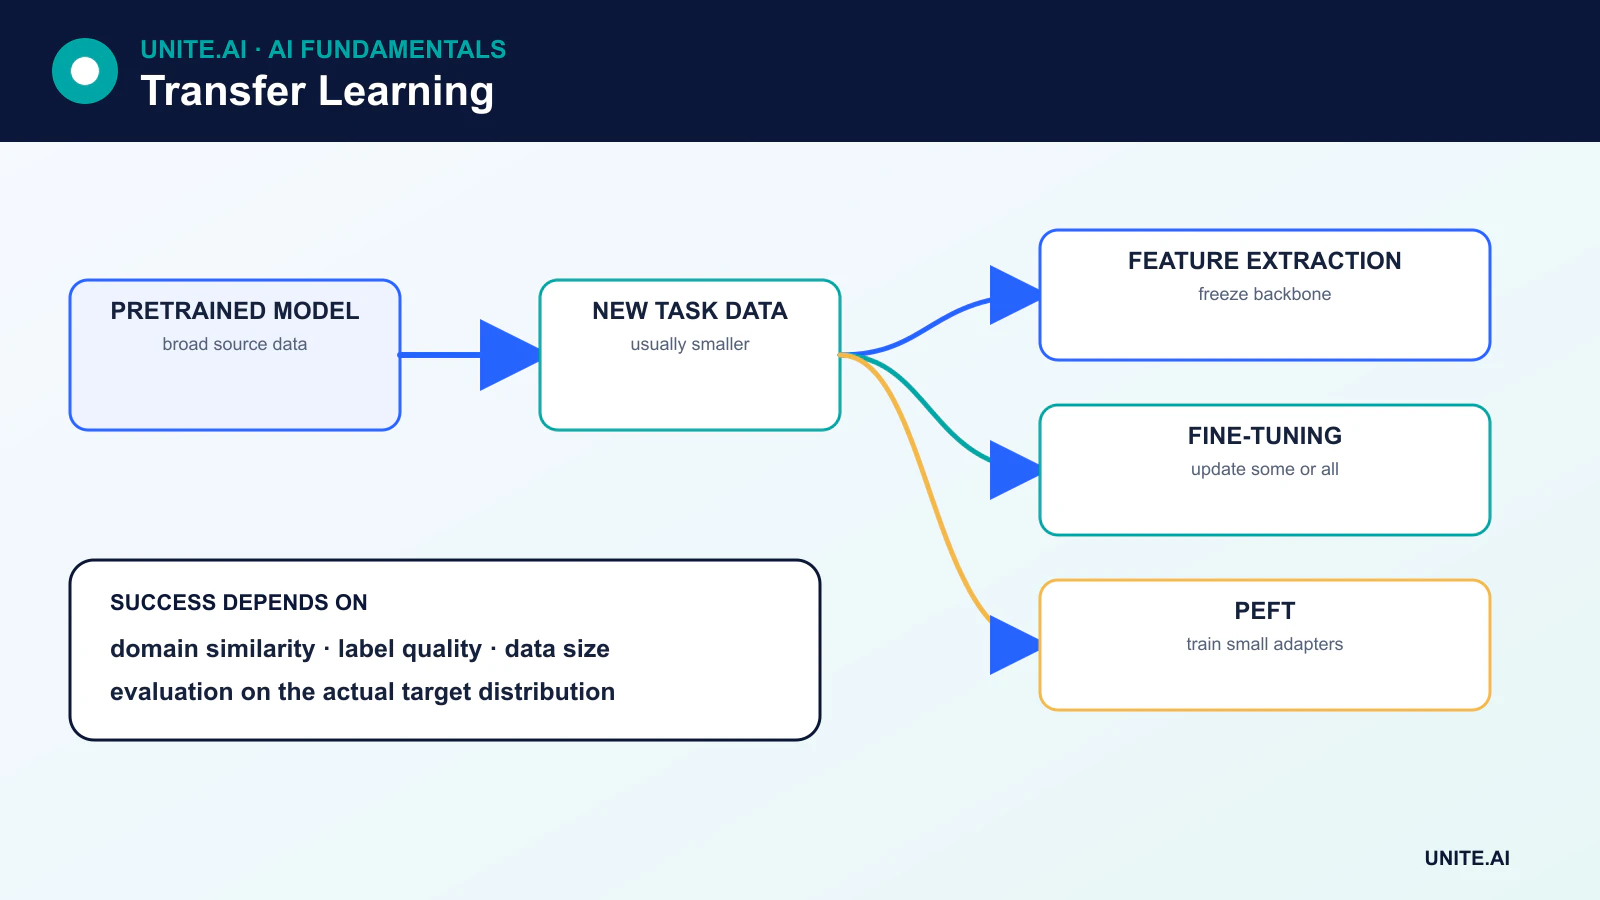
- L’extraction de caractéristiques maintient la base pré‑entraînée gelée et entraîne une nouvelle tête spécifique à la tâche.
- Le réglage fin met à jour certains ou tous les paramètres pré‑entraînés en utilisant les données du domaine cible.
- Les méthodes économes en paramètres, comme les adaptateurs et LoRA, mettent à jour une petite fraction du modèle.
- Le transfert peut échouer lorsque les domaines source et cible diffèrent, que les licences sont en conflit, ou que le modèle source comporte des biais inappropriés.
Pourquoi le transfert d’apprentissage fonctionne
Les modèles apprennent souvent des représentations utiles au‑delà des données exactes sur lesquelles ils ont été entraînés. Les premières couches d’un modèle d’image peuvent capturer des motifs locaux réutilisables ; un modèle de langage peut apprendre la syntaxe, la sémantique et de larges associations grâce à la prédiction auto‑supervisée. Une tâche cible peut s’appuyer sur ces représentations plutôt que de tout réapprendre à partir d’exemples limités.
Le bénéfice dépend de la similarité entre les tâches source et cible, de l’échelle et de la qualité du pré‑entraînement, ainsi que de la manière dont le modèle est adapté. La réutilisation n’est pas garantie: les caractéristiques transférées peuvent être hors de propos ou même nuisibles.
Extraction de caractéristiques
Dans l’extraction de caractéristiques, la base pré‑entraînée est gelée de sorte que ses paramètres ne changent pas. Sa sortie devient l’entrée d’un nouveau classificateur, régressseur ou autre tête spécifique à la tâche. Seule la nouvelle tête est entraînée.
C’est rapide et économe en données, et cela réduit le risque de détruire des représentations pré‑entraînées utiles. Cela peut aussi conduire à un sous‑apprentissage lorsque le domaine cible diffère sensiblement du pré‑entraînement. Des couches comme la normalisation de lot (batch normalization) nécessitent une attention particulière, car leurs statistiques stockées et leur comportement d’entraînement peuvent affecter l’adaptation même lorsque la plupart des poids sont gelés.
Réglage fin
Le réglage fin met à jour les paramètres pré‑entraînés sur les données cibles. Un flux de travail courant est:
- Charger le modèle pré‑entraîné et remplacer ou ajouter la tête de sortie.
- Geler la base et entraîner la nouvelle tête.
- Dé‑geler les couches sélectionnées — ou le modèle complet — et poursuivre avec un taux d’apprentissage plus faible.
- Valider pour détecter le surapprentissage, l’oubli et la performance dans le domaine cible.
Il n’existe aucune règle universelle stipulant que seules les couches finales doivent être réglées. Le meilleur choix dépend de l’architecture, de la taille des données cibles, de la similarité des domaines, des couches de normalisation, de la mémoire et de la puissance de calcul. Le réglage fin complet peut offrir davantage de capacité mais nécessite plus de ressources et peut entraîner un oubli catastrophique.
Réglage fin économe en paramètres
Les grands transformeurs rendent le réglage fin complet coûteux. Le réglage fin économe en paramètres (PEFT) modifie ou ajoute un petit ensemble de paramètres tout en laissant la majeure partie du modèle de base gelée.
- Adaptateurs insèrent de petits modules entraînables dans le réseau.
- LoRA représente les mises à jour de poids avec des matrices de rang faible, réduisant le nombre de paramètres entraînables et la mémoire de l’optimiseur.
- Réglage par invite (prompt) et préfixe apprend des entrées continues spécifiques à la tâche ou des préfixes internes.
Le PEFT peut stocker de nombreuses adaptations de tâches autour d’un même modèle de base, bien que le déploiement en inférence, la compatibilité des adaptateurs et la gestion des poids fusionnés nécessitent toujours une ingénierie minutieuse.
Transfert d’apprentissage selon les types de données
Les classificateurs d’images partent généralement de modèles pré‑entraînés sur de grands jeux de données d’images. Les systèmes de langage partent d’un modèle de base et l’adaptent via le réglage fin supervisé, l’optimisation des préférences, la récupération ou l’utilisation d’outils. Les modèles de parole, d’audio, de protéines et multimodaux suivent des schémas similaires.
Le transfert peut également se produire sans modifier le modèle original. Un modèle gelé peut produire des embeddings pour un classificateur en aval, un système de recherche de similarité vectorielle ou un pipeline de récupération.
Décalage de domaine et transfert négatif
Le décalage de domaine survient lorsque les entrées cibles diffèrent des données sources. Un modèle d’imagerie médicale, par exemple, peut rencontrer des équipements, des populations ou des protocoles d’acquisition absents du pré‑entraînement. Le transfert négatif signifie que la réutilisation détériore la performance cible par rapport à une base appropriée entraînée à partir de zéro.
Les équipes doivent comparer les stratégies d’adaptation, évaluer des sous‑groupes pertinents et conserver un jeu de test du domaine cible. Si la tâche source est mal assortie, un modèle plus petit et spécifique au domaine peut surpasser un modèle général plus grand.
Licences, provenance et sécurité
Un modèle téléchargeable n’est pas automatiquement sûr à déployer. Examinez la licence, les usages autorisés, les divulgations des données d’entraînement, les limitations de la fiche modèle et la chaîne de dépendances. Les modèles peuvent reproduire des biais, mémoriser des données sensibles ou contenir du code sérialisé malveillant. Utilisez des formats de confiance, analysez les artefacts et chargez les poids non fiables dans un environnement isolé.
Quand utiliser le transfert d’apprentissage
Le transfert d’apprentissage constitue une option par défaut solide lorsqu’un modèle pré‑entraîné pertinent existe et que les données cibles sont limitées. Entraîner à partir de zéro peut être préférable lorsque le domaine est très spécialisé, que la licence est incompatible, que la taille du modèle dépasse les limites de déploiement, ou qu’une tâche simple ne bénéficie pas d’une grande représentation pré‑entraînée. La décision doit être validée empiriquement plutôt que supposée à partir de l’échelle du modèle.
Ce qui se transfère et comment l’adapter
Le transfert d’apprentissage réutilise les représentations apprises sur une tâche ou un jeu de données source pour une tâche cible. En vision, les premières caractéristiques capturent souvent les contours et textures ; en langage, les modèles pré‑entraînés codent des motifs statistiques à travers les tokens et les contextes. Le transfert fonctionne lorsque les représentations sources contiennent des informations pertinentes pour la cible, mais les différences de domaine, d’étiquette, de modalité et d’acquisition peuvent engendrer un transfert négatif. Commencez avec une base pré‑entraînée, examinez sa licence d’entraînement et sa documentation, et comparez-la à l’entraînement d’un petit modèle spécifique à la cible à partir de zéro.
L’extraction de caractéristiques gèle le réseau principal et entraîne une nouvelle tête ; le réglage fin partiel dé‑gèle les couches sélectionnées ; le réglage fin complet met à jour l’ensemble du modèle. Les méthodes économes en paramètres ajoutent des adaptateurs ou des mises à jour à rang faible, réduisant les paramètres entraînables mais pas nécessairement la mémoire d’inférence. Utilisez un taux d’apprentissage plus faible pour les poids pré‑entraînés, préservez le comportement de normalisation, et évitez l’oubli catastrophique grâce à des plannings, de la régularisation, de la révision ou des mises à jour contraintes si nécessaire. Sélectionnez des points de contrôle sur les données de validation cible et testez plusieurs graines, car les petits jeux de données cibles entraînent une forte variance.
Compromis entre données, évaluation et déploiement
Les données cibles doivent représenter les conditions de déploiement et les sous‑groupes importants, et ne pas se limiter à un échantillon étiqueté pratique. Divisez par sujet, source, temps ou localisation afin d’empêcher que des exemples liés traversent les partitions. Testez à la fois les conditions en‑domaine et décalées. Comparez les variantes gelées, partiellement réglées et entièrement réglées en termes de qualité, de calibration, de coût d’entraînement, de latence et de robustesse. Une amélioration du score moyen peut masquer une perte sur des classes rares héritées d’un biais source. Examinez les exemples d’échec pour détecter des raccourcis spécifiques à la source, des lacunes lexicales ou des différences de capteurs.
Suivez le modèle de base, les poids, le tokenizer ou le pré‑traitement, l’adaptateur, les données et la licence comme un seul graphe de dépendances. Les modèles de base hébergés peuvent changer de comportement ; les poids ouverts peuvent introduire des responsabilités de chaîne d’approvisionnement et de correctifs. Validez l’artifact fusionné ou exporté et analysez les fichiers de modèle provenant de sources non fiables. En production, surveillez le dérive et la performance de la cible, et conservez la capacité de revenir en arrière tant sur l’adaptation que sur la version de base. Le transfert réduit la quantité de données cibles requises ; il n’élimine pas l’étiquetage, l’évaluation, la confidentialité ou l’expertise du domaine.
Exemple concret: adaptation d’un modèle de vision à une nouvelle clinique
Une clinique adapte un encodeur d’imagerie pré‑entraîné pour classer la qualité des images avant la révision diagnostique. Elle vérifie la licence du modèle source et la modalité prévue, collecte les appareils locaux et les conditions d’acquisition, et effectue une division par patient. Les variantes à caractéristiques gelées, adaptateur, réglage fin partiel et complet sont comparées à une petite référence locale. Les métriques comprennent le rappel par classe, la calibration, le comportement des sous‑groupes, la charge de calcul et la sensibilité aux appareils, sites et artefacts rares.
Le modèle adapté ne peut pas poser de diagnostic et dirige les images à faible confiance ou non prises en charge vers les techniciens. La validation d’exportation confirme le pré‑traitement local et l’équivalence numérique. Les versions du modèle, de l’adaptateur, de l’appareil et du jeu de données sont liées dans le registre. La surveillance détecte les nouveaux scanners, les changements de protocole et la dérive des sorties, tandis que des échantillons révisés périodiquement estiment la performance réelle. Une mise à jour du modèle source est considérée comme une nouvelle dépendance nécessitant une validation ; le transfert d’apprentissage ne justifie pas automatiquement la réutilisation d’anciennes preuves.
Preuves d’implémentation et préparation opérationnelle
Une décision de production nécessite plus qu’une démonstration réussie. Définissez les utilisateurs prévus, l’environnement opérationnel, les entrées, les sorties, les dépendances, le responsable et les conséquences de chaque défaillance importante. Établissez une base de référence reproductible et un ensemble d’évaluation versionné avant le réglage. Testez les cas ordinaires, les conditions limites, les entrées malformées ou manquantes, le décalage de distribution, les pannes de dépendances, les usages abusifs, ainsi que les groupes ou environnements les plus susceptibles d’être sous‑servis. Mesurez la qualité de la tâche conjointement avec la calibration ou l’incertitude, la latence, le débit, le coût des ressources, l’accessibilité, la confidentialité et la sécurité. Enregistrez chaque transformation et seuil afin qu’un examinateur indépendant puisse reproduire le résultat et distinguer la preuve d’un prototype attrayant.
Avant le lancement, attribuez l’autorité pour la diffusion, les exceptions, les modifications, les retours en arrière et la mise hors service. Utilisez un déploiement progressif, conservez une solution de secours sécurisée et vérifiez la surveillance avec des pannes intentionnellement injectées. La télémétrie opérationnelle doit révéler la qualité des entrées, le comportement des sorties, la version du modèle ou de la règle, l’état des dépendances, les interventions humaines et les résultats confirmés, sans collecter de données sensibles inutiles. Définissez les seuils d’alerte et le responsable de la réponse, puis examinez les preuves du monde réel après le déploiement plutôt que de supposer que la performance hors ligne persistera. Réévaluez chaque fois que les sources de données, les utilisateurs, les modèles, les fournisseurs, les politiques, le matériel ou les objectifs changent. Un système maintenu nécessite également une récupération documentée, un apprentissage des incidents, des procédures de suppression et de conservation, ainsi qu’un point clair où il doit être désactivé ou remplacé.
Références principales











