AI:n perusteet
Mikä on siirtooppiminen?

 Lisää Unite.AI suosikkilähteisiisi Google-palvelussa
Transfer learning hyödyntää tietoa, joka on opittu yhdelle ongelmalle, parantaakseen oppimista liittyvässä ongelmassa. Sen sijaan, että kaikki parametrit alustettaisiin satunnaisesti, käytännön tekijä aloittaa esikoulutetusta mallista tai esityksestä ja soveltaa sitä kohde‑tehtävään.
Tämä lähestymistapa on erityisen hyödyllinen, kun kohde‑datasarja on pieni, merkintä on kallista tai esikoulutus vaatii enemmän laskentatehoa kuin kohde‑tiimi voi perustella. Mallin kouluttaminen alusta alkaen on siirtooppimisen vaihtoehto – ei siirtooppimisen tyyppi.
Keskeiset havainnot
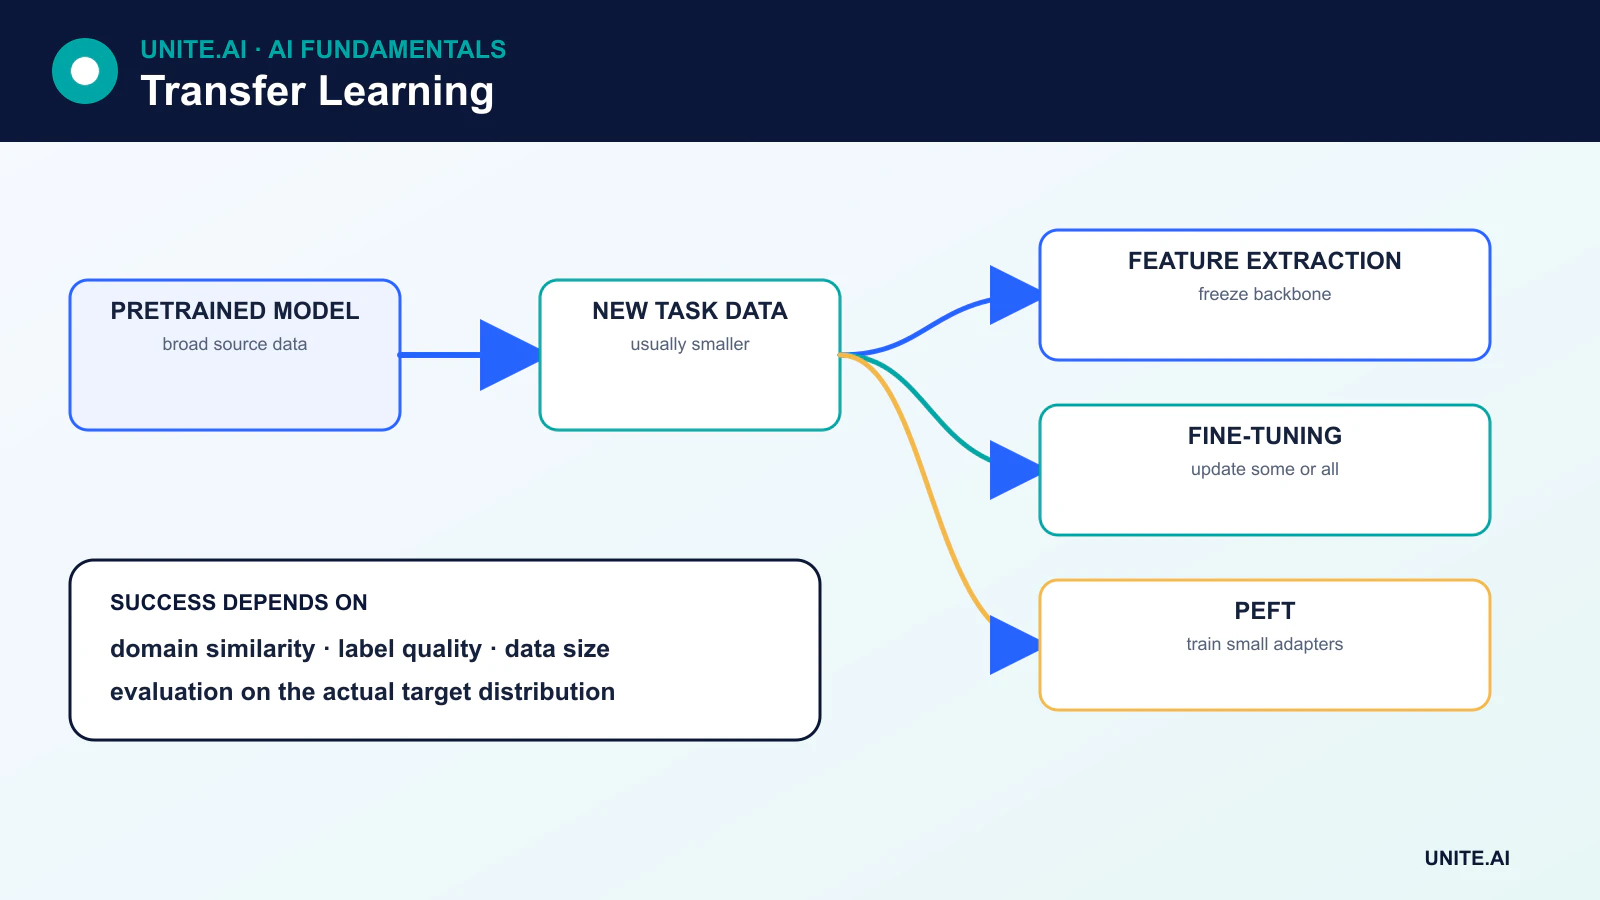
- Ominaisuuksien poiminta pitää esikoulutetun perustan jäädytettynä ja kouluttaa uuden tehtäväkohtaisen päätason.
- Jälkikoulutus päivittää joitakin tai kaikki esikoulutetut parametrit kohdealueen datalla.
- Parametrien tehokkaat menetelmät, kuten adapterit ja LoRA, päivittävät vain pienen osan mallista.
- Siirto voi epäonnistua, kun lähde- ja kohdealueet eroavat, lisenssit ovat ristiriidassa tai lähdemalli sisältää sopimattoman harhan.
Miksi siirtooppiminen toimii
Mallit oppivat usein esityksiä, jotka ovat hyödyllisiä myös sen tarkkaa dataa, jolla ne on koulutettu, pidemmälle. Kuvamallin varhaiset kerrokset voivat tallentaa uudelleenkäytettäviä paikallisia kuvioita; kielimalli voi oppia syntaksin, semantiikan ja laajat assosiaatiot itsevalvotusta ennustamisesta. Kohde‑tehtävä voi hyödyntää näitä esityksiä sen sijaan, että se oppisi kaiken uudelleen rajoitetuista esimerkeistä.
Hyöty riippuu lähde‑ ja kohde‑tehtävien samankaltaisuudesta, esikoulutuksen mittakaavasta ja laadusta sekä siitä, miten malli mukautetaan. Uudelleenkäyttö ei ole taattua: siirretyt ominaisuudet voivat olla merkityksettömiä tai jopa haitallisia.
Ominaisuuksien poiminta
Ominaisuuksien poiminnassa esikoulutettu perusta jäädytetään, jolloin sen parametrit eivät muutu. Sen lähtö toimii syötteenä uudelle luokittelijalle, regressiolle tai muulle tehtäväkohtaiselle päätasolle. Vain uusi päätaso koulutetaan.
Tämä on nopeaa ja data‑tehokasta, ja se vähentää riskin, että hyödyllisiä esikoulutettuja esityksiä tuhotaan. Se voi myös alijäsentää, kun kohdealue poikkeaa merkittävästi esikoulutuksesta. Kerrokset kuten eränormaalointi (batch normalization) vaativat erityistä huomiota, koska niiden tallennetut tilastot ja koulutuskäyttäytyminen voivat vaikuttaa mukautukseen, vaikka suurin osa painoista olisi jäädytetty.
Jälkikoulutus
Fine-tuning päivittää esikoulutettuja parametreja kohdedatalla. Yleinen työnkulku on:
- Lataa esikoulutettu malli ja korvaa tai lisää lähtöpäätä.
- Jäädytä perusta ja kouluta uusi päätaso.
- Poista valittujen kerrosten jäädytys – tai koko mallin – ja jatka pienemmällä oppimisnopeudella.
- Tarkista ylisovittaminen, unohtuminen ja kohdealueen suorituskyky.
Ei ole yleispätevää sääntöä, jonka mukaan vain viimeisiä kerroksia tulisi hienosäätää. Paras valinta riippuu arkkitehtuurista, kohdedatan koosta, alueen samankaltaisuudesta, normalisointikerroksista, muistista ja laskentatehosta. Täysi jälkikoulutus voi tarjota enemmän kapasiteettia, mutta se vaatii enemmän resursseja ja saattaa aiheuttaa katastrofaalista unohtamista.
Parametrien tehokas jälkikoulutus
Suuret transformerit tekevät täyden jälkikoulutuksen kalliiksi. Parametrien tehokas jälkikoulutus (PEFT) muokkaa tai lisää pienen määrän parametreja jättäen suurimman osan perusmallista jäädytettynä.
- Adapters lisäävät pieniä koulutettavia moduuleja verkkoon.
- LoRA esittää painopäivitykset matalarankkisten matriisien avulla, vähentäen koulutettavien parametrien määrää ja optimointimuistin käyttöä.
- Prompt and prefix tuning oppii jatkuvia tehtäväkohtaisia syötteitä tai sisäisiä prefiksejä.
PEFT voi tallentaa monia tehtäväkohtaisia mukautuksia yhden perusmallin ympärille, vaikka inferenssin tarjoaminen, adapterien yhteensopivuus ja yhdistettyjen painojen hallinta vaativat edelleen tarkkaa suunnittelua.
Siirtooppiminen eri datatyypeissä
Kuvaluokittelijat aloittavat tyypillisesti malleista, jotka on esikoulutettu suurilla kuvadatasetillä. Kielen järjestelmät alkavat perustamismallista ja mukauttavat sitä valvotun jälkikoulutuksen, mieltymyksen optimoinnin, haun tai työkalujen käytön kautta. Puhe-, ääni-, proteiini- ja multimodaalimallit noudattavat samankaltaisia malleja.
Siirto voi myös tapahtua muuttamatta alkuperäistä mallia. Jäädytetty malli voi tuottaa upotuksia alapuoliseen luokittelijaan, vektorisamanhakujärjestelmään tai hakuputkeen.
Alueen siirtymä ja negatiivinen siirto
Domain shift tapahtuu, kun kohde‑syötteet poikkeavat lähdedatasta. Esimerkiksi lääketieteellinen kuvamalli voi kohdata laitteita, väestöryhmiä tai hankintaprotokollia, joita ei ollut esikoulutuksessa. Negative transfer tarkoittaa, että uudelleenkäyttö heikentää kohteen suorituskykyä verrattuna sopivaan alusta alkaen -vertailuun.
Tiimien tulisi vertailla mukautusstrategioita, arvioida merkityksellisiä alaryhmiä ja pitää kohdealueen testijoukkoa. Jos lähdetehtävä on huonosti sovitettu, pienempi alakohtainen malli saattaa ylittää suuremman yleismallin.
Lisensointi, alkuperä ja turvallisuus
Ladattavissa oleva malli ei ole automaattisesti turvallinen käyttöönotettavaksi. Tarkista lisenssi, sallitut käyttötavat, koulutusdatan ilmoitukset, mallikortin rajoitukset ja riippuvuusketju. Mallit voivat toistaa harhoja, muistaa arkaluontoista dataa tai sisältää haitallista sarjoitettua koodia. Käytä luotettuja formaatteja, tarkista artefaktit ja lataa epäluotettavat painot eristetyssä ympäristössä.
Milloin käyttää siirtooppimista
Siirtooppiminen on vahva oletus, kun relevantti esikoulutettu malli on olemassa ja kohdedata on rajallista. Alusta alkaen kouluttaminen voi olla suositeltavampaa, kun alue on erittäin erikoistunut, lisenssi on yhteensopimaton, mallin koko ylittää käyttöönoton rajoitukset tai yksinkertainen tehtävä ei hyödynnä suurta esikoulutettua esitystä. Päätös tulisi vahvistaa empiirisesti sen sijaan, että oletetaan mallin mittakaavasta.
Mitä siirretään ja miten sitä mukautetaan
Siirtooppiminen käyttää uudelleen esityksiä, jotka on opittu lähdetehtävässä tai -datasetissä, kohde‑tehtävää varten. Näkökentässä varhaiset ominaisuudet usein tallentavat reunat ja tekstuurit; kielessä esikoulutetut mallit koodaavat tilastollisia malleja tokenien ja kontekstien välillä. Siirto toimii, kun lähde‑esitykset sisältävät kohteelle merkityksellistä tietoa, mutta alueen, merkintöjen, modaliteetin ja hankintojen erot voivat aiheuttaa negatiivista siirtoa. Aloita esikoulutetusta perusmallista, tarkista sen koulutuslisenssi ja dokumentaatio, ja vertaa sitä pienen kohdekohtaisen mallin kouluttamiseen alusta alkaen.
Ominaisuuksien poiminta jäädyttää rungon ja kouluttaa uuden päätason; osittainen jälkikoulutus avaa valittuja kerroksia; täysi jälkikoulutus päivittää koko mallin. Parametrien tehokkaat menetelmät lisäävät adaptereita tai matalarankkisia päivityksiä, vähentäen koulutettavien parametrien määrää, mutta eivät välttämättä pienennä inferenssimuistia. Käytä pienempää oppimisnopeutta esikoulutettuihin painoihin, säilytä normalisoinnin käyttäytyminen, ja vältä katastrofaalista unohtamista aikatauluilla, regularisaatiolla, harjoittelulla tai rajoitetuilla päivityksillä tarpeen mukaan. Valitse tarkistuspisteet kohdevalidointidatasta ja testaa useita siemeniä, koska pienet kohdedatasetit aiheuttavat suurta vaihtelua.
Data, arviointi ja käyttöönoton kompromissit
Kohdedatan tulisi edustaa käyttöönotto‑olosuhteita ja tärkeitä alaryhmiä, eikä pelkästään olla kätevä merkattu otos. Jaa aineisto aiheittain, lähteittäin, ajankohdittain tai sijainneittain estääksesi samankaltaisten esimerkkien leikkaamisen osioihin. Testaa sekä sisäiset että siirtyneet olosuhteet. Vertaa jäädytettyjä, osittain hienosäädettyjä ja täysin hienosäädettyjä variantteja laadun, kalibroinnin, koulutuskustannusten, viiveen ja kestävyyden osalta. Keskimääräisen pisteen parannus voi piilottaa harvinaisten luokkien menetyksen, joka periytyy lähdeharhasta. Tarkastele epäonnistumisesimerkkejä lähdekohtaisista oikopolkuista, sanaston puutteista tai anturieroista.
Seuraa perusmallia, painoja, tokenisoijaa tai esikäsittelyä, adapteria, dataa ja lisenssiä yhtenä riippuvuusgraafina. Isännöidyt perusmallit voivat muuttaa käyttäytymistään; avoimet painot voivat tuoda toimitusketju‑ ja korjausvastuuta. Vahvista yhdistetty tai viety artefakti ja tarkista mallitiedostot epäluotettavista lähteistä. Tuotannossa seuraa kohde‑driftiä ja suorituskykyä, ja säilytä mahdollisuus palauttaa sekä mukautus että perusversio. Siirto vähentää vaadittavan kohdedatan määrää; se ei poista merkintää, arviointia, yksityisyyttä tai alakohtaista asiantuntemusta.
Käytännön esimerkki: vision‑mallin mukauttaminen uuteen klinikkaan
Klinikka mukauttaa esikoulutettua kuvankooderia luokittelemaan kuvan laadun ennen diagnostista tarkastelua. Se tarkistaa lähdemallin lisenssin ja suunnitellun modaliteetin, kerää paikalliset laitteet ja hankintaehtoja, ja jakaa potilaan mukaan. Jäädytetyt ominaisuudet, adapterit, osittainen ja täysi jälkikoulutus –variantit vertaillaan pieneen paikalliseen perusmalliin. Mittareita ovat luokan palautus, kalibrointi, alaryhmän käyttäytyminen, laskenta ja herkkyys laitteeseen, sijaintiin ja harvinaisiin artefakteihin.
Mukautettu malli ei voi tehdä diagnoosia ja ohjaa matalan luottamuksen tai tukemattomat kuvat teknikoille. Vientivalidaatio vahvistaa paikallisen esikäsittelyn ja numeerisen yhtäpitävyyden. Mallin, adapterin, laitteen ja datasetin versiot linkitetään kirjanpitoon. Seuranta havaitsee uudet skannerit, protokollamuutokset ja tulosdriftin, kun taas säännöllisesti tarkastellut näytteet arvioivat todellista suorituskykyä. Lähdemallin päivitys käsitellään uutena riippuvuutena, joka vaatii validoinnin; siirtooppiminen ei automaattisesti oikeuta vanhan evidenssin uudelleenkäyttöön.
Toteutustodisteet ja operatiivinen valmius
Tuotantopäätös vaatii enemmän kuin onnistuneen demonstraation. Määrittele kohdekäyttäjät, käyttöympäristö, syötteet, tulosteet, riippuvuudet, omistaja ja jokaisen tärkeän vian seuraukset. Perusta toistettavissa oleva perusmalli ja versioitu arviointijoukko ennen hienosäätöä. Testaa tavalliset tapaukset, reunat, virheelliset tai puuttuvat syötteet, jakauman siirtymä, riippuvuuden katkos, väärinkäyttö sekä ryhmät tai ympäristöt, joille palvelu todennäköisesti puuttuu. Mittaa tehtävän laatu yhdessä kalibroinnin tai epävarmuuden, viiveen, läpimenoajan, resurssikustannusten, saavutettavuuden, yksityisyyden ja turvallisuuden kanssa. Tallenna jokainen muunnos ja kynnysarvo, jotta itsenäinen tarkastaja voi toistaa tuloksen ja erottaa evidenssin houkuttelevasta prototyypistä.
Ennen julkaisua määritä vastuuhenkilöt julkaisuun, poikkeuksiin, muutoksiin, palautuksiin ja poistoon. Käytä vaiheistettua käyttöönottoa, säilytä turvallinen varajärjestelmä ja varmista seuranta tarkoituksellisesti injektoiduilla virheillä. Operatiivisen telemetrian tulisi paljastaa syötteen laatu, tuloksen käyttäytyminen, mallin tai säännön versio, riippuvuuksien tila, ihmisen ohitukset ja vahvistetut tulokset keräämättä tarpeetonta arkaluontoista dataa. Määrittele hälytyskynnysarvot ja vastaavan omistaja, tarkastele sitten todellista evidenssiä käyttöönoton jälkeen sen sijaan, että oletetaan offline‑suorituskyvyn säilyvän. Arvioi uudelleen aina, kun datalähteet, käyttäjät, mallit, toimittajat, käytännöt, laitteisto tai tavoitteet muuttuvat. Ylläpidettävä järjestelmä tarvitsee myös dokumentoidun palautumisen, tapausten oppimisen, poistamisen ja säilytyskäytännöt sekä selkeän pisteen, jossa se tulee poistaa käytöstä tai korvata.
Ensisijaiset lähteet