
AI:n perusteet
Mikä on federatiivinen oppiminen?

 Lisää Unite.AI suosikkilähteisiisi Google-palvelussa
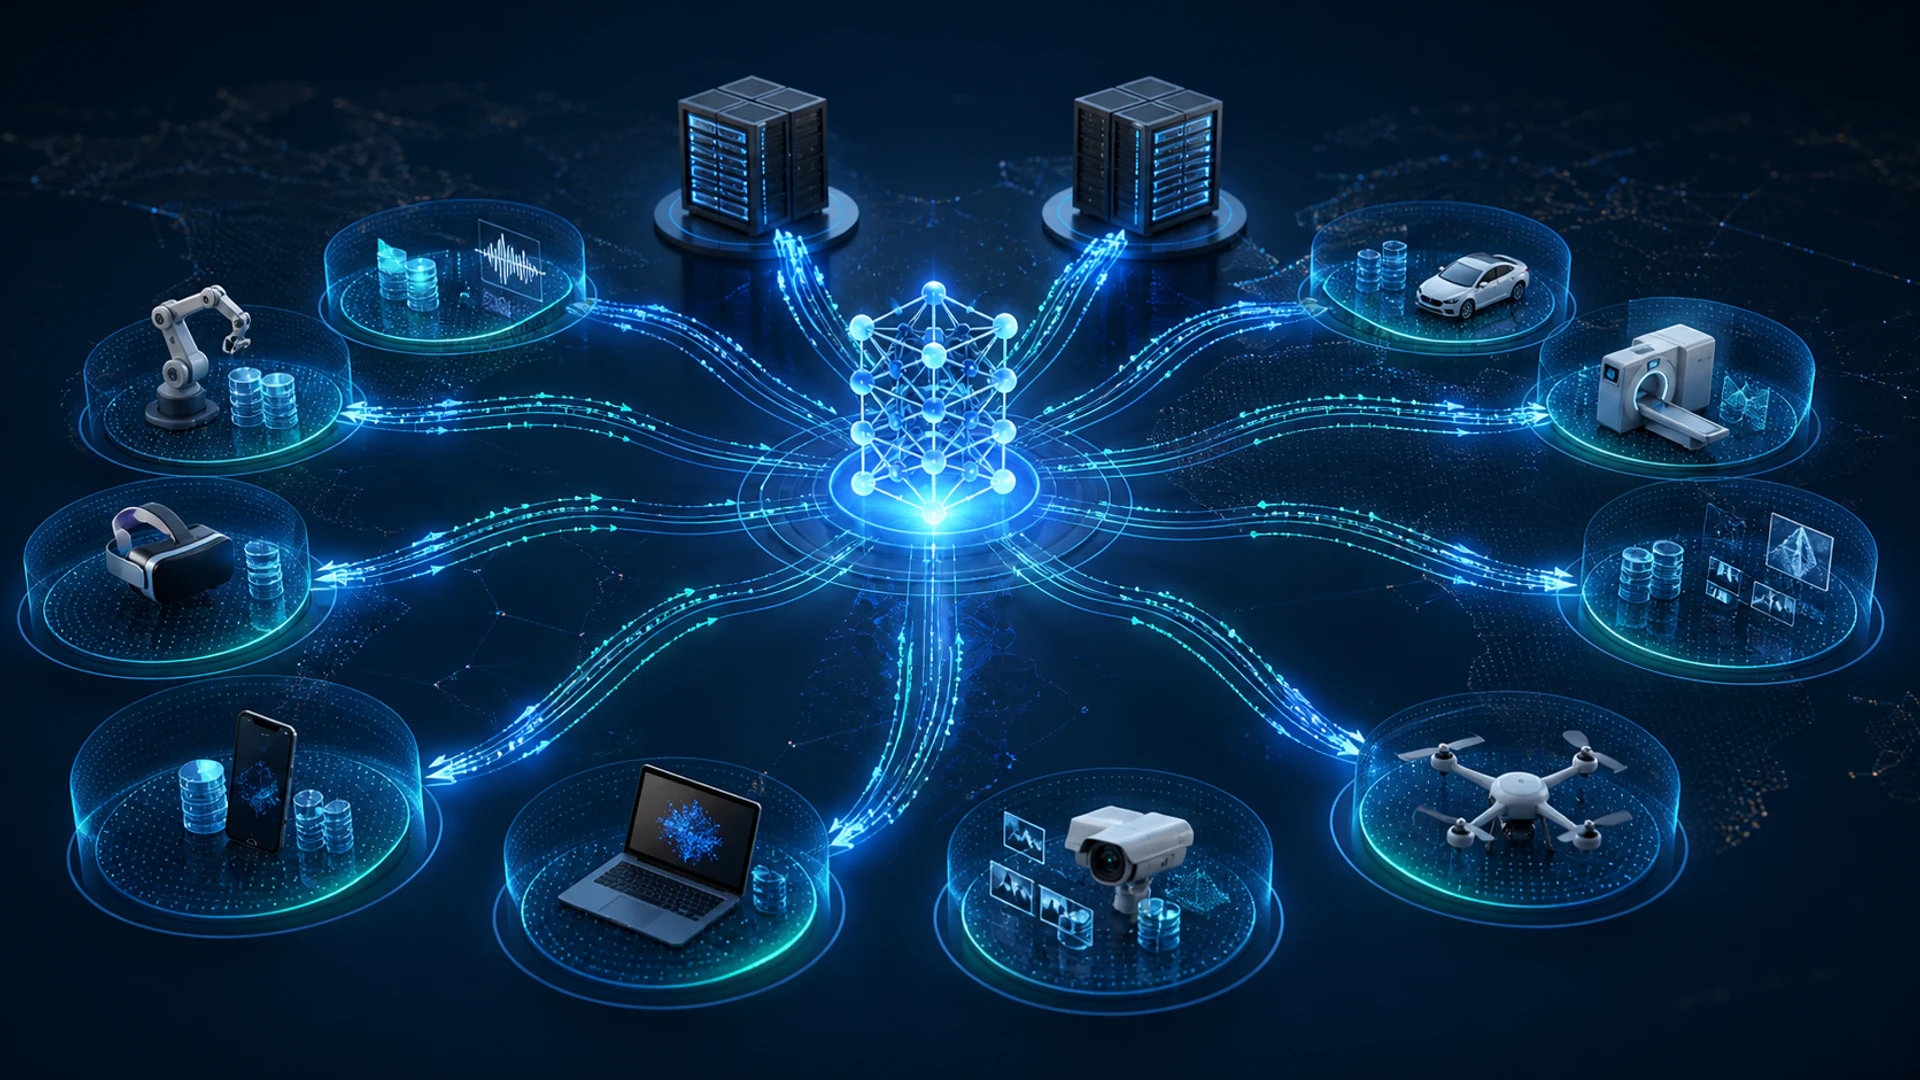
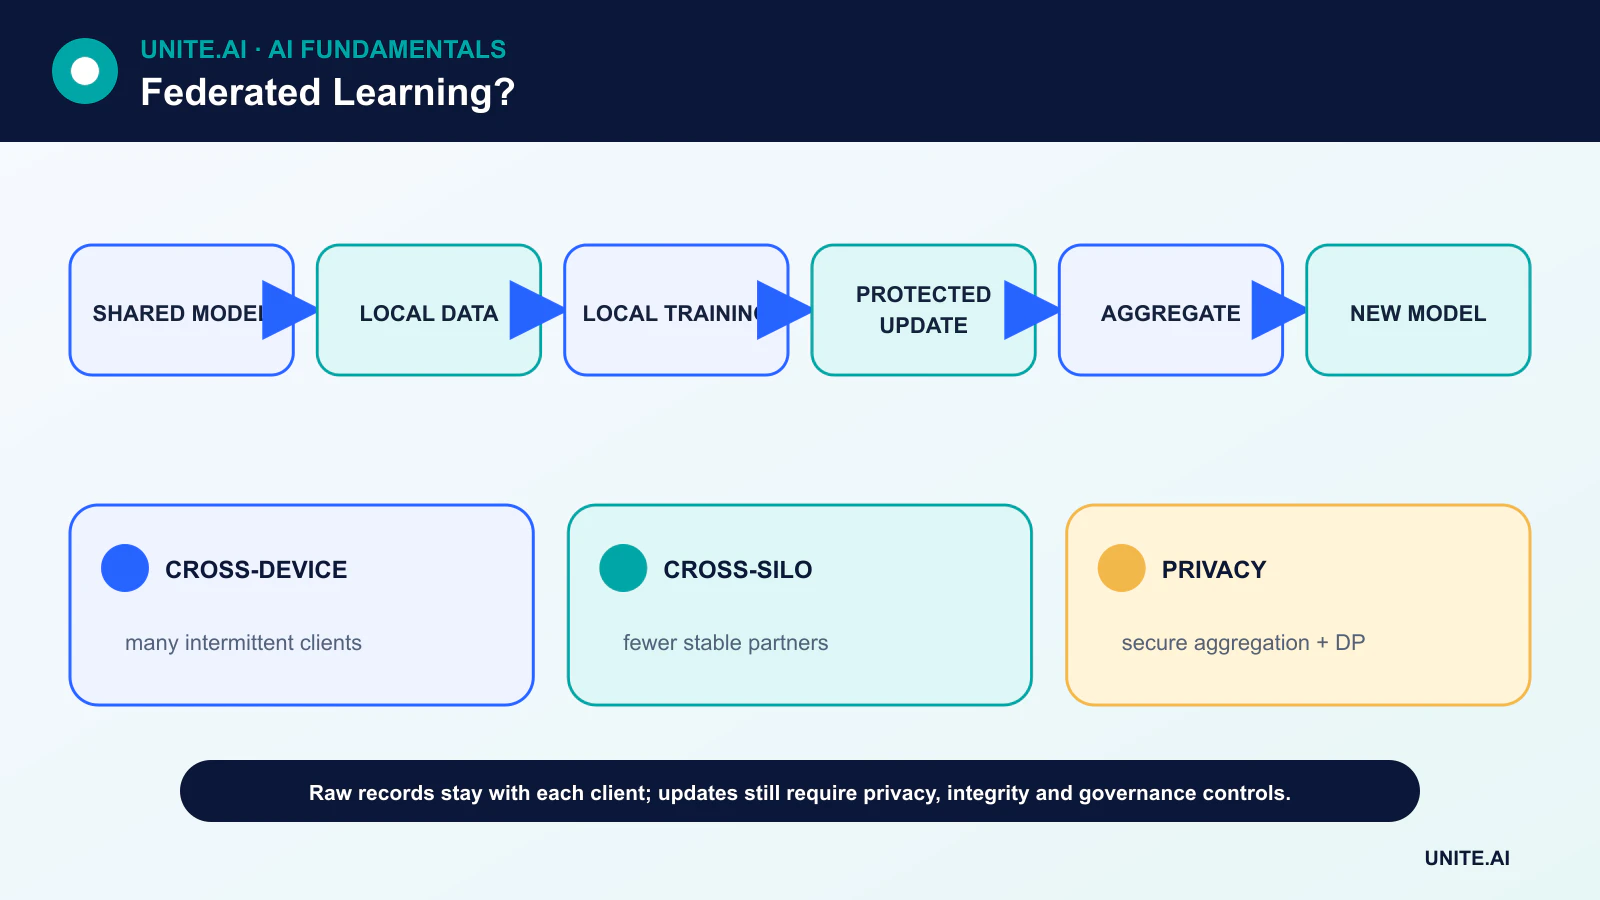
Federatiivinen oppiminen kouluttaa jaettua mallia useiden laitteiden tai organisaatioiden välillä pitäen kunkin osallistujan raakakoulutusdatan paikallisena. Koordinaattori jakaa malliparametrit, asiakkaat laskevat päivitykset omilla tiedoillaan, ja aggregointivaihe yhdistää nämä päivitykset.
Datankäsittelyn pitäminen paikallisena on hyödyllistä, mutta se ei ole sama kuin yksityisyys tai turvallisuus. Mallipäivitykset voivat vuotaa tietoa, vaarantuneet asiakkaat voivat myrkyttää koulutuksen, ja koordinaattori tarvitsee silti todennuksen, siirto‑turvallisuuden, käyttöoikeuksien hallinnan ja määritellyn luottamusmallin.
Keskeiset havainnot
- Federatiivinen oppiminen siirtää laskennan hajautettuun dataan; se ei siirrä raakadataa yhteen keskitettyyn kouluttajaan.
- Laitteiden välinen järjestelmä sisältää monia satunnaisia laitteita, kun taas silo‑välinen järjestelmä koostuu vähemmän, vakaammista organisaatioista.
- Turvallinen aggregointi ja differentiaalinen yksityisyys käsittelevät eri riskejä ja ne voidaan yhdistää.
- Ei‑IID‑data, rajoitettu kaistanleveys, epäluotettava osallistuminen ja haitalliset päivitykset ovat keskeisiä suunnittelurajoitteita.
Federatiivisen keskiarvon elinkaari
Tyypillinen kierros alkaa, kun koordinaattori valitsee kelvolliset asiakkaat ja lähettää nykyisen mallin. Jokainen asiakas kouluttaa paikallisesti rajoitetun määrän askeleita, tuottaen parametripäivityksen tai gradienttipäivityksen. Koordinaattori aggregoi kelvolliset päivitykset – usein painottaen paikallisten esimerkkimäärien perusteella – ja julkaisee uuden jaetun mallin.
Vain murto‑osa asiakkaista voi osallistua kuhunkin kierrokseen. Protokollan on kestettävä katkoksia, versioerot ja laitteet, jotka eivät voi kouluttaa latauksen, käytön tai offline‑tilan aikana. Viestintä voi hallita laskentaa, joten päivitysten pakkaaminen ja vähemmän kierroksia vievät usein enemmän kuin raudan nopeus.
Laitteiden välinen vs. silo‑välinen
Laitteiden välinen federatiivinen oppiminen voi sisältää puhelimia, antureita tai selaimia, jotka omistavat monet yksilöt. Asiakkaita on lukuisia, luottamus on heikkoa ja saatavuus on satunnaista. Silo‑välinen federatiivinen oppiminen yhdistää yleensä pienemmän joukon sairaaloita, pankkeja tai liiketoimintayksiköitä, joilla on vakaa infrastruktuuri ja sopimuksellinen hallinta.
Kaksi asetelmaa vaativat erilaiset identiteetti‑, audit‑ ja vikamallit. Silo‑projektissa voidaan neuvotella yhteinen skeema ja validointiprosessi; laite‑palvelussa on käsiteltävä miljoonia ohjelmistoversioita ja erittäin epätasaisia paikallisia tietojoukkoja.
Turvallinen aggregointi, differentiaalinen yksityisyys ja salaus
Turvallinen aggregointi on kryptografinen protokolla, jonka avulla palvelin voi palauttaa aggregaatin lukematta yksittäisen asiakkaan päivitystä. Differentiaalinen yksityisyys rajoittaa, kuinka paljon julkaistu tulos voi riippua mistä tahansa yksittäisestä tietueesta tai osallistujasta, leikkaamalla kontribuutiot ja lisäämällä kalibroitua kohinaa.
Kumpikaan mekanismi ei korjaa kaikkia riskejä. Turvallinen aggregointi ei tee aggregaattia vaarattomaksi, ja differentiaalinen yksityisyys asettaa tarkkuus‑yksityisyys‑kompromissin, joka on otettava huomioon eksplisiittisellä yksityisyysbudjetilla. Salaus suojaa tietoja siirrossa tai tallennuksessa; se ei sinänsä estä mallin perusteella tehtäviä päätelmiä.
Ei‑IID‑data ja mallin laatu
Asiakkaiden data harvoin on riippumatonta ja identtisesti jakautunutta. Näppäimistömalli näkee jokaisen käyttäjän sanaston; sairaalat palvelevat erilaisia väestöryhmiä; tehtaat käyttävät erilaista laitteistoa. Nämä erot voivat hidastaa konvergenssia ja piilottaa heikkoa suorituskykyä pienille asiakasryhmille.
Arvioinnin tulisi sisältää globaalit mittarit, asiakaskohtaiset tai koontijoukon jakaumat, kalibrointi ja vikaanalyysi. Keskitetty testijoukko voi olla kätevä, mutta riittämätön. Tämä yhdistää federatiivisen oppimisen koneoppimiseen datan laatuun ja rakenteisen ja rakenteettoman datan hallintaan.
Uhat ja operatiiviset kontrollit
Haitalliset asiakkaat voivat lähettää myrkyllisiä päivityksiä, sybil‑asiakkaat voivat vääristää aggregaatiota, ja vaarantunut palvelin voi levittää kohdennetun mallin. Puolustuskeinoja ovat todennettu rekisteröinti, poikkeavuuksien havaitseminen, kestävä aggregointi, päivitysten validointi, nopeusrajoitukset ja toistettavissa oleva ohjelmistotodistus, kun se on käytännöllistä.
Federatiivinen oppiminen kuuluu laajempaan kyberturvallisuus-ohjelmaan. Tiimien tulisi dokumentoida, kuka hallitsee koordinaattoria, mitä metadataa kerätään, miten osallistujat voivat poistua, miten mallit peruutetaan ja mitä tapahtuu, kun yksityisyys‑ tai laatutestit epäonnistuvat.
Federatiivinen optimointi ja datan heterogeenisuus
Federatiivinen oppiminen lähettää mallin tai päivitystehtävän osallistuville asiakkaille, kouluttaa paikallisesti ja aggregoi päivitykset keskittämättä raakiesimerkkejä. Federatiivisessa keskiarvossa valitut asiakkaat suorittavat useita paikallisia optimointiaskeleita ja palvelin laskee painotetun keskiarvon, yleensä esimerkkimäärän perusteella. Viestintäkierrokset, paikalliset epochit, valinta ja oppimisnopeudet tasapainottavat kaistanleveyttä konvergenssin kanssa. Laitteiden välinen asetus sisältää monia epäluotettavia puhelimia tai antureita; silo‑asetus sisältää vähemmän organisaatioita, joilla on vahvempi laskentateho, identiteetti ja hallinto.
Asiakkaiden data on yleensä ei‑itsenäistä ja epätasaista: käyttäjät eroavat käyttäytymisessä, luokkajakaumassa, volyymissa ja saatavuudessa. Paikallinen koulutus voi harhautua yhteensopimattomiin suuntiin, tehden yksinkertaisesta keskiarvosta epävakaan tai suosivan aktiivisia suurivolyymisia asiakkaita. Algoritmit voivat käyttää proksimaalisia termejä, adaptiivista palvelinoptimointia, klusterointia, personointia tai kontrollivariaatteja. Arvioinnissa tulisi raportoida globaali ja asiakaskohtainen suorituskyky, häntäasiakkaat, osallistumistiheys, konvergenssi, viestintä ja energia. Hyvä keskiarvo voi piilottaa, että pienet tai harvinaiset asiakaspopulaatiot saavat heikomman mallin.
Yksityisyys, turvallisuus ja järjestelmäsuunnittelu
Datan pitäminen paikallisena ei sinänsä takaa yksityisyyttä. Gradientit ja päivitykset voivat vuotaa jäsenyyttä tai ominaisuuksia, kun taas lopullinen malli voi muistaa esimerkkejä. Turvallinen aggregointi piilottaa yksittäiset päivitykset palvelimelta, ja differentiaalinen yksityisyys rajoittaa informaatiomäärää leikkaamalla ja lisäämällä kohinaa, mutta molemmat vaikuttavat hyötyyn ja operatiiviseen monimutkaisuuteen. Määritä uhkamalli, yksityisyysyksikkö, budjetti ja luotetut komponentit. Salauksen käyttö siirrossa on välttämätöntä, mutta se ei estä haitallista asiakasta, myrkyllistä päivitystä, vaarantunutta koordinaattoria tai päätelmähyökkäystä.
Puolustuskeinoja ovat todennetut asiakkaat, kestävä aggregointi, poikkeavuustarkastukset, päivitysrajat, turvalliset suojat joissakin suunnitelmissa ja validointi puhtaalla datalla. Sybil‑hyökkääjät voivat luoda monia asiakkaita; takaportit voivat selviytyä keskiarvosta; epäilyttävien päivitysten pudottaminen voi myös sulkea pois laillisen harvinaisen käyttäytymisen. Versioi asiakaskoodi, tue keskeytettyjä kierroksia, estä toisto, ja suunnittele viivästyjille ja laitteiden rajoitteille. Suostumus, säilytys, alueelliset säännöt ja poisto koskevat edelleen paikallista dataa ja johdettuja päivityksiä.
Käyttöönotto- ja hallintoesimerkki
Mobiilinäppäimistö voi kouluttaa seuraavan sanan parannuksia paikallisesti, mutta käyttöönotto tulisi kohdistaa laitteiden kyvykkyyden ja suostumuksen perusteella, kerätä leikattuja suojattuja päivityksiä ja verrata jäädytettyyn perusmalliin. Validoi kieli‑ ja murre‑suorituskyky, akku, datankäyttö ja muistinmuistamisen riski ennen julkaisua. Asiakkaat tarvitsevat allekirjoitetut koulutustehtävät ja mallipäivitykset; palvelin tarvitsee auditoitavan kierroskonfiguraation ja peruutuksen. Federatiivinen oppiminen on arkkitehtuuri hajautetulle oppimiselle rajoitteiden alla, ei korvaus edustavalle datalle, yksityisyysinsinööritieteelle tai vastuullisuudelle.
Käytännön esimerkki: federatiivinen oppiminen sairaaloissa
Sairaalat kouluttavat jaettua kuvanlaatumallia ilman skannausten yhdistämistä. Yhteinen protokolla määrittelee laitemetadatan, merkinnät, esikäsittelyn, asiakasilmukaisuuden, paikalliset epochit, leikkaukset ja turvallisen aggregoinnin. Toimipaikat säilyttävät potilastiedot ja lähettävät suojattuja päivityksiä, kun koordinaattori arvioi jokaisen kierroksen paikallisilla pidätetyillä testijoukoilla. Tulokset raportoivat toimipaikkakohtaisen ja häntä‑suorituskyvyn, eivät pelkästään volyymipainotettua keskiarvoa, koska pienet sairaalat ja laitteistotyypit muuten voitaisiin jättää huomiotta.
Uhkamalli kattaa haitalliset päivitykset, jäsenyyden vuotamisen, vaarantuneet asiakkaat ja koordinaattorin pääsyn. Differentiaalinen yksityisyys konfiguroidaan dokumentoidulla budjetilla ja testatulla hyödyllisyydellä. Malli‑ ja tehtäväpaketit allekirjoitetaan; toimipaikat voivat vetäytyä ja päivitykset ovat auditoitavissa. Myrkyllinen tai epävakaa kierros ei korvaa käyttöönotettua mallia automaattisesti. Projekti säilyttää paikalliset perusmallit ja kliinisen tarkastelun, ja se pitää federatiivista arkkitehtuuria yhtenä yksityisyyskontrollina laajemmissa suostumus‑, turvallisuus‑ ja hallintovelvoitteissa.
Toteutustodisteet ja operatiivinen valmius
Tuotantopäätös vaatii enemmän kuin onnistuneen demonstraation. Määritä kohdekäyttäjät, käyttöympäristö, syötteet, tulosteet, riippuvuudet, omistaja ja jokaisen tärkeän vian seuraukset. Perusta toistettavissa oleva peruslinja ja versioitu arviointijoukko ennen hienosäätöä. Testaa tavalliset tapaukset, reunatilat, virheelliset tai puuttuvat syötteet, jakauman siirtymä, riippuvuuksien katkos, väärinkäyttö ja ne ryhmät tai ympäristöt, jotka todennäköisesti jäävät alipalveluiksi. Mittaa tehtävän laatu yhdessä kalibroinnin tai epävarmuuden, viiveen, läpimenon, resurssikustannusten, saavutettavuuden, yksityisyyden ja turvallisuuden kanssa. Tallenna jokainen muunnos ja kynnys, jotta itsenäinen tarkastaja voi toistaa tuloksen ja erottaa todisteet houkuttelevasta prototyypistä.
Ennen lanseerausta nimeä vastuuhenkilö julkaisuun, poikkeuksiin, muutoksiin, peruutuksiin ja elinkaaren lopettamiseen. Käytä vaiheistettua käyttöönottoa, säilytä turvallinen varmistus ja varmista valvonta tahallisesti injektoiduilla vioilla. Operatiivisen telemetrian tulisi paljastaa syötteen laatu, tulosteen käyttäytyminen, mallin tai säännön versio, riippuvuuksien tila, ihmisen ohitukset ja vahvistetut tulokset keräämättä tarpeetonta arkaluonteista dataa. Määritä hälytyskynnykset ja vastaavan omistajan, tarkastele todellista näyttöä käyttöönoton jälkeen sen sijaan, että oletetaan offline‑suorituskyvyn jatkuvan. Arvioi uudelleen aina kun datalähteet, käyttäjät, mallit, toimittajat, politiikat, laitteisto tai tavoitteet muuttuvat. Ylläpidetty järjestelmä tarvitsee myös dokumentoidun palautumisen, tapahtumien oppimisen, poistamisen ja säilyttämisen menettelyt, sekä selkeän pisteen, jossa se tulee poistaa tai korvata.
Usein kysytyt kysymykset
Takaaako federatiivinen oppiminen, että yksityisiä tietoja ei voi vuotaa?
Ei. Se vähentää raakadataliikennettä, mutta päivitykset ja lopulliset mallit voivat silti paljastaa tietoja. Yksityisyys edellyttää uhkamallia sekä lisätekniikoita ja -organisatorisia kontrollia.
Milloin keskitetty koulutus on yksinkertaisempaa?
Kun data voidaan laillisesti ja turvallisesti keskittää, keskitetty koulutus on usein helpompi debugata, toistaa ja valvoa. Federatiivinen oppiminen on perusteltua, kun jakelu on todellinen vaatimus, eikä pelkkä brändäystavoite.
Ensisijaiset lähteet












