
Ajatusjohtajat
Kolme yksityisyyttä suojaavaa koneoppimisen tekniikkaa, jotka ratkaisevat tämän vuosikymmenen tärkeimmän ongelman

 Lisää Unite.AI suosikkilähteisiisi Google-palvelussa
Tohtori Amogh Tarcar, koneoppimisen ja tekoälyntutkija, Persistent Systems. (PERSISTENT.BO )
Yksityisyyden suoja, asiantuntijoiden mukaan useilla eri aloilla, tulee olemaan tämän vuosikymmenen tärkein asia. Tämä on erityisen totta koneoppimiselle (ML), jossa algoritmeja syötetään valtavilla määrillä dataa.
Perinteisesti, ML-mallinnusmenetelmät ovat riippuvaisia datan keskittämisestä useista lähteistä yhteen datakeskukseen. Kaikkihan ML-mallit ovat voimakkaimmillaan, kun niillä on pääsy valtaviin määriin dataa. Kuitenkin, tämän menetelmän yhteydessä on joukko yksityisyyden haasteita. Erilaisten datojen kerääminen useista lähteistä on vähemmän mahdollista tänään johtuen sääntelyhuolenaiheita, kuten HIPAA, GDPR ja CCPA. Lisäksi, datan keskittäminen lisää datan väärinkäytön ja tietoturvariskien laajuutta ja mittaa datavuotojen muodossa.
Näiden haasteiden voittamiseksi on kehitetty useita yksityisyyttä suojaavan koneoppimisen (PPML) pilareita, joissa on tiettyjä tekniikoita, jotka vähentävät yksityisyyden riskiä ja varmistavat, että data pysyy järkevän turvallisena. Tässä on muutamia tärkeimmistä:
1. Hajasijoitettu oppiminen
Hajasijoitettu oppiminen on ML-koulutusmenetelmä, joka kääntää datan keräämisen ongelman päälaelleen. Sen sijaan, että kerättäisiin data yhden ML-mallin luomiseksi, hajasijoitettu oppiminen kerää itse ML-malleja. Tämä varmistaa, että data ei poistu sen sijaintipaikasta, ja se mahdollistaa useiden osapuolten yhteistyön ja yhteisen ML-mallin rakentamisen ilman herkillä tiedoilla varustettujen tietojen suoraa jakamista.
Toimii seuraavasti. Aloitat perus-ML-mallilla, joka jaetaan jokaiselle asiakasnodille. Nodit suorittavat paikallisen koulutuksen tästä mallista käyttäen omaa dataansa. Mallipäivitykset jaetaan jaksollisesti koordinaattorinodille, joka prosessoi nämä päivitykset ja yhdistää ne yhteen uudeksi globaaliksi malliksi. Tällä tavoin saat eri tietojoukkojen tiedot ilman, että nämä tietojoukot on jaettu.

Lähde: Persistent Systems
Terveydenhuollon kontekstissa tämä on erittäin voimakas ja yksityisyyttä suojaava työkalu potilastietojen turvaamiseksi tutkijoiden antaessa viisautta joukolta. Datan keskittämättömyys luo yhden ylimäisen turvakerroksen. Kuitenkin, mallit ja mallipäivitykset edustavat edelleen turvallisuusriskiä, jos ne jätetään haavoittuviksi.
2. Differensiaalinen yksityisyys
ML-mallit ovat usein jäsenyyden inference -hyökkäysten kohteita. Oletetaan, että jaat terveydenhuollon datasi sairaalan kanssa auttaaksesi kehittämään syöpärokotetta. Sairaala pitää datasi turvassa, mutta käyttää hajasijoitettua oppimista kouluttamaan julkisesti saatavilla olevaa ML-mallia. Muutaman kuukauden kuluttua, hakkerit käyttävät jäsenyyden inference -hyökkäystä määrittämään, käytettiinkö datasi mallin koulutuksessa vai ei. He antavat sitten nämä oivallukset vakuutusyhtiölle, joka voi perustaa riskin syövän sairastumiseen ja korottaa vakuutusmaksujasi.
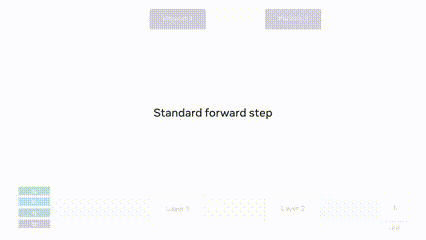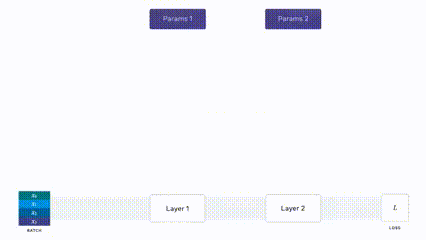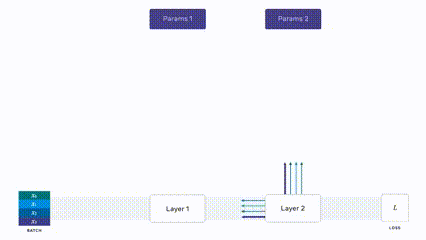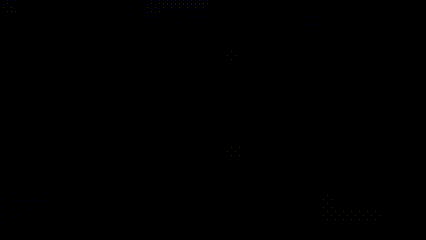
Differensiaalinen yksityisyys varmistaa, että vihollisen hyökkäykset ML-malleja vastaan eivät voi tunnistaa tiettyjä datakohtia, joita käytetään koulutuksessa, mikä vähentää riskiä altistaa herkkää koulutusdataa koneoppimisessa. Tämä tehdään soveltamalla “tilastollista melua” häikäisemään dataa tai koneoppimismallin parametrejä koulutuksen aikana, mikä tekee vaikeaksi suorittaa hyökkäyksiä ja määrittää, käytettiinkö tietyn yksilön dataa mallin koulutukseen.
Esimerkiksi Facebook julkaisi äskettäin Opacus, korkean nopeuden kirjaston PyTorch-mallien kouluttamiseen differensiaalisen yksityisyyden avulla. Gif alla osoittaa, miten se käyttää melua peittämään dataa.
Lähde: Facebookin Opacus-blogi
Tämä melu on hallittavissa Epsilon-nimisellä parametrilla. Jos Epsilon-arvo on matala, mallilla on täydellinen datan yksityisyys, mutta huono käytettävyys ja tarkkuus. Vastavuoroisesti, jos sinulla on korkea Epsilon-arvo, datan yksityisyys laskee, kun tarkkuutesi nousee. Temppu on löytää tasapaino, jotta voidaan optimoida molempia.
3. Homomorfinen salaus
Perinteinen salaus on yleensä yhteensopimaton koneoppimisen kanssa, koska kun data on salattu, se ei voi enää ymmärtää ML-algoritmi. Homomorfisessa salauksessa on kuitenkin erityinen salausjärjestelmä, joka sallii tehdä tiettyjä laskelmia.

Lähde: OpenMined
Tämän voima on, että koulutus voidaan suorittaa täysin salatussa tilassa. Se suojelee sekä dataomistajia että mallinomistajia. Mallinomistaja voi suorittaa inference-salattuja tietoja ilman, että näkee niitä tai väärinkäyttää niitä.
Kun sovelletaan hajasijoitettuun oppimiseen, mallipäivitysten yhdistäminen voidaan suorittaa turvallisesti, koska ne tapahtuvat täysin salatussa ympäristössä, mikä vähentää jäsenyyden inference -hyökkäyksen riskiä.
Yksityisyyden vuosikymmen
Kun astumme vuoteen 2021, yksityisyyttä suojaava koneoppiminen on nouseva ala, jossa tutkimus on erittäin aktiivista. Jos edellinen vuosikymmen oli datan avaamisesta, tämä vuosikymmen tulee olemaan ML-mallien avaamisesta yksityisyyden suojaamisen kautta hajasijoitettua oppimista, differensiaalista yksityisyyttä ja homomorfista salauksen avulla. Nämä tarjoavat lupaavan uuden tavan edistää koneoppimisen ratkaisuja yksityisyyttä suojaavalla tavalla.


