
Fundamentos de la IA
¿Qué es el aprendizaje por refuerzo a partir de la retroalimentación humana (RLHF)?

 Añade Unite.AI a tus fuentes preferidas en Google
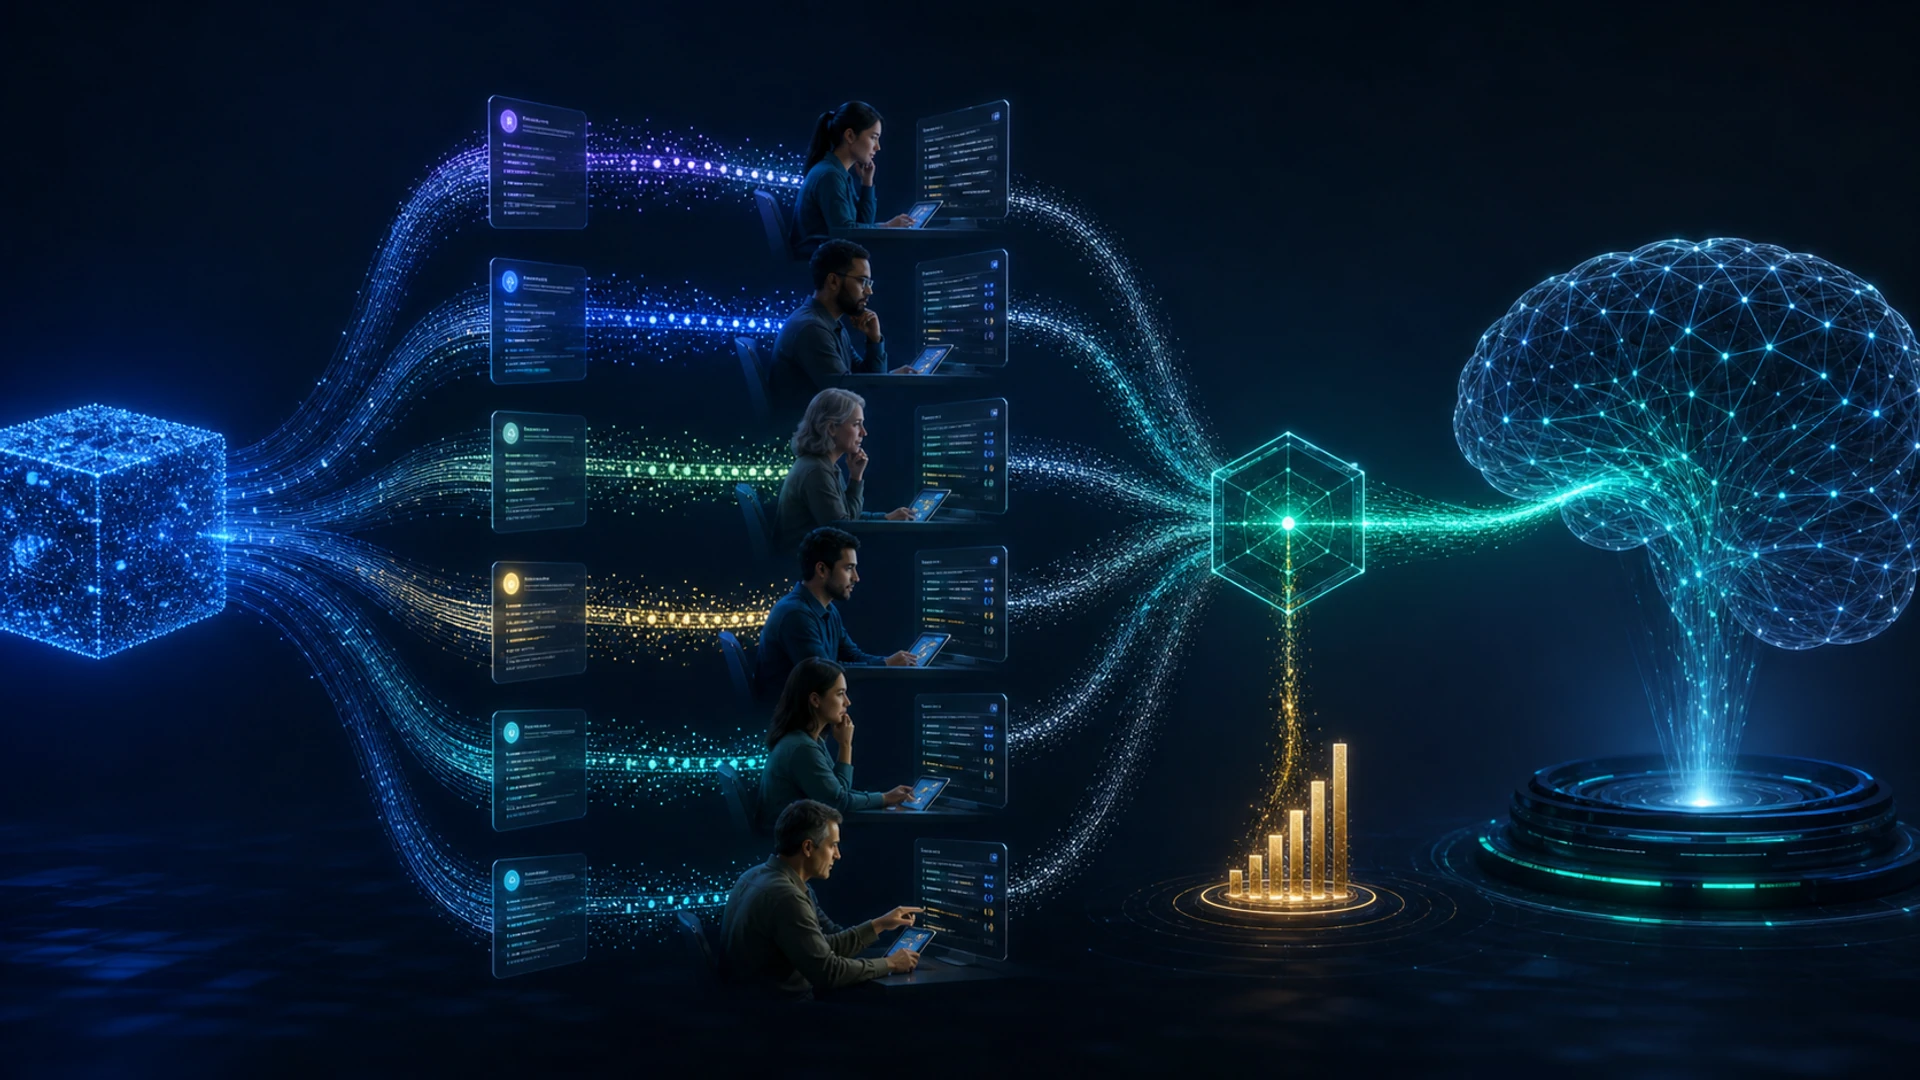
El aprendizaje por refuerzo a partir de la retroalimentación humana (RLHF) es una familia de métodos que utiliza juicios humanos para ayudar a optimizar un modelo cuando el comportamiento deseado es difícil de especificar mediante una recompensa automática simple. Para los modelos de lenguaje, las personas suelen comparar respuestas candidatas y un modelo de preferencia aprendido convierte esas comparaciones en una señal de entrenamiento.
RLHF puede hacer que un modelo preentrenado sea más útil o esté mejor alineado con una política escrita, pero no garantiza veracidad ni alineación con todos los usuarios. El resultado depende de quién suministra la retroalimentación, cómo se muestrean los prompts, qué puede representar el modelo de recompensa y cómo se restringe la optimización.
Puntos clave
- RLHF suele seguir al preentrenamiento y al ajuste supervisado por instrucciones.
- Las preferencias por pares entrenan un modelo de recompensa o de preferencia; la optimización de la política luego favorece las salidas con puntuaciones más altas.
- El hackeo de recompensas, el desacuerdo entre anotadores, el cambio de distribución y la sobreoptimización siguen siendo riesgos importantes.
- Evalúe la política final directamente en cuanto a calidad de la tarea, seguridad, calibración y efectos en subgrupos.
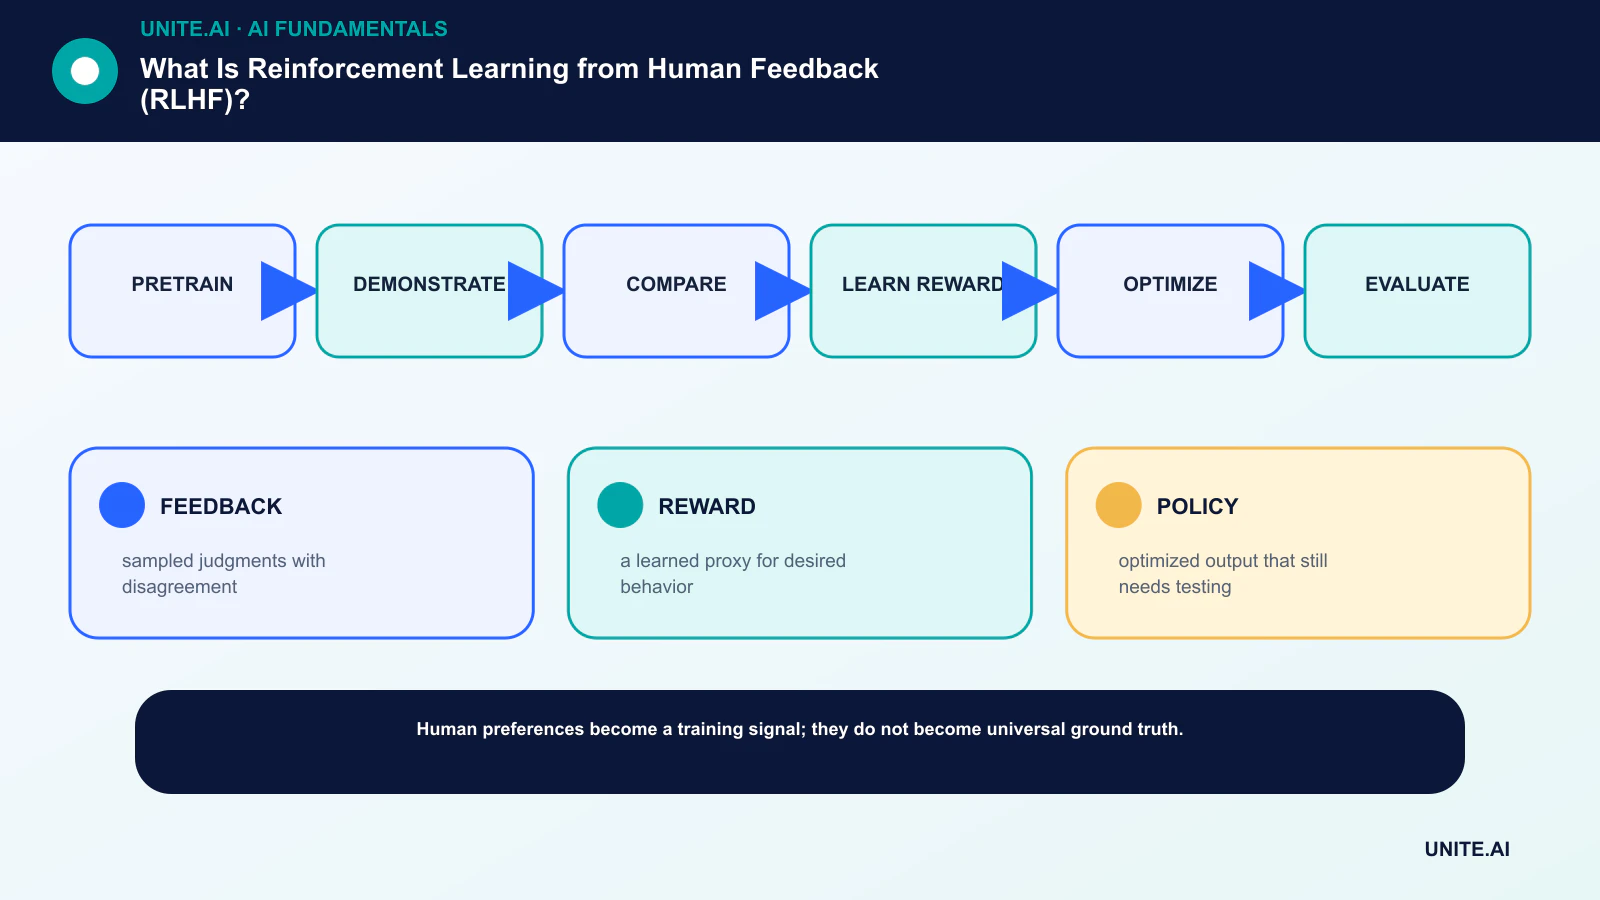
El pipeline típico de RLHF
Un modelo de lenguaje primero aprende una amplia estructura estadística mediante el preentrenamiento. Luego, el ajuste fino supervisado utiliza demostraciones de respuestas deseadas. Para la recopilación de preferencias, los anotadores clasifican o eligen entre salidas para el mismo prompt.
Un modelo de recompensa aprende a predecir esas comparaciones. Un algoritmo de aprendizaje por refuerzo, como PPO, puede optimizar el modelo de lenguaje contra esa recompensa aprendida mientras una penalización lo desalienta de desviarse demasiado de la política de referencia.
La retroalimentación es una medida, no una verdad absoluta
Los anotadores pueden discrepar porque las instrucciones son ambiguas, la experiencia difiere o los valores realmente entran en conflicto. La posición, la verbosidad, la confianza y el estilo pueden sesgar las preferencias. Un programa de alta calidad entrena a los evaluadores, mide el acuerdo, audita ejemplos y preserva la incertidumbre.
El muestreo también es importante. Si el conjunto de preferencias excluye idiomas difíciles, dominios o daños, el modelo de recompensa no puede supervisarlos de manera fiable. La disciplina de ciencia de datos es tan importante como el optimizador.
Modos de falla
La política puede explotar debilidades en la recompensa aprendida, produciendo salidas que obtienen una buena puntuación sin satisfacer la intención subyacente. Una optimización excesiva puede reducir la diversidad, amplificar un estilo preferido o hacer que el modelo sea complacientemente confiado.
El propio modelo de recompensa puede fallar fuera de su distribución de entrenamiento. Los equipos deben probar prompts adversarios, tareas fácticas, límites de rechazo, calibración y comportamiento a diferentes intensidades de optimización, en lugar de confiar en una única tasa de éxito agregada de preferencias.
Alternativas y complementos
La Optimización Directa de Preferencias aprende de pares de preferencias sin ajustar una política separada mediante un bucle de aprendizaje por refuerzo en línea. El muestreo por rechazo, el ajuste fino supervisado por preferencias, la retroalimentación basada en reglas y la supervisión de procesos ofrecen otros compromisos.
Ningún método elimina la necesidad de controles a nivel de prompt, recuperación, herramienta y aplicación. El post‑entrenamiento moldea el comportamiento; los sistemas desplegados aún requieren evidencia fundamentada, permisos, monitoreo y escalamiento humano.
Cómo se entrenan los modelos de preferencia
Para un prompt x y dos respuestas y₁ y y₂, un modelo de preferencia asigna puntuaciones escalares y se entrena de modo que la respuesta preferida reciba la puntuación más alta. Una pérdida común se basa en la probabilidad de que una puntuación supere a la otra. Esto convierte numerosos juicios por pares en una función que puede puntuar nuevas salidas generadas.
El modelo aprende cualquier señal que prediga las elecciones recopiladas. Si los evaluadores prefieren prosa confiada, respuestas más largas, normas culturales particulares o puntos de vista familiares, esas correlaciones pueden convertirse en características de recompensa. Instrucciones equilibradas, contraejemplos, revisión experta y auditorías de preferencias superficiales reducen, pero no eliminan, el problema.
Los datos de preferencia pueden incluir empates, clasificaciones, críticas, etiquetas escalares o demostraciones. La selección de pares es importante: las comparaciones entre respuestas evidentemente diferentes enseñan menos sobre límites sutiles de calidad, mientras que solo los pares difíciles pueden volver inestable el entrenamiento. El muestreo activo puede enfocarse en desacuerdos informativos, pero podría alterar la distribución de los datos.
Optimización de la política y regularización
El RLHF basado en PPO muestra respuestas de la política actual, las puntúa con el modelo de recompensa y actualiza la política para aumentar la recompensa esperada. Una penalización Kullback–Leibler o una restricción relacionada mantiene la política cerca de la referencia supervisada, limitando la deriva destructiva y desalentando la explotación de debilidades estrechas del modelo de recompensa.
La intensidad de la optimización es una decisión del producto. Muy poca deja el comportamiento deseado sin cambios; demasiado puede producir hackeo de recompensas, frases repetitivas, adulación o reducción de la diversidad. Trace la calidad y métricas de seguridad frente a la recompensa y divergencia durante todo el entrenamiento, en lugar de seleccionar un punto de control solo por la recompensa.
Los métodos de preferencia directa derivan un objetivo a partir de pares de preferencias y un modelo de referencia sin un bucle de RL en línea explícito. Pueden simplificar el entrenamiento, pero aún heredan la calidad de las preferencias, la cobertura y los supuestos de la política de referencia. La retroalimentación constitucional o generada por IA cambia quién suministra las etiquetas; no elimina la necesidad de validar valores y fallos con personas.
Evaluación y gobernanza de datos
Utilice comparaciones a ciegas, pruebas específicas de tareas, prompts adversarios, verificaciones de factualidad, precisión y exhaustividad de rechazos, y revisión por subgrupos. Separe a los evaluadores de los datos de entrenamiento siempre que sea posible. Una tasa de éxito contra un modelo anterior puede ocultar fallas absolutas cuando ambos candidatos son deficientes.
Documente la contratación de anotadores, compensación, experiencia, ubicación geográfica, idioma, instrucciones, exposición a contenido dañino, desacuerdos, adjudicación y controles de calidad. El trabajo de retroalimentación puede conllevar riesgos psicológicos, y las operaciones de datos responsables incluyen apoyo a los trabajadores y el derecho a rechazar tareas perturbadoras.
Después del despliegue, monitoree la deriva de preferencias y la sobregeneralización. Una política afinada para asistencia casual puede comportarse mal en contextos médicos o legales. Mantenga los límites de dominio, recuperación, permisos y escalamiento fuera de la suposición de RLHF, y vuelva a entrenar solo cuando nueva evidencia justifique el cambio.
Un pipeline concreto de entrenamiento y evaluación de RLHF
Un proyecto típico comienza con un modelo de lenguaje preentrenado y un conjunto de datos de instrucciones utilizado para el ajuste fino supervisado. Luego, los anotadores comparan respuestas candidatas bajo una rúbrica escrita que cubre corrección, relevancia, estilo, seguridad e incertidumbre. Las preferencias por pares entrenan un modelo de recompensa o optimizan directamente la política. El muestreo debe incluir tareas ordinarias, casos límite difíciles, prompts adversarios, múltiples idiomas y áreas donde los anotadores legítimamente discrepan.
La precisión del modelo de recompensa en comparaciones reservadas es necesaria pero no suficiente. La política optimizada puede explotar errores en la recompensa aprendida, volverse excesivamente verbosa, rechazar solicitudes inofensivas o perder capacidades. Rastree los benchmarks de tareas, la preferencia humana, la calibración, la seguridad, la diversidad y la divergencia respecto al modelo de referencia durante el entrenamiento. Recoja periódicamente comparaciones nuevas de la política cambiante para que los datos de preferencia cubran las salidas que el modelo realmente produce.
Documente quién proporcionó las preferencias, sus instrucciones, compensación, desacuerdos, controles de calidad y límites culturales o de dominio. Use revisores expertos donde los errores conllevan daño especializado. Realice pruebas de red‑team tanto al modelo de recompensa como a la política final, mantenga pruebas de regresión de comportamiento y despliegue por etapas. RLHF moldea el comportamiento según las preferencias medidas; no prueba la veracidad, elimina el sesgo ni resuelve el problema más amplio de especificar lo que un modelo debe hacer en cada contexto.
Lista de verificación para la implementación práctica
Convierta el concepto en un flujo de trabajo delimitado y verificable: preentrenar → demostrar → comparar → aprender recompensa → optimizar → evaluar. Asigne un responsable, documente los datos y dependencias, establezca una línea base simple, defina criterios de aceptación y de detención, pruebe fallos representativos y establezca monitoreo, retroceso y revisión antes de ampliar el alcance. Registre versiones y suposiciones para que otro equipo pueda reproducir el resultado y comprender qué cambió.
Antes del lanzamiento, realice una revisión de preparación documentada con las personas que construyen, operan, aseguran y son afectadas por el sistema. Pruebe casos normales, condiciones límite, fallos de dependencias y usos indebidos; preserve la evidencia y los riesgos no resueltos. Defina quién puede aprobar el lanzamiento, cambiar un umbral, anular una salida o detener la operación. Revise la decisión una vez que lleguen datos del mundo real, porque un piloto técnicamente exitoso no garantiza un rendimiento fiable a mayor escala.
- FEEDBACK: juicios muestreados con desacuerdo.
- REWARD: un proxy aprendido del comportamiento deseado.
- POLICY: salida optimizada que aún necesita pruebas.
Preguntas frecuentes
¿Es RLHF lo mismo que el ajuste fino?
RLHF es una forma de post‑entrenamiento que utiliza recompensas derivadas de preferencias. El ajuste fino supervisado entrena directamente sobre salidas objetivo; muchos pipelines utilizan ambos.
¿Hace RLHF que un modelo sea veraz?
Puede mejorar el comportamiento medido por el proceso de retroalimentación, pero un modelo aún puede estar equivocado, ser persuasivo o explotar estratégicamente la recompensa. La veracidad requiere una evaluación directa y una base sólida.
Referencias principales












