
Fundamentos de la IA
¿Qué es el aprendizaje federado?

 Añade Unite.AI a tus fuentes preferidas en Google
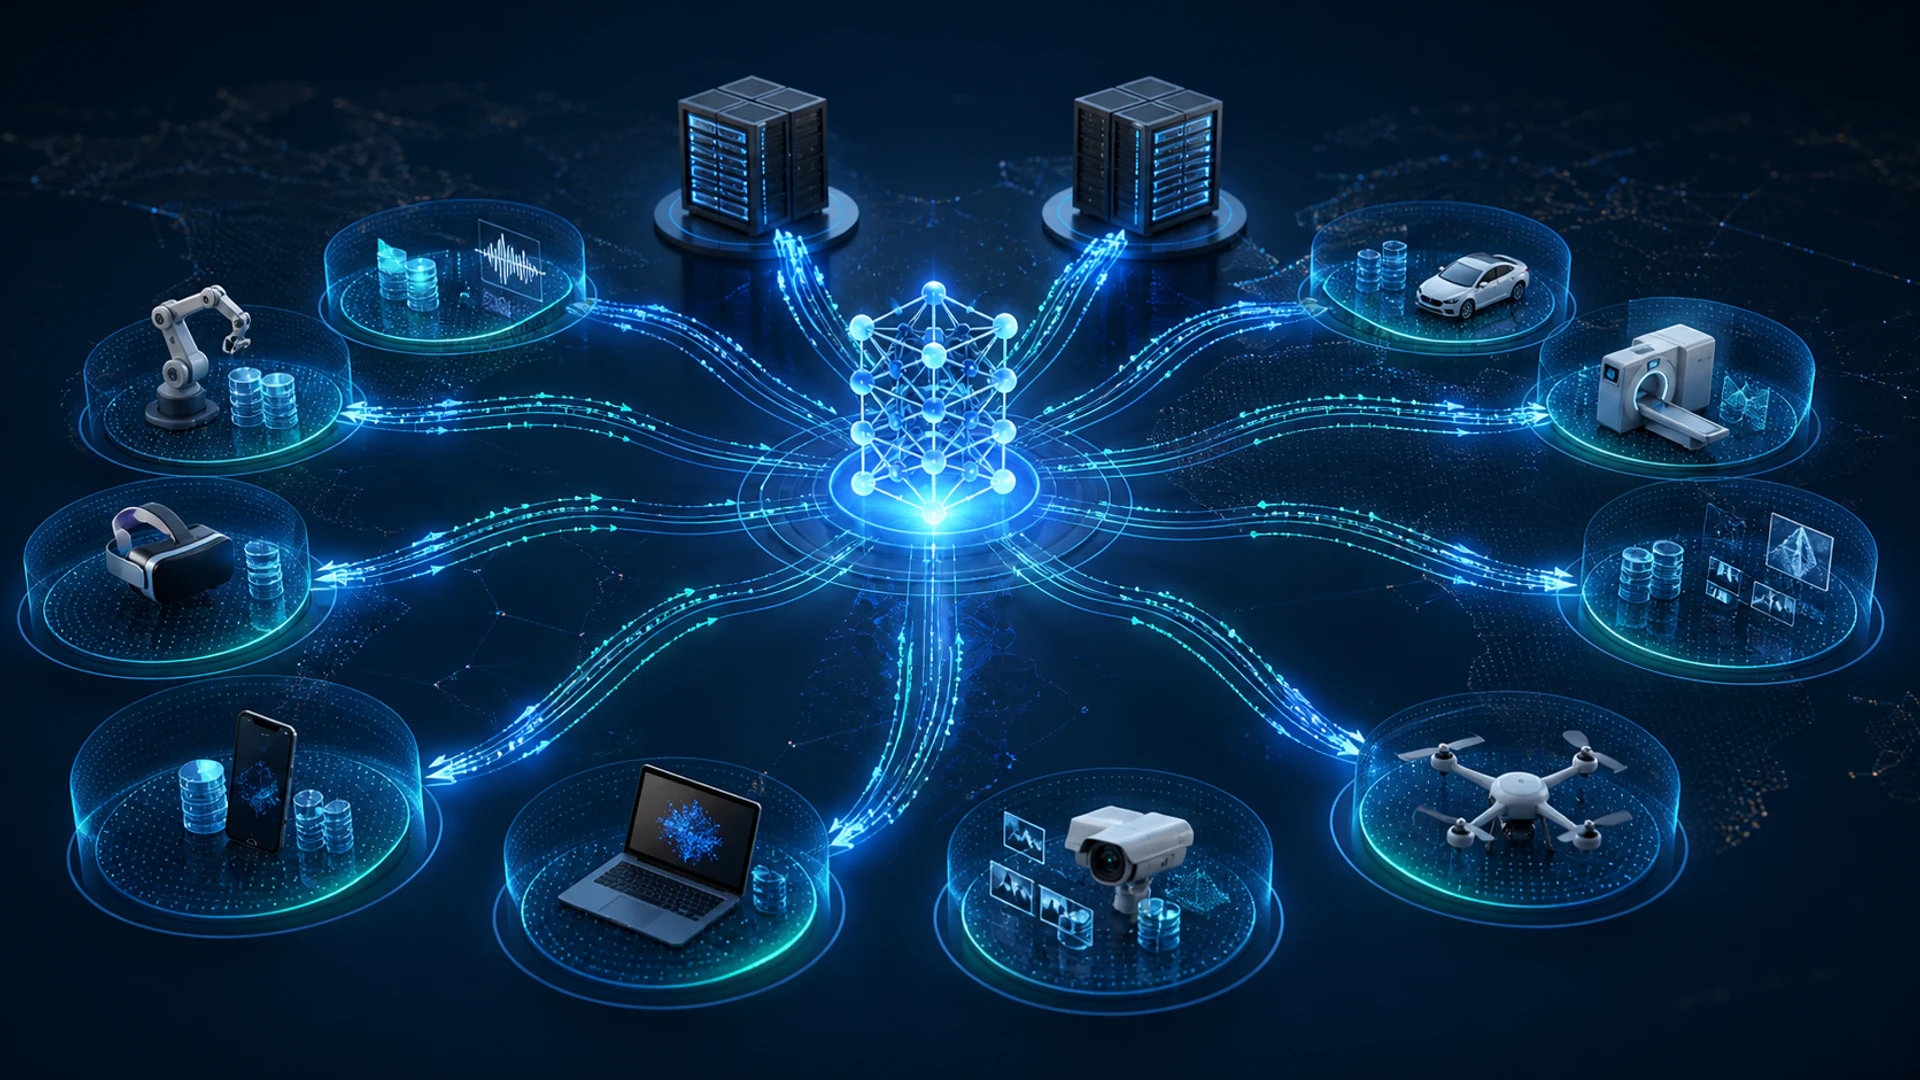
Aprendizaje federado entrena un modelo compartido en múltiples dispositivos u organizaciones mientras mantiene los datos de entrenamiento sin procesar de cada participante en local. Un coordinador distribuye los parámetros del modelo, los clientes calculan actualizaciones sobre sus propios registros y una fase de agregación combina esas actualizaciones.
Mantener los registros localmente es útil, pero no equivale a privacidad o seguridad. Las actualizaciones del modelo pueden filtrar información, los clientes comprometidos pueden envenenar el entrenamiento, y el coordinador aún necesita autenticación, seguridad de transporte, controles de acceso y un modelo de confianza definido.
Conclusiones clave
- El aprendizaje federado traslada la computación a los datos distribuidos; no traslada el conjunto de datos sin procesar a un único entrenador central.
- Los sistemas de dispositivos cruzados involucran muchos dispositivos intermitentes, mientras que los sistemas de silos cruzados involucran menos organizaciones, más estables.
- La agregación segura y la privacidad diferencial abordan riesgos diferentes y pueden combinarse.
- Los datos no IID, el ancho de banda limitado, la participación poco fiable y las actualizaciones maliciosas son restricciones de diseño fundamentales.
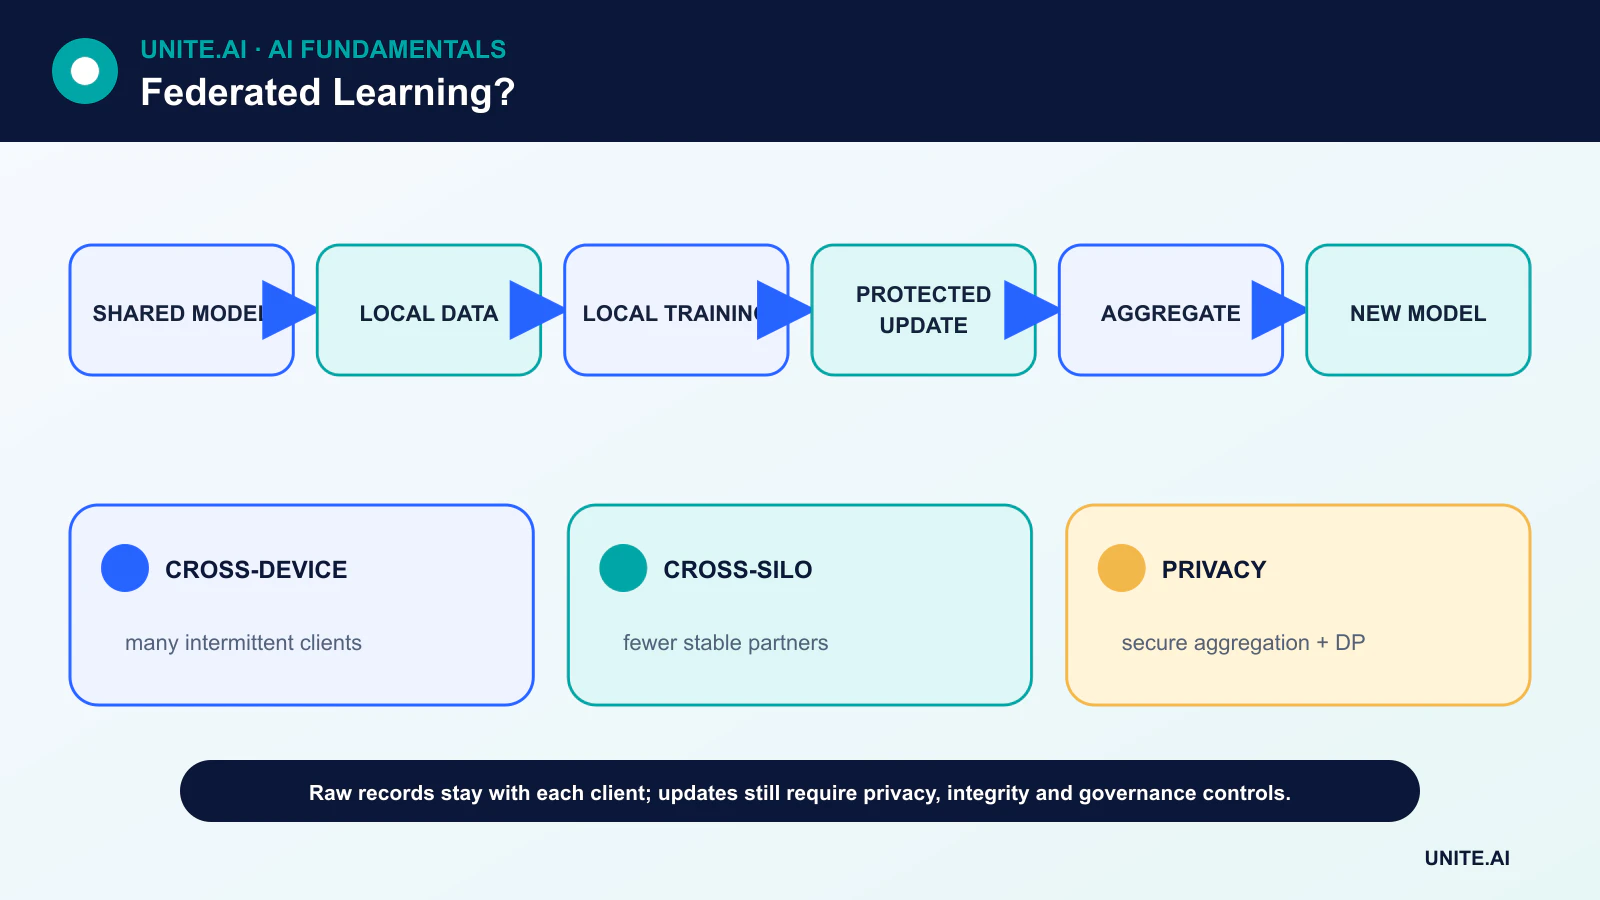
El ciclo de vida del promedio federado
Una ronda típica comienza cuando un coordinador selecciona clientes elegibles y envía el modelo actual. Cada cliente entrena localmente durante un número limitado de pasos, produciendo una actualización de parámetros o gradientes. El coordinador agrega las actualizaciones elegibles —a menudo con pesos basados en el recuento de ejemplos locales— y publica el nuevo modelo compartido.
Solo una fracción de los clientes puede participar en cada ronda. El protocolo debe tolerar conexiones caídas, incompatibilidades de versiones y dispositivos que no pueden entrenar mientras se cargan, están ocupados o están fuera de línea. La comunicación puede dominar la computación, por lo que la compresión de actualizaciones y la reducción de viajes de ida y vuelta suelen ser más importantes que la velocidad bruta del acelerador.
Dispositivos cruzados versus silos cruzados
El aprendizaje federado de dispositivos cruzados puede involucrar teléfonos, sensores o navegadores propiedad de muchas personas. Los clientes son numerosos, de confianza limitada y disponibles intermitentemente. El aprendizaje federado de silos cruzados normalmente conecta un conjunto más pequeño de hospitales, bancos o unidades de negocio con infraestructura estable y gobernanza contractual.
Los dos entornos requieren diferentes supuestos de identidad, auditoría y fallos. Un proyecto de silos cruzados puede negociar un esquema compartido y un proceso de validación; un servicio de dispositivos cruzados puede tener que manejar millones de versiones de software y conjuntos de datos locales muy desiguales.
Agregación segura, privacidad diferencial y cifrado
La agregación segura es un protocolo criptográfico que permite al servidor recuperar un agregado sin leer la actualización de cada cliente. La privacidad diferencial limita cuánto puede depender el resultado divulgado de un registro o participante específico al recortar contribuciones y añadir ruido calibrado.
Ningún mecanismo soluciona todos los riesgos. La agregación segura no hace que el agregado sea inofensivo, y la privacidad diferencial impone una compensación precisión‑privacidad que debe contabilizarse con un presupuesto de privacidad explícito. El cifrado protege los datos en tránsito o en almacenamiento; por sí solo no impide la inferencia a partir de un modelo.
Datos no IID y calidad del modelo
Los datos de los clientes rara vez son independientes e idénticamente distribuidos. Un modelo de teclado ve el vocabulario de cada persona; los hospitales atienden a poblaciones diferentes; las fábricas usan equipos distintos. Estas diferencias pueden ralentizar la convergencia y ocultar un rendimiento pobre para grupos pequeños de clientes.
La evaluación debe incluir métricas globales, distribuciones por cliente o cohorte, calibración y análisis de fallos. Un conjunto de prueba central puede ser conveniente pero insuficiente. Esto conecta el aprendizaje federado a la calidad de datos de aprendizaje automático y a la gobernanza de datos estructurados y no estructurados.
Amenazas y controles operacionales
Los clientes maliciosos pueden enviar actualizaciones envenenadas, los clientes sybil pueden distorsionar la agregación, y un servidor comprometido puede distribuir un modelo dirigido. Las defensas incluyen inscripción autenticada, detección de anomalías, agregación robusta, validación de actualizaciones, límites de velocidad y atestación reproducible de software cuando sea práctico.
El aprendizaje federado forma parte de un programa más amplio de ciberseguridad. Los equipos deben documentar quién controla el coordinador, qué metadatos se recopilan, cómo pueden salir los participantes, cómo se revierten los modelos y qué ocurre cuando fallan las pruebas de privacidad o calidad.
Optimización federada y heterogeneidad de datos
El aprendizaje federado envía un modelo o tarea de actualización a los clientes participantes, entrena localmente y agrega actualizaciones sin centralizar los ejemplos sin procesar. En el promedio federado, los clientes seleccionados ejecutan varios pasos de optimización local y el servidor calcula un promedio ponderado, comúnmente por recuento de ejemplos. Las rondas de comunicación, épocas locales, selección y tasas de aprendizaje negocian ancho de banda contra convergencia. Los entornos de dispositivos cruzados involucran muchos teléfonos o sensores poco fiables; los entornos de silos cruzados involucran menos organizaciones con mayor capacidad de cómputo, identidad y gobernanza.
Los datos del cliente suelen ser no independientes y desiguales: los usuarios difieren en comportamiento, distribución de etiquetas, volumen y disponibilidad. El entrenamiento local puede desviarse en direcciones incompatibles, haciendo que un promedio simple sea inestable o sesgado hacia clientes activos de alto volumen. Los algoritmos pueden usar términos proximales, optimización adaptativa del servidor, agrupamiento, personalización o variables de control. La evaluación debe reportar desempeño global y a nivel de cliente, clientes de cola, frecuencia de participación, convergencia, comunicación y energía. Un buen promedio puede ocultar que poblaciones pequeñas o raras de clientes reciben un modelo peor.
Privacidad, seguridad e ingeniería de sistemas
Mantener los datos localmente no garantiza por sí solo la privacidad. Los gradientes y actualizaciones pueden filtrar pertenencia o características, mientras que el modelo final puede memorizar ejemplos. La agregación segura oculta actualizaciones individuales del servidor, y la privacidad diferencial limita la contribución de información recortando y añadiendo ruido, pero ambas alteran la utilidad y la complejidad operativa. Declare el modelo de amenaza, la unidad de privacidad, el presupuesto y los componentes de confianza. El cifrado en tránsito es necesario pero no impide un cliente malicioso, una actualización envenenada, un coordinador comprometido o un ataque de inferencia.
Las defensas incluyen clientes autenticados, agregación robusta, verificaciones de anomalías, límites de actualización, enclaves seguros en algunos diseños y validación contra datos limpios. Los atacantes sybil pueden crear muchos clientes; las puertas traseras pueden sobrevivir al promedio; descartar actualizaciones sospechosas también puede excluir comportamientos raros legítimos. Versionar el código del cliente, soportar rondas interrumpidas, prevenir repeticiones y diseñar para rezagados y limitaciones de dispositivos. El consentimiento, la retención, las normativas regionales y la eliminación siguen aplicándose a los datos locales y a las actualizaciones derivadas.
Ejemplo de despliegue y gobernanza
Un teclado móvil puede entrenar mejoras de la siguiente palabra localmente, pero el despliegue debe usar una población elegible según la capacidad del dispositivo y el consentimiento, recopilar actualizaciones protegidas recortadas y compararlas con una línea base congelada. Valide el desempeño por idioma y dialecto, la batería, el uso de datos y el riesgo de memorización antes del lanzamiento. Los clientes necesitan tareas de entrenamiento y actualizaciones de modelo firmadas; el servidor necesita una configuración de ronda auditable y capacidad de reversión. El aprendizaje federado es una arquitectura para aprendizaje distribuido bajo restricciones, no un sustituto de datos representativos, ingeniería de privacidad o rendición de cuentas.
Ejemplo práctico: aprendizaje federado en hospitales
Los hospitales entrenan un modelo compartido de calidad de imagen sin agrupar escaneos. Un protocolo común define metadatos del dispositivo, etiquetas, preprocesamiento, elegibilidad de clientes, épocas locales, recorte y agregación segura. Los sitios conservan los datos de los pacientes y envían actualizaciones protegidas, mientras un coordinador evalúa cada ronda en conjuntos locales de validación. Los resultados informan el desempeño a nivel de sitio y de cola, no solo un promedio ponderado por volumen, porque los hospitales pequeños y los tipos de dispositivos podrían ser ignorados de otro modo.
El modelo de amenaza cubre actualizaciones maliciosas, filtrado de pertenencia, clientes comprometidos y acceso del coordinador. La privacidad diferencial se configura con un presupuesto documentado y se prueba su utilidad. Los paquetes de modelo y tarea están firmados; los sitios pueden retirarse y las actualizaciones son auditables. Una ronda envenenada o inestable no reemplaza automáticamente el modelo desplegado. El proyecto conserva líneas base locales y revisión clínica, y trata la arquitectura federada como un control de privacidad dentro de obligaciones más amplias de consentimiento, seguridad y gobernanza.
Evidencia de implementación y preparación operativa
Una decisión de producción necesita más que una demostración exitosa. Defina los usuarios previstos, el entorno operativo, entradas, salidas, dependencias, propietario y la consecuencia de cada falla importante. Establezca una línea base reproducible y un conjunto de evaluación versionado antes de afinar. Pruebe casos ordinarios, condiciones límite, entradas malformadas o ausentes, desplazamiento de distribución, fallos de dependencias, usos indebidos y los grupos o entornos más propensos a quedar desatendidos. Mida la calidad de la tarea junto con calibración o incertidumbre, latencia, rendimiento, costo de recursos, accesibilidad, privacidad y seguridad. Registre cada transformación y umbral para que un revisor independiente pueda reproducir el resultado y distinguir la evidencia de un prototipo atractivo.
Antes del lanzamiento, asigne autoridad para la liberación, excepciones, cambios, reversión y retiro. Use un despliegue por etapas, preserve una alternativa segura y verifique la monitorización con fallos inyectados deliberadamente. La telemetría operativa debe revelar la calidad de entrada, el comportamiento de salida, la versión del modelo o regla, la salud de dependencias, intervenciones humanas y resultados confirmados sin recopilar datos sensibles innecesarios. Defina umbrales de alerta y un responsable de respuesta, luego revise la evidencia del mundo real después del despliegue en lugar de asumir que el rendimiento offline persistirá. Reevalúe siempre que cambien fuentes de datos, usuarios, modelos, proveedores, políticas, hardware u objetivos. Un sistema mantenido también necesita procedimientos documentados de recuperación, aprendizaje de incidentes, eliminación y retención, y un punto claro en el que debe desactivarse o reemplazarse.
Preguntas frecuentes
¿Garantiza el aprendizaje federado que los datos privados no puedan filtrarse?
No. Reduce el movimiento de datos sin procesar, pero las actualizaciones y los modelos finales aún pueden revelar información. La privacidad requiere un modelo de amenaza y controles técnicos y organizacionales adicionales.
¿Cuándo es más simple el entrenamiento centralizado?
Cuando los datos pueden centralizarse de manera legal y segura, el entrenamiento centralizado suele ser más fácil de depurar, reproducir y monitorizar. El aprendizaje federado se justifica cuando la distribución es un requisito real, no solo un objetivo de marca.
Referencias principales












