Fundamentos de la IA
¿Qué es una NPU? Unidades de Procesamiento Neural explicadas

 Añade Unite.AI a tus fuentes preferidas en Google
Una unidad de procesamiento neuronal (NPU) es un acelerador especializado diseñado para ejecutar eficientemente operaciones comunes de redes neuronales. En teléfonos, PC, vehículos, cámaras y sistemas integrados, puede ejecutar cargas de trabajo de IA compatibles con menos energía o liberar la CPU y la GPU para otras tareas.
NPU es un término amplio de la industria más que una arquitectura universal. El rendimiento depende de los operadores admitidos, los formatos numéricos, la memoria, el compilador y el tiempo de ejecución, los límites térmicos y cuánto de una aplicación puede permanecer en el acelerador.
Puntos clave
- Las NPUs enfatizan operaciones de matrices, vectores y tensores con alto reúso de datos y bajo consumo.
- El pico de TOPS no es una referencia de aplicación de extremo a extremo y puede asumir una precisión o escasez específicas.
- Un modelo puede necesitar conversión, cuantización, partición del grafo y un plan de contingencia para operaciones no admitidas.
- Compare latencia, rendimiento, energía, memoria, calidad, privacidad y portabilidad con la carga de trabajo real.
Roles de CPU, GPU y NPU
Las CPU sobresalen en el flujo de control general y la amplia compatibilidad. Las GPU ofrecen un rendimiento paralelo programable y grandes ecosistemas de software. Las NPU especializan operaciones de tensores repetidas y pueden incluir memoria local, matrices de multiplicar‑acumular y flujos de datos optimizados para inferencia.
Los sistemas heterogéneos programan diferentes partes donde mejor encajan. Esto es importante para edge AI, donde la potencia sostenida y la capacidad de respuesta pueden ser más relevantes que el rendimiento máximo de los centros de datos.
Compilación y ejecución del modelo
Un grafo de framework se convierte en una representación intermedia, se optimiza, se cuantiza cuando corresponde y se compila para los operadores admitidos. El tiempo de ejecución puede particionar el grafo de modo que las capas no admitidas se ejecuten en la CPU o la GPU.
Las transferencias entre procesadores pueden anular las ventajas del acelerador. Las formas estáticas, la disposición, la precisión, el lote y la reutilización de memoria influyen en el rendimiento. Pruebe el artefacto compilado porque la calidad del modelo de deep-learning puede cambiar después de la conversión.
Entender los TOPS y las afirmaciones de eficiencia
Los TOPS informan billones de operaciones por segundo bajo supuestos definidos. Los proveedores pueden contar multiplicaciones y sumas por separado, usar precisión entera de bajo número de bits o asumir escasez. Un número mayor no garantiza una latencia menor para un modelo concreto.
Mida el arranque en frío y en caliente, la latencia por consulta, el rendimiento, la energía, la memoria máxima, el throttling térmico, el contexto o tamaño de imagen admitido, y la fracción del grafo acelerado. Use precisión y versiones de software equivalentes.
Compromisos de IA en el dispositivo
La ejecución local puede reducir la dependencia de la red y mantener las entradas crudas en el dispositivo, pero los modelos descargados, registros, copias de seguridad y recursos de respaldo en la nube siguen generando flujos de datos. La entrega segura de modelos y las actualizaciones de la plataforma siguen siendo necesarias.
Las NPUs pueden admitir aplicaciones de visión, audio, lenguaje y sensores, incluidos los flujos de trabajo adyacentes a TinyML. Los desarrolladores deben diseñar planes de contingencia elegantes y comunicar cuando el procesamiento sale del dispositivo.
Arquitectura de NPU y operaciones admitidas
Una NPU acelera operaciones de tensores mediante matrices de unidades de multiplicar‑acumular, memoria local, programación de flujo de datos y formatos numéricos especializados. Mantener pesos y activaciones cerca del cómputo reduce el costoso movimiento de datos. Los dispositivos reales difieren en soporte de operadores, jerarquía de memoria, precisión, escasez, programabilidad y cómo el trabajo se comparte con la CPU y la GPU.
El rendimiento máximo a menudo se anuncia en TOPS, pero los TOPS no especifican precisión, utilización, límites de memoria, cobertura de operadores ni latencia de extremo a extremo. Dos procesadores con el mismo número titular pueden comportarse de forma distinta con el mismo modelo. Evalúe el modelo compilado, tamaños de lote y secuencia realistas, preprocesamiento, transferencias y modo de energía.
Las NPUs son efectivas para cargas de trabajo neuronales admitidas como visión, habla, eliminación de ruido, efectos de fondo y modelos de lenguaje compactos. Los operadores no admitidos pueden recurrir a la CPU o GPU, creando transferencias y latencias impredecibles. Examine los informes del compilador y los rastros del tiempo de ejecución para confirmar la ubicación en lugar de asumir que todo el grafo usa el acelerador.
Conversión, cuantización y despliegue del modelo
El despliegue suele pasar de un framework de entrenamiento a través de exportación, optimización del grafo, cuantización, compilación del proveedor e integración en tiempo de ejecución. Las formas estáticas y los operadores comunes son los más fáciles de acelerar. El flujo de control dinámico, los kernels personalizados, tensores intermedios grandes y la normalización o patrones de atención no admitidos pueden requerir cambios en el grafo o ejecución híbrida.
Los formatos enteros y de precisión inferior reducen el tamaño del modelo, el ancho de banda, la energía y la latencia, pero los datos de calibración deben representar entradas reales. Compare la cuantización posterior al entrenamiento con la cuantización consciente durante el entrenamiento cuando la calidad es sensible. Evalúe el comportamiento por clase y en el peor caso, ya que la precisión promedio puede ocultar degradaciones en casos raros o críticos para la seguridad.
La inferencia en el dispositivo mejora la latencia, la operación offline y la privacidad al limitar la transferencia de datos, pero el dispositivo aún necesita modelos seguros, acceso a datos con control de permisos y mecanismos de actualización. Proteja los archivos de modelo cuando sea apropiado, firme las actualizaciones, divulgue el recurso a la nube y asegure que la telemetría no vuelva a introducir la exposición a la privacidad que la arquitectura local pretendía reducir.
Evaluación del rendimiento y compromisos a nivel de sistema
Mida la latencia de arranque en frío y en estado estable, el rendimiento, la energía por inferencia, la memoria, el comportamiento térmico, la precisión y el impacto en la batería. Las pruebas prolongadas revelan throttling que los benchmarks cortos no detectan. Incluya preprocesamiento y postprocesamiento porque el redimensionado, la tokenización, la decodificación o las copias de datos pueden dominar un acelerador de otro modo rápido.
La programación es un problema del sistema. La CPU gestiona la lógica de la aplicación, la GPU puede renderizar o ejecutar capas no admitidas, y la NPU ejecuta grafos compatibles. Las cargas de trabajo concurrentes de cámara, audio, pantalla e IA compiten por el ancho de banda de memoria y la energía. Pruebe el escenario completo del usuario en lugar de un modelo aislado en una herramienta del proveedor.
La portabilidad sigue limitada entre compiladores y tiempos de ejecución. Prefiera representaciones de modelo estándar donde funcionen, aísle el código específico del proveedor detrás de interfaces, conserve salidas de referencia y mantenga la cobertura de pruebas en dispositivos. Elija hardware basado en cargas de trabajo validadas, soporte de software, horizonte de actualizaciones y costo total del sistema, no en una única especificación del acelerador.
Ejemplo práctico: despliegue de un modelo de visión en un portátil con NPU
Un equipo entrena un modelo de segmentación para efectos de fondo, lo exporta a un formato de intercambio admitido, sustituye los operadores no admitidos y calibra la cuantización entera con cámaras representativas, iluminación, tonos de piel, ropa y fondos. El compilador del proveedor informa qué nodos se ejecutan en la NPU y cuáles recae en un plan de contingencia. El equipo trata cualquier cruce de contingencia como un costo del sistema, porque las transferencias de tensores pueden dominar un kernel individual rápido.
Las pruebas de referencia miden el preprocesamiento de cámara, la ejecución del modelo, la composición, la memoria, el arranque en frío, la latencia en estado estable, la estabilidad de fotogramas, la energía y el throttling térmico durante una llamada de video real. Los resultados se comparan con las rutas de CPU y GPU con calidad de salida equivalente. La aplicación usa detección de capacidades y un plan de contingencia probado en lugar de asumir que el acelerador existe o que soporta el mismo grafo tras una actualización del controlador.
Las pruebas de lanzamiento cubren modelos de dispositivos, versiones del sistema operativo y controladores, cargas de trabajo concurrentes, modos de batería y entradas malformadas. Los paquetes de modelo están firmados y versionados; la telemetría registra rendimiento y fallos sin recopilar video innecesario. El producto explica cuándo el procesamiento se mantiene en el dispositivo y cuándo se utilizan funciones en la nube. La NPU se gana su lugar al mejorar la experiencia completa bajo restricciones realistas, no al lograr un benchmark aislado de TOPS o kernel.
Lista de verificación para implementación práctica
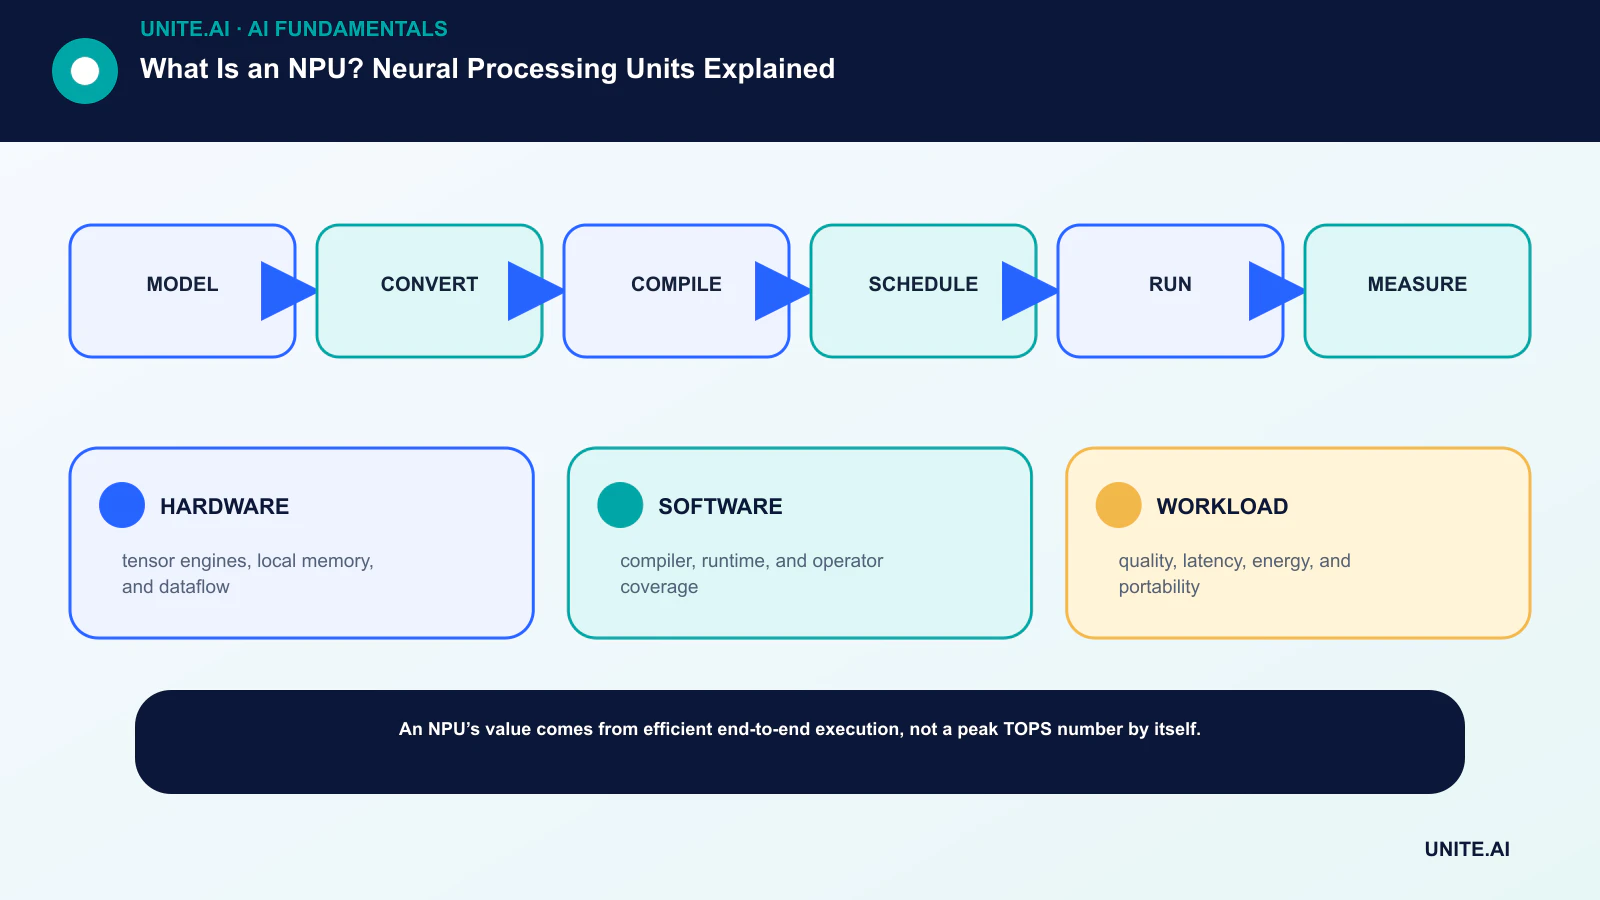
Convierta el concepto en un flujo de trabajo delimitado y comprobable: modelo → convertir → compilar → programar → ejecutar → medir. Asigne un responsable, documente los datos y dependencias, establezca una línea base simple, fije criterios de aceptación y de detención, pruebe fallas representativas y defina monitoreo, reversión y revisión antes de ampliar el alcance. Registre versiones y suposiciones para que otro equipo pueda reproducir el resultado y entender qué cambió.
Antes del lanzamiento, realice una revisión de preparación documentada con las personas que construyen, operan, aseguran y se ven afectadas por el sistema. Pruebe casos normales, condiciones límite, fallas de dependencias y usos indebidos; conserve la evidencia y los riesgos no resueltos. Defina quién puede aprobar el lanzamiento, cambiar un umbral, anular una salida o detener la operación. Revise la decisión cuando lleguen datos del mundo real, porque un piloto técnicamente exitoso no garantiza un rendimiento fiable a mayor escala.
- HARDWARE: motores de tensores, memoria local y flujo de datos.
- SOFTWARE: compilador, tiempo de ejecución y cobertura de operadores.
- CARGA DE TRABAJO: calidad, latencia, energía y portabilidad.
Preguntas frecuentes
¿Es una NPU más rápida que una GPU?
Depende del modelo, la precisión, el soporte de operadores, el tamaño del lote, el límite de energía y el software. Una NPU puede ser más eficiente para una carga de trabajo en el dispositivo admitida, mientras que una GPU es más rápida o más flexible en otros casos.
¿Una NPU mantiene todos los datos de IA privados?
No. Permite el procesamiento local, pero la aplicación aún puede enviar datos o resultados a servicios en la nube. La privacidad depende de la arquitectura completa y de la política.
Referencias principales