Modelos y plataformas de IA
¿Qué es la Ley de Moore y cómo afecta a la IA?

 Añade Unite.AI a tus fuentes preferidas en Google
La Ley de Moore es la observación histórica de que los circuitos integrados útiles económicamente tendían a ganar componentes a un ritmo exponencial. No es una ley de la física y no afirma que las computadoras se vuelvan automáticamente el doble de rápidas en un calendario fijo.
Para la IA, la densidad de transistores importa porque permite más unidades aritméticas, memoria e interconexiones. Pero el progreso práctico también depende de la arquitectura, la precisión numérica, el empaquetado, el ancho de banda de la memoria, los algoritmos, el software, la energía, el rendimiento de fabricación y la cantidad de datos útiles.
Conclusiones clave
- El artículo original de Moore de 1965 describió una tendencia económica e ingenieril, no una garantía física.
- El escalado de la frecuencia de reloj se desaceleró; las mejoras modernas provienen cada vez más del paralelismo y de aceleradores especializados.
- El rendimiento de la IA a menudo está limitado por el movimiento de memoria y la energía, no solo por la aritmética.
- Compare los sistemas con latencia, rendimiento, calidad, consumo energético y costo total a nivel de carga de trabajo, no con el número de transistores.
Lo que Moore observó realmente
Gordon Moore trazó el número de componentes en los circuitos integrados líderes y proyectó un continuo rápido crecimiento al costo mínimo por componente. Posteriormente, la cadencia se resumió comúnmente como una duplicación aproximadamente cada dos años, aunque las formulaciones y las magnitudes medidas han variado.
Las características más pequeñas pueden aumentar la densidad y reducir algunos costos de conmutación, pero la complejidad y la economía de la fabricación determinan si la tendencia sigue siendo útil. Los nombres de los nodos son etiquetas de marketing, por lo que no deben considerarse una comparación física directa entre fundiciones.
De núcleos más rápidos a la computación heterogénea
El escalado de voltaje al estilo Dennard permitió en su momento mayores frecuencias de reloj sin un crecimiento proporcional del consumo, pero esa relación se debilitó. Los diseñadores se orientaron hacia CPUs multinúcleo, GPUs, unidades tensoriales, chiplets, empaquetado avanzado y aceleradores específicos de dominio.
Esa heterogeneidad es central para el aprendizaje profundo. Las operaciones de matrices densas pueden ejecutarse eficientemente en hardware paralelo, mientras que las CPUs coordinan la lógica irregular y el movimiento de datos. El componente más rápido no ayuda si la tubería no puede mantenerlo abastecido.
Memoria, precisión y algoritmos
El entrenamiento y la inferencia mueven repetidamente pesos, activaciones y datos de caché a través de una jerarquía de memoria en chip y fuera del chip. El ancho de banda, la capacidad, la localidad y la comunicación pueden dominar el costo. Una precisión numérica menor y la cuantización reducen el movimiento cuando la calidad sigue siendo aceptable.
Las mejoras algorítmicas pueden reducir el cómputo necesario para alcanzar un resultado objetivo. Los modelos dispersos, los métodos de eficiencia de transformers, optimizadores mejores y datos de mayor calidad influyen en el progreso efectivo que experimentan los usuarios.
Cómo comparar hardware de IA
Las operaciones máximas por segundo son teóricas. Utilice un modelo representativo, tamaño de lote, longitud de secuencia, precisión, pila de software y umbral de calidad. Informe la latencia de extremo a extremo, el rendimiento, la energía, la huella de memoria, la utilización y el costo.
Los sistemas de borde pueden valorar la privacidad y el bajo consumo más que el rendimiento máximo; los centros de datos pueden priorizar el total de tokens o muestras por vatio. Edge AI muestra claramente por qué un único número titular no puede describir cada sistema útil.
Por qué cambió el escalado de semiconductores
Los primeros avances en circuitos integrados combinaron dispositivos más pequeños, mejor fabricación, menor costo por componente y mejoras de diseño. Durante años, la reducción de las dimensiones de los transistores también favoreció conmutaciones más rápidas y menor energía por operación. Finalmente, la fuga, los límites de voltaje, la densidad de calor, el retardo de interconexión y el costo de fabricación debilitaron la relación simple entre un nuevo nodo de proceso y núcleos de propósito general más rápidos.
El progreso moderno es, por tanto, multidimensional. Los dispositivos FinFET y gate‑all‑around mejoran el control electrostático; la litografía de ultravioleta extremo permite patrones más pequeños; los chiplets permiten a los diseñadores combinar dies fabricados con procesos diferentes; el empaquetado avanzado coloca el cómputo y la memoria más cerca. El rendimiento y el empaquetado determinan si un diseño técnicamente impresionante es económico a escala.
La desaceleración de un mecanismo de escalado no significa que el hardware haya dejado de mejorar. Significa que los arquitectos deben emplear los transistores de manera más deliberada. Las unidades especializadas intercambian flexibilidad por rendimiento o eficiencia en cargas de trabajo seleccionadas, mientras que cachés e interconexiones más grandes intentan mantener esas unidades abastecidas.
Cómo las cargas de trabajo de IA tensionan el hardware
El entrenamiento alterna cálculo directo, retropropagación, actualizaciones del optimizador y comunicación entre aceleradores. La inferencia varía desde puntuación por lotes hasta generación interactiva de tokens. La multiplicación de matrices es importante, pero los embeddings, la normalización, las funciones de activación, la atención, el enrutamiento, el acceso a caché y la orquestación del host también contribuyen al rendimiento real.
La intensidad aritmética — la cantidad de cálculo realizado por byte movido — ayuda a explicar si una carga de trabajo está limitada por el cómputo o por el ancho de banda. Los tamaños de lote pequeños y la decodificación autorregresiva a menudo dejan subutilizadas las unidades aritméticas porque los pesos o datos de caché deben recuperarse repetidamente. Los lotes más grandes mejoran la utilización pero aumentan la latencia y la memoria.
El formato numérico cambia el compromiso. FP32, BF16, FP16, FP8 y los formatos enteros difieren en rango, precisión, soporte de hardware y error. El entrenamiento de precisión mixta conserva operaciones sensibles en mayor precisión; la inferencia cuantizada necesita calibración y pruebas de calidad en lugar de una promesa de que todos los modelos toleran el mismo ancho de bits.
Economía del sistema y direcciones futuras
El costo total de la IA incluye la compra o alquiler del acelerador, suministro de energía, refrigeración, redes, almacenamiento, ingeniería de software, capacidad ociosa y experimentos fallidos. Un chip más rápido puede costar más en total si la utilización es pobre o si el modelo requiere una topología distribuida costosa. Mida la salida útil a un umbral de calidad definido.
El escalado también está limitado por los datos y los algoritmos. Más cómputo no puede reparar datos mal etiquetados o una evaluación que premia atajos. La atención eficiente, mejores optimizadores, la esparcidad, la recuperación, la destilación y los descubrimientos algorítmicos pueden mejorar los resultados sin un aumento proporcional del hardware, aunque pueden trasladar el costo a otras áreas.
Los sistemas futuros mezclarán avances de proceso con apilamiento tridimensional, memoria de alto ancho de banda, interconexiones ópticas o eléctricas avanzadas, flujo de datos específico de dominio y software co‑diseñado. La Ley de Moore sigue siendo un contexto histórico valioso, pero la planificación debe basarse en curvas de carga de trabajo medidas y en limitaciones realistas de suministro, energía y despliegue.
Interpretar correctamente la Ley de Moore en el diseño de un sistema de IA
Un análisis útil separa la densidad de transistores, el rendimiento de la CPU de propósito general, el rendimiento del acelerador, la capacidad de memoria, el ancho de banda de memoria, la interconexión, la energía, el rendimiento de fabricación y el costo. Estos no mejoran al mismo ritmo. Una carga de trabajo de IA dominada por el movimiento de pesos del modelo puede obtener poco beneficio de más unidades aritméticas, mientras que un modelo pequeño en chip puede beneficiarse sustancialmente de hardware especializado de baja precisión. Cite la métrica exacta, la precisión, la carga de trabajo y el rango de potencia en lugar de tratar a un nodo de proceso como rendimiento.
Escalar un modelo de IA también cambia las demandas de software y del sistema. Ejecuciones de entrenamiento más grandes requieren algoritmos paralelos, puntos de control fiables, redes de alta velocidad, canalizaciones de almacenamiento y suficientes datos para aprovechar la capacidad añadida. En la inferencia, la latencia depende de la longitud del prompt, los tokens generados, el procesamiento por lotes, la memoria caché y los objetivos de nivel de servicio. Las mejoras algorítmicas, la esparcidad, la cuantización, la recuperación y datos mejores pueden proporcionar ganancias independientes de las tendencias de transistores y, a veces, superar a una generación de hardware.
Para la planificación, evalúe modelos representativos en sistemas candidatos y modele el costo total durante la vida útil del despliegue: adquisición o precio en la nube, energía, refrigeración, utilización, ingeniería, migración y riesgo de suministro. Use escenarios en lugar de una única proyección exponencial. La Ley de Moore sigue siendo una observación histórica valiosa sobre la economía de la integración, pero no garantiza que la IA se vuelva proporcionalmente más rápida, barata, más capaz o más sostenible en un calendario fijo.
Lista de verificación de implementación práctica
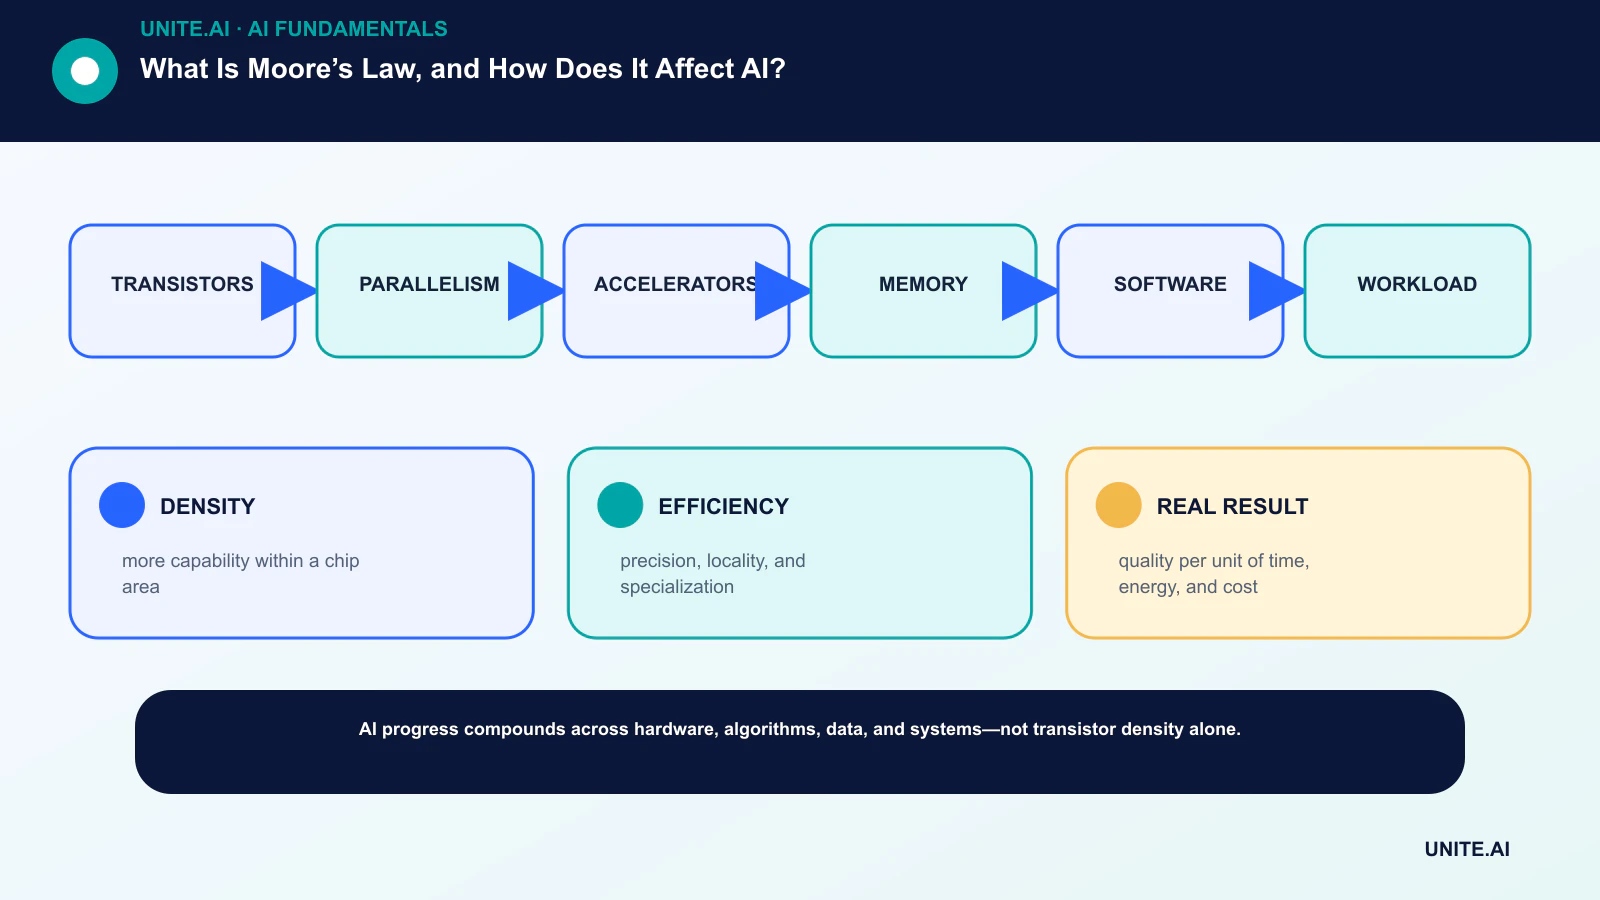
Convierta el concepto en un flujo de trabajo delimitado y verificable: transistores → paralelismo → aceleradores → memoria → software → carga de trabajo. Asigne un responsable, documente los datos y dependencias, establezca una línea base sencilla, defina criterios de aceptación y de detención, pruebe fallas representativas y establezca monitoreo, reversión y revisión antes de ampliar el alcance. Registre versiones y suposiciones para que otro equipo pueda reproducir el resultado y comprender qué cambió.
Antes del lanzamiento, realice una revisión de preparación documentada con las personas que construyen, operan, aseguran y son afectadas por el sistema. Pruebe casos normales, condiciones límite, fallas de dependencias y usos indebidos; conserve la evidencia y los riesgos no resueltos. Defina quién puede aprobar el lanzamiento, cambiar un umbral, anular una salida o detener la operación. Revise la decisión una vez que lleguen datos del mundo real, porque un piloto técnicamente exitoso no garantiza un rendimiento fiable a mayor escala.
- DENSITY: más capacidad dentro del área de un chip.
- EFFICIENCY: precisión, localidad y especialización.
- REAL RESULT: calidad por unidad de tiempo, energía y costo.
Preguntas frecuentes
¿Se ha acabado la Ley de Moore?
La tendencia histórica simple se ha desacelerado y cambiado de carácter, pero el progreso de los semiconductores continúa a través de dispositivos, arquitectura, empaquetado, memoria y software. Si la expresión sigue siendo adecuada depende de la métrica.
¿El doble de transistores implica el doble de rendimiento en IA?
No. El rendimiento depende de cómo se usan los transistores y del ancho de banda, la precisión, la estructura del modelo, la eficiencia del software, la energía y las limitaciones de la carga de trabajo.
Referencias principales