Fundamentos de la IA
¿Qué es la visión por computadora?

 Añade Unite.AI a tus fuentes preferidas en Google
Visión por computadora es el campo de construir sistemas que extraen información útil de imágenes y videos. Un modelo de visión puede clasificar una imagen completa, localizar objetos, etiquetar cada píxel, leer texto, estimar pose, rastrear movimiento o conectar contenido visual con lenguaje.
Los sistemas de visión modernos no simplemente reproducen el proceso temprano de detección de bordes de la percepción humana. Aprenden representaciones específicas de la tarea a partir de datos, a menudo usando redes neuronales convolucionales, vision transformers o modelos fundacionales multimodales.
Puntos clave
- La clasificación, detección, segmentación, OCR, seguimiento y generación son tareas de visión distintas.
- Las CNN incorporan localidad y compartición de pesos; los vision transformers emplean atención sobre parches de imagen.
- Las etiquetas pueden provenir de humanos, supervisión débil, datos sintéticos o objetivos auto‑supervisados.
- La precisión por sí sola es insuficiente: la robustez, latencia, privacidad, sesgo y costos de fallos son importantes.
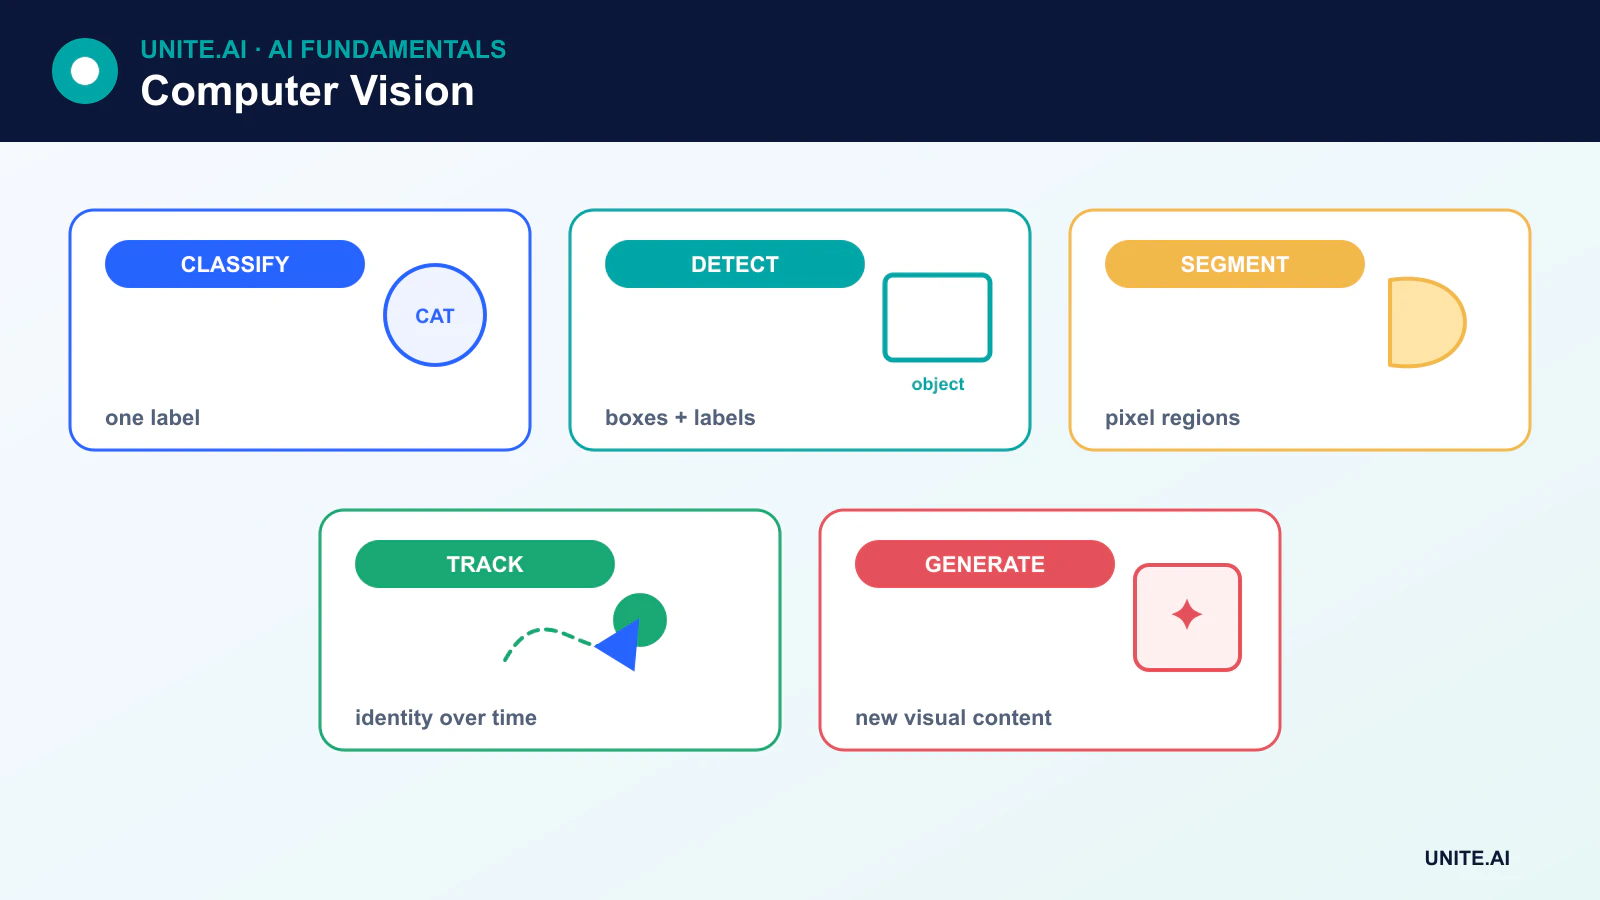
Principales tareas de visión por computadora
- Clasificación de imágenes asigna una o más etiquetas a una imagen. Ver cómo funciona la clasificación de imágenes.
- Detección de objetos predice categorías y cajas delimitadoras para varios objetos.
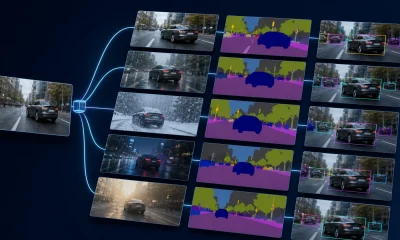
- Segmentación semántica etiqueta cada píxel por clase, mientras que la segmentación de instancias separa objetos individuales.
- Reconocimiento óptico de caracteres (OCR) detecta y transcribe texto.
- Estimación de pose predice puntos de referencia corporales o de objetos.
- Seguimiento asocia detecciones a través de fotogramas de video.
- Generación y edición de imágenes produce o transforma contenido visual, a menudo usando modelos de difusión.
Cómo las imágenes se convierten en entradas del modelo
Una imagen digital ya es datos numéricos: un tensor que contiene valores de píxeles en dimensiones espaciales y canales. El preprocesamiento puede redimensionar, normalizar, recortar o ampliar la imagen. El video añade una dimensión temporal, mientras que la imaginería médica y científica puede añadir profundidad, longitud de onda u otras modalidades.
La visión por computadora clásica utilizaba características de borde, esquina y textura diseñadas a mano. Los modelos profundos modernos suelen aprender características conjuntamente con la tarea, aunque los métodos clásicos siguen siendo útiles cuando los datos son escasos, las reglas se entienden bien o el cómputo debe ser mínimo.
CNNs y características locales aprendidas
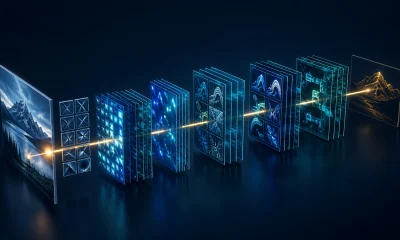
Una CNN aplica kernels aprendidos sobre vecindades locales. Las capas tempranas pueden responder a patrones locales, mientras que los bloques posteriores los combinan en representaciones relevantes para la tarea. Las operaciones de pooling o con pasos reducen la resolución espacial, y las conexiones residuales facilitan la optimización de redes profundas.
Un clasificador CNN moderno suele usar pooling global en lugar de una gran pila de capas totalmente conectadas. Los detectores y redes de segmentación añaden cabezas especializadas o rutas decodificadoras que conservan la información espacial.
Vision transformers y modelos base
Un vision transformer divide una imagen en parches, los incrusta y usa atención para modelar sus relaciones. Los transformers pueden escalar eficazmente con grandes conjuntos de datos y preentrenamiento, mientras que las CNN a menudo proporcionan supuestos incorporados más fuertes y mayor eficiencia en escalas menores.
Los modelos multimodales alinean imágenes con texto para que los usuarios puedan buscar, generar subtítulos, responder preguntas o guiar la segmentación mediante lenguaje. Estos modelos amplían la capacidad pero también heredan debilidades de los datos a escala web, incluidos estereotipos, material con derechos de autor y una cobertura desigual de poblaciones y entornos.
Etiquetas, auto‑supervisión y datos sintéticos
Crear cajas delimitadoras, máscaras, puntos de referencia y subtítulos puede ser costoso. El aprendizaje auto‑supervisado deriva objetivos a partir de las propias imágenes, mientras que la supervisión débil usa etiquetas ruidosas o indirectas. Los datos sintéticos pueden añadir escenarios raros, pero las brechas de simulación pueden impedir que el rendimiento sintético se transfiera al mundo real.
La calidad de la anotación debe medirse. Etiquetas ambiguas, límites inconsistentes y objetos ausentes establecen un techo en el rendimiento y pueden ocultar fallas en subgrupos.
Cómo se evalúan los sistemas de visión
La clasificación usa métricas como precisión, exactitud, exhaustividad, F1 y calibración. La detección emplea típicamente intersección sobre unión y precisión media. La segmentación utiliza intersección sobre unión o medidas estilo Dice. El seguimiento añade métricas de identidad y trayectoria.
La métrica debe coincidir con el despliegue. Un modelo puede obtener buenas puntuaciones en un benchmark curado y aun así fallar bajo lluvia, poca luz, ángulos de cámara inusuales, dispositivos nuevos o poblaciones desconocidas. La evaluación debería incluir desplazamiento de distribución, condiciones adversarias y latencia operativa.
Privacidad, sesgo y despliegue
Rostros, placas de matrícula, hogares, exploraciones médicas y videos en el lugar de trabajo pueden revelar información sensible. La recopilación y retención deben seguir una base legal y ética definida, con controles de acceso y minimización de datos. El análisis facial y la identificación biométrica merecen especial escrutinio porque los errores y la vigilancia pueden infligir daños desiguales.
El despliegue en el borde puede reducir latencia y transferencia de datos. Edge AI, la cuantización, la poda y aceleradores especializados pueden hacer que los sistemas de visión sean prácticos en cámaras, vehículos, robots y dispositivos móviles, pero la compresión debe reevaluarse para precisión y sesgo.
De los píxeles a las tareas visuales
La visión por computadora convierte imágenes o videos en salidas de tarea como clasificación, detección, segmentación, seguimiento, pose, profundidad, flujo óptico o reconocimiento de texto. La definición de la tarea determina la anotación: una etiqueta de imagen no puede entrenar una localización precisa, y una caja delimitadora no puede describir completamente una máscara de segmentación. La geometría de la cámara, lentes, exposición, iluminación, movimiento, compresión y punto de vista modelan la distribución de datos. Defina el entorno operativo y la consecuencia del error antes de seleccionar un modelo, porque una colección de imágenes de benchmark puede no representar el sensor o la escena desplegados.
Una canalización decodifica y orienta los medios, los redimensiona o los divide en mosaicos, normaliza valores, aplica aumentos que preservan etiquetas, ejecuta un modelo y post‑procesa logits, cajas, máscaras o rastros. Los detectores de objetos usan umbrales de confianza y supresión; los rastreadores asocian detecciones a lo largo del tiempo; la segmentación puede requerir limpieza morfológica. Preserve las transformaciones de coordenadas para que las salidas se alineen con la imagen original. Divida los datos por persona, cámara, ubicación o sesión de captura para evitar que fotogramas casi idénticos aparezcan tanto en entrenamiento como en pruebas.
Evaluación, sesgo, privacidad y operaciones
Las métricas deben coincidir con la tarea y el uso. La clasificación necesita precisión y exhaustividad específicas por clase; la detección usa intersección‑sobre‑unión y precisión promedio a través de umbrales; la segmentación usa IoU o Dice; el seguimiento añade cambios de identidad; la latencia y la duración de eventos perdidos son cruciales para video. Informe resultados por iluminación, distancia, dispositivo, oclusión, tono de piel, edad y otras condiciones relevantes. Inspeccione la calibración y los errores de alta confianza. Los datos sintéticos o aumentados pueden llenar vacíos pero requieren comparación con datos de despliegue reales y no deben filtrar escenas de prueba.
La visión puede capturar a espectadores, ubicaciones, biométricos y comportamientos sensibles. Minimice la captura y retención, asegure los flujos, restrinja usos secundarios y proporcione aviso o consentimiento cuando sea necesario. Pruebe parches adversarios, repeticiones, oclusión, fallas de cámara y desplazamiento de dominio. Monitoree la salud del sensor, estadísticas de entrada, tasas de salida y resultados confirmados; mantenga revisión humana para decisiones con consecuencias. El desenfoque o recorte puede reducir la exposición pero también eliminar evidencia. Una alta puntuación de laboratorio no justifica afirmaciones de identidad, emoción o intención más allá de la tarea validada.
Ejemplo práctico: detección de peatones en un cruce de almacén
Las cámaras vigilan un cruce de vehículos restringido, y el modelo detecta a las personas sin identificarlas. Los datos cubren día y noche, clima, vestimenta, oclusión, usuarios de silla de ruedas, posiciones de cámara y escenas vacías, divididos por sesión de grabación. El detector se evalúa en recuerdo de eventos, falsas alarmas, localización, tiempo de aviso y rendimiento a distancia. La ingeniería de seguridad define la latencia máxima tolerada y controles físicos independientes.
La alerta visual puede frenar un vehículo, pero las paradas de emergencia y barreras no dependen del modelo aprendido. Obstrucción de cámara, fotogramas congelados, pérdida de red y tiempo de espera del modelo generan fallas explícitas. La retención de video sin procesar se minimiza y el acceso se registra. El monitoreo rastrea la salud del sensor, tasas de alerta, incidentes revisados y casi fallos por condición. Cualquier reubicación o cambio de disposición de cámara desencadena una revalidación porque la similitud aparente de imágenes no garantiza la misma geometría o riesgo.
Evidencia de implementación y preparación operativa
Una decisión de producción necesita más que una demostración exitosa. Defina los usuarios previstos, entorno operativo, entradas, salidas, dependencias, responsable y la consecuencia de cada falla importante. Establezca una línea base reproducible y un conjunto de evaluación versionado antes de afinar. Pruebe casos ordinarios, condiciones límite, entradas malformadas o ausentes, desplazamiento de distribución, interrupción de dependencias, uso indebido y los grupos o entornos más propensos a quedar desatendidos. Mida la calidad de la tarea junto con calibración o incertidumbre, latencia, rendimiento, costo de recursos, accesibilidad, privacidad y seguridad. Registre cada transformación y umbral para que un revisor independiente pueda reproducir el resultado y distinguir la evidencia de un prototipo atractivo.
Antes del lanzamiento, asigne autoridad para liberaciones, excepciones, cambios, retrocesos y retiros. Use un despliegue escalonado, preserve una reserva segura y verifique el monitoreo con fallas inyectadas deliberadamente. La telemetría operativa debe revelar calidad de entrada, comportamiento de salida, versión del modelo o regla, salud de dependencias, anulaciones humanas y resultados confirmados sin recopilar datos sensibles innecesarios. Defina umbrales de alerta y un responsable de respuesta, luego revise la evidencia del mundo real después del despliegue en lugar de asumir que el rendimiento offline persistirá. Reevalúe siempre que cambien fuentes de datos, usuarios, modelos, proveedores, políticas, hardware u objetivos. Un sistema mantenido también necesita documentación de recuperación, aprendizaje de incidentes, procedimientos de eliminación y retención, y un punto claro en el que deba desactivarse o reemplazarse.
Preguntas frecuentes
¿La visión por computadora es lo mismo que el reconocimiento de imágenes?
No. El reconocimiento de imágenes suele referirse a la clasificación o identificación. La visión por computadora también incluye localización, segmentación, medición, seguimiento, reconstrucción, generación y razonamiento sobre información visual.
¿Un sistema de visión ve como un humano?
No. Un modelo procesa entradas numéricas de acuerdo con su arquitectura y objetivo de entrenamiento. Puede superar a las personas en un benchmark estrecho mientras falla ante pequeños cambios que una persona maneja con facilidad.
Referencias principales