
Συνεντεύξεις
Yotam Oren, CEO & Cofounder της Mona Labs – Σειρά Συνεντεύξεων

 Προσθέστε το Unite.AI στις προτιμώμενες πηγές σας στο Google
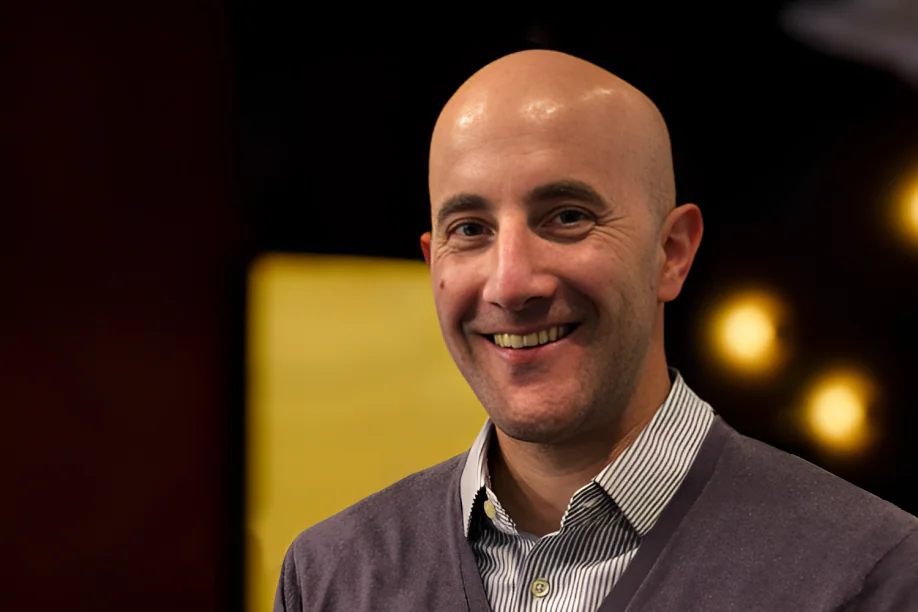
Ο Yotam Oren είναι ο διευθύνων σύμβουλος και συνιδρυτής της Mona Labs, μια πλατφόρμα που επιτρέπει στις επιχειρήσεις να μετατρέψουν τις πρωτοβουλίες AI από εργαστηριακά πειράματα σε επιχειρηματικές λειτουργίες που μπορούν να αναπτυχθούν σε μεγάλη κλίμακα, κατανοώντας πραγματικά πώς συμπεριφέρονται τα μοντέλα ML στις πραγματικές επιχειρηματικές διαδικασίες και εφαρμογές.
Η Mona αναλύει αυτόματα τη συμπεριφορά των μοντέλων μηχανικής μάθησης σας σε προστατευμένα τμήματα δεδομένων και στο πλαίσιο των επιχειρηματικών λειτουργιών, για να ανιχνεύσει πιθανές προκαταλήψεις AI. Η Mona προσφέρει τη δυνατότητα να δημιουργήσετε πλήρεις αναφορές δικαιοσύνης που ανταποκρίνονται στα πρότυπα και τις κανονιστικές απαιτήσεις της βιομηχανίας, και να αποκτήσετε εμπιστοσύνη ότι η εφαρμογή AI συμμορφώνεται με τις απαιτήσεις και είναι ελεύθερη από προκαταλήψεις.
Τι σας έκανε να ενδιαφερθείτε αρχικά για την πληροφορική;
Η πληροφορική είναι ένας δημοφιλής επαγγελματικός δρόμος στην οικογένειά μου, οπότε ήταν πάντα στο πίσω μέρος του μυαλού μου ως μια βιώσιμη επιλογή. Φυσικά, ο ισραηλινός πολιτισμός είναι πολύ προ-τεχνολογικός. Τιμούμε τους καινοτόμους ανθρώπους της τεχνολογίας και πάντα είχα την αντίληψη ότι η πληροφορική θα μου προσφέρει ευκαιρίες εξέλιξης και επιτευγμάτων.
Παρ’ όλα αυτά, έγινε προσωπικό μου πάθος μόνο όταν έφτασα στην ηλικία του πανεπιστημίου. Δεν ήμουν ένα από τα παιδιά που άρχισαν να προγραμματίζουν στο γυμνάσιο. Στα νεανικά μου χρόνια, ήμουν πολύ απασχολημένος με το μπάσκετ για να δώσω σημασία στους υπολογιστές. Μετά το λύκειο, πέρασα σχεδόν 5 χρόνια στο στρατό, σε ηγετικούς επιχειρησιακούς και μάχιμους ρόλους. Έτσι, με έναν τρόπο, πραγματικά άρχισα να μαθαίνω για την πληροφορική μόνο όταν έπρεπε να επιλέξω έναν ακαδημαϊκό κλάδο στο πανεπιστήμιο. Αυτό που τράβηξε αμέσως την προσοχή μου ήταν ότι η πληροφορική συνδύαζε την επίλυση προβλημάτων και την εκμάθηση μιας γλώσσας (ή γλωσσών). Δύο πράγματα που με ενδιέφεραν ιδιαίτερα. Από τότε με κέρδισε ο κλάδος.
Από το 2006 έως το 2008, εργαστήκατε στη χαρτογράφηση και πλοήγηση για μια μικρή εταιρεία, ποια ήταν κάποια από τα βασικά συμπεράσματά σας από αυτή την εποχή;
Ο ρόλος μου στην Telmap ήταν η κατασκευή ενός μηχανισμού αναζήτησης βασισμένου σε χαρτογραφικά δεδομένα και δεδομένα τοποθεσίας.
Αυτές ήταν οι πολύ πρώτες μέρες των «μεγάλων δεδομένων» στην επιχείρηση. Δεν το ονομάζαμε ακόμη έτσι, αλλά συγκεντρώναμε τεράστια σύνολα δεδομένων και προσπαθούσαμε να βγάλουμε τις πιο σημαντικές και σχετικές πληροφορίες για να τις δείξουμε στους τελικούς χρήστες.
Μια από τις εντυπωσιακές ανακαλύψεις που έκανα ήταν ότι οι εταιρείες (συμπεριλαμβανομένης και της δικής μας) χρησιμοποιούσαν τόσο λίγο από τα δεδομένα τους (αλλά και τα δημόσια διαθέσιμα εξωτερικά δεδομένα). Υπήρχαν τόσο μεγάλες δυνατότητες για νέες πληροφορίες, καλύτερες διαδικασίες και εμπειρίες.
Το άλλο συμπέρασμα ήταν ότι η δυνατότητα να αποκτήσουμε περισσότερα από τα δεδομένα μας εξαρτιόταν, φυσικά, από το να έχουμε καλύτερες αρχιτεκτονικές, καλύτερη υποδομή και ούτω καθεξής.
Μπορείτε να μοιραστείτε την ιστορία της Mona Labs;
Οι τρεις από εμάς, συνιδρυτές, έχουμε περάσει όλη μας την καριέρα γύρω από προϊόντα δεδομένων.
Ο Nemo, ο τεχνικός διευθυντής, είναι ο φίλος μου από το κολέγιο και ο συμφοιτητής μου, και ένας από τους πρώτους υπαλλήλους της Google (GOOGL ) Tel Aviv. Ξεκίνησε ένα προϊόν εκεί που ονομάζεται Google Trends, το οποίο είχε πολλές προηγμένες αναλύσεις και μηχανική μάθηση βασισμένες σε δεδομένα αναζήτησης. Ο Itai, ο άλλος συνιδρυτής και προϊστάμενος προϊόντων, ήταν στην ομάδα του Nemo στη Google (και τον γνώρισα μέσω του Nemo). Οι δύο τους ήταν πάντα απογοητευμένοι ότι τα συστήματα AI δεν παρακολουθούνταν μετά την αρχική ανάπτυξη και δοκιμή. Παρά τη δυσκολία να δοκιμάσουν σωστά αυτά τα συστήματα πριν από την παραγωγή, οι ομάδες δεν ήξεραν πόσο καλά λειτουργούσαν τα προβλεπτικά μοντέλα τους με την πάροδο του χρόνου. Επιπλέον, φαινόταν ότι η μόνη φορά που θα ακούγαν οποιαδήποτε ανατροφοδότηση για τα συστήματα AI ήταν όταν τα πράγματα πήγαιναν άσχημα και η ομάδα ανάπτυξης καλούνταν για μια έκτακτη παρέμβαση για να διορθώσει καταστροφικά προβλήματα.
Την ίδια περίοδο, ήμουν σύμβουλος στην McKinsey & Co, και ένα από τα μεγαλύτερα εμπόδια που είδα για τα προγράμματα AI και Big Data να κλιμακωθούν σε μεγάλες επιχειρήσεις ήταν η έλλειψη εμπιστοσύνης που είχαν οι επιχειρηματικοί ενδιαφερόμενοι σε αυτά τα προγράμματα.
Το κοινό νήμα εδώ έγινε σαφές για τον Nemo, τον Itai και εμένα στις συνομιλίες. Η βιομηχανία χρειαζόταν την υποδομή για να εποπτεύει τα συστήματα AI/ML στην παραγωγή. Διαμορφώσαμε το όραμα να προσφέρουμε αυτή την ορατότητα για να αυξήσουμε την εμπιστοσύνη των επιχειρηματικών ενδιαφερόμενων και να επιτρέψουμε στις ομάδες AI να έχουν πάντα τον έλεγχο του πώς λειτουργούν τα συστήματά τους και να βελτιώνουν επαναληπτικά τα συστήματα πιο αποτελεσματικά.
Και τότε ιδρύθηκε η Mona.
Τι είναι κάποια από τα τρέχοντα προβλήματα με την έλλειψη διαφάνειας AI;
Σε πολλές βιομηχανίες, οι οργανισμοί έχουν ήδη δαπανήσει δεκάδες εκατομμύρια δολάρια στα προγράμματα AI τους και έχουν δει κάποια αρχική επιτυχία στο εργαστήριο και σε μικρές κλίμακες αναπτύξεων. Αλλά η κλιμάκωση, η επίτευξη ευρείας υιοθέτησης και το να βασιστεί πραγματικά η επιχείρηση στην AI υπήρξε ένα τεράστιο πρόβλημα για σχεδόν όλους.
Γιατί συμβαίνει αυτό; Ξεκινά με το γεγονός ότι η εξαιρετική έρευνα δεν μετατρέπεται αυτόματα σε εξαιρετικά προϊόντα (ένας πελάτης μας είπε, «Τα μοντέλα ML είναι σαν αυτοκίνητα, τη στιγμή που βγαίνουν από το εργαστήριο, χάνουν 20% της αξίας τους»). Τα καλά προϊόντα έχουν υποστηρικτικά συστήματα. Υπάρχουν εργαλεία και διαδικασίες για να διασφαλίσουν ότι η ποιότητα διατηρείται με την πάροδο του χρόνου και ότι τα προβλήματα ανιχνεύονται νωρίς και αντιμετωπίζονται αποτελεσματικά. Τα καλά προϊόντα έχουν επίσης έναν συνεχή κύκλο ανατροφοδότησης, έχουν έναν κύκλο βελτίωσης και έναν οδικό χάρτη εξέλιξης. Συνεπώς, τα καλά προϊόντα απαιτούν βαθιά και συνεχή διαφάνεια απόδοσης.
Όταν υπάρχει έλλειψη διαφάνειας, τελικά καταλήγεις με:
- Προβλήματα που παραμένουν κρυφά για κάποιο χρονικό διάστημα και μετά εκρήγνυνται στην επιφάνεια προκαλώντας έκτακτες παρεμβάσεις
- Χρονοβόρες χειροκίνητες διερευνήσεις και διορθωτικές ενέργειες
- Ένα πρόγραμμα AI που δεν εμπιστεύονται οι επιχειρηματικοί χρήστες και οι χρηματοδότες και τελικά αποτυγχάνει να κλιμακωθεί
Ποιες είναι ορισμένες προκλήσεις για να γίνουν τα προβλεπτικά μοντέλα διαφανή και αξιόπιστα;
Η διαφάνεια είναι ένας σημαντικός παράγοντας για την επίτευξη εμπιστοσύνης, φυσικά. Η διαφάνεια μπορεί να έρθει σε πολλές μορφές. Υπάρχει η διαφάνεια της μεμονωμένης πρόβλεψης που μπορεί να περιλαμβάνει την εμφάνιση του επιπέδου εμπιστοσύνης στον χρήστη ή την παροχή μιας εξήγησης/λογικής για την πρόβλεψη. Η διαφάνεια της μεμονωμένης πρόβλεψης αποσκοπεί κυρίως στο να αισθάνεται ο χρήστης μεγαλύτερη σιγουριά για την πρόβλεψη. Και τότε, υπάρχει η γενική διαφάνεια που μπορεί να περιλαμβάνει πληροφορίες σχετικά με την ακρίβεια πρόβλεψης, απροσδόκητα αποτελέσματα και πιθανά προβλήματα. Η ομάδα AI χρειάζεται συνολική διαφάνεια.
Το πιο δύσκολο μέρος της γενικής διαφάνειας είναι η ανίχνευση προβλημάτων νωρίς, η ειδοποίηση του σχετικού μέλους της ομάδας ώστε να μπορέσει να λάβει διορθωτικά μέτρα πριν από την εκδήλωση καταστροφών.
Γιατί είναι δύσκολο να ανιχνεύσετε προβλήματα νωρίς:
- Τα προβλήματα συχνά ξεκινούν σε μικρή κλίμακα και εξελίσσονται αθόρυβα, πριν τελικά εκραγούν στην επιφάνεια.
- Τα προβλήματα συχνά αρχίζουν λόγω ανεξέλεγκτων ή εξωτερικών παραγόντων, όπως πηγές δεδομένων.
- Υπάρχουν πολλοί τρόποι για να «διαιρέσετε τον κόσμο» και η εξαντλητική αναζήτηση προβλημάτων σε μικρά υποσύνολα μπορεί να οδηγήσει σε πολύ θόρυβο και κόπωση από τις ειδοποιήσεις, τουλάχιστον όταν αυτό γίνεται με μια αφελή προσέγγιση.
Ένα άλλο δύσκολο ζήτημα της παροχής διαφάνειας είναι η τεράστια εξάπλωση των περιπτώσεων χρήσης AI. Αυτό κάνει μια προσέγγιση «ένα μέγεθος για όλους» σχεδόν αδύνατη. Κάθε περίπτωση χρήσης AI μπορεί να περιλαμβάνει διαφορετικές δομές δεδομένων, διαφορετικούς επιχειρηματικούς κύκλους, διαφορετικούς δείκτες επιτυχίας και συχνά διαφορετικές τεχνικές προσεγγίσεις και ακόμη και στοίβες.
Έτσι, είναι ένα τεράστιο έργο, αλλά η διαφάνεια είναι τόσο θεμελιώδους σημασίας για την επιτυχία των προγραμμάτων AI, οπότε πρέπει να το κάνετε.
Μπορείτε να μοιραστείτε ορισμένες λεπτομέρειες για τις λύσεις για τα μοντέλα NLU / NLP και τα chatbots;
Η συνομιλητική AI είναι ένας από τους βασικούς τομείς δραστηριότητας της Mona. Είμαστε υπερήφανοι που υποστηρίζουμε καινοτόμες εταιρείες με μια ευρεία γκάμα περιπτώσεων χρήσης συνομιλητικής AI, συμπεριλαμβανομένων γλωσσικών μοντέλων, chatbots και πολλών άλλων.
Ένας κοινός παράγοντας σε όλες τις περιπτώσεις χρήσης είναι ότι τα μοντέλα λειτουργούν κοντά (και μερικές φορές ορατά) στους πελάτες, οπότε ο κίνδυνος ασυνέπειας ή κακής συμπεριφοράς είναι υψηλότερος. Γίνεται τόσο σημαντικό για τις ομάδες συνομιλητικής AI να κατανοήσουν τη συμπεριφορά του συστήματος σε ένα λεπτομερές επίπεδο, το οποίο είναι ένας τομέας ισχύος της λύσης εποπτείας της Mona.
Αυτό που κάνει τη λύση της Mona ιδιαίτερα ξεχωριστή είναι η συστηματική εξέταση ομάδων συνομιλιών και ο εντοπισμός υποσυνόλων στα οποία τα μοντέλα (ή τα bots) συμπεριφέρονται κακώς. Αυτό επιτρέπει στις ομάδες συνομιλητικής AI να αναγνωρίσουν προβλήματα νωρίς και πριν οι πελάτες τα παρατηρήσουν. Αυτή η ικανότητα είναι ένας κρίσιμος παράγοντας απόφασης για τις ομάδες συνομιλητικής AI όταν επιλέγουν λύσεις εποπτείας.
Για να το συνοψίσω, η Mona προσφέρει μια ολοκληρωμένη λύση για την εποπτεία συνομιλητικής AI. Ξεκινά με την εξασφάλιση ότι υπάρχει μία ενιαία πηγή πληροφοριών για τη συμπεριφορά του συστήματος με την πάροδο του χρόνου και συνεχίζει με τη συνεχή παρακολούθηση των δεικτών απόδοσης και των προληπτικών ευρημάτων για υποσύνολα προβληματικής συμπεριφοράς – επιτρέποντας στις ομάδες να λάβουν προληπτικά, αποτελεσματικά διορθωτικά μέτρα.
Μπορείτε να προσφέρετε ορισμένες λεπτομέρειες για τον μηχανισμό εξαγωγής πληροφοριών της Mona;
Βέβαια. Ας αρχίσουμε με το κίνητρο. Ο στόχος του μηχανισμού εξαγωγής πληροφοριών είναι να αναδείξει ανωμαλίες στους χρήστες, με ακριβώς τη σωστή ποσότητα πληροφοριών μέσα στο κατάλληλο πλαίσιο και χωρίς να δημιουργήσει θόρυβο ή να οδηγήσει σε κόπωση από τις ειδοποιήσεις.
Ο μηχανισμός εξαγωγής πληροφοριών είναι μια μοναδική αναλυτική ροή εργασίας. Σε αυτή τη ροή εργασίας, ο κινητήρας αναζητά ανωμαλίες σε όλα τα τμήματα των δεδομένων, επιτρέποντας την πρώιμη ανίχνευση προβλημάτων όταν είναι ακόμη «μικρά» και πριν επηρεάσουν ολόκληρο το σύνολο δεδομένων και τους επόμενους επιχειρηματικούς δείκτες KPI. Στη συνέχεια, χρησιμοποιεί έναν ιδιόκτητο αλγόριθμο για να ανιχνεύσει τις βασικές αιτίες των ανωμαλιών και να διασφαλίσει ότι κάθε ανωμαλία ειδοποιείται μόνο μια φορά, ώστε να αποφευχθεί ο θόρυβος. Οι τύποι ανωμαλιών που υποστηρίζονται περιλαμβάνουν: ανωμαλίες χρονοσειρών, μετατοπίσεις κατανομής, ακραίες τιμές και υποβάθμιση μοντέλων.
Ο μηχανισμός εξαγωγής πληροφοριών είναι ιδιαίτερα προσαρμόσιμος μέσω της διεπαφής no-code/low-code της Mona. Η προσαρμογή του κινητήρα κάνει τη Mona την πιο ευέλικτη λύση στην αγορά, καλύπτοντας μια ευρεία γκάμα περιπτώσεων χρήσης (π.χ. batch και streaming, με/χωρίς επιχειρηματική ανατροφοδότηση / ground truth, σε διαφορετικές εκδόσεις μοντέλων ή μεταξύ εκπαίδευσης και inference, και πολλά άλλα).
Τέλος, αυτός ο μηχανισμός εξαγωγής πληροφοριών υποστηρίζεται από έναν πίνακα οπτικοποίησης, στον οποίο μπορούν να προβληθούν τα ευρήματα, και ένα σύνολο εργαλείων έρευνας για να επιτρέψουν την ανάλυση αιτιών και περαιτέρω εξέταση των πληροφοριών στο κατάλληλο πλαίσιο. Ο μηχανισμός εξαγωγής πληροφοριών είναι επίσης πλήρως ολοκληρωμένος με έναν μηχανισμό ειδοποίησης που επιτρέπει την αποστολή ευρημάτων στους δικούς σας χώρους εργασίας, συμπεριλαμβανομένων email, πλατφορμών συνεργασίας και ούτω καθεξής.
Στις 31 Ιανουαρίου, η Mona παρουσίασε τη νέα της λύση για τη δικαιοσύνη στην AI, μπορείτε να μοιραστείτε μαζί μας λεπτομέρειες για αυτή τη λειτουργία και γιατί έχει σημασία;
Η δικαιοσύνη στην AI αφορά τη διασφάλιση ότι οι αλγόριθμοι και τα συστήματα AI γενικά λαμβάνουν αμερόληπτες και ισότιμες αποφάσεις. Η αντιμετώπιση και η πρόληψη των προκαταλήψεων στα συστήματα AI είναι κρίσιμη, καθώς μπορούν να οδηγήσουν σε σημαντικές πραγματικές συνέπειες. Με την αυξανόμενη σημασία της AI, η επίδραση στις καθημερινές ζωές θα είναι ορατή σε περισσότερες και περισσότερες τοποθεσίες, συμπεριλαμβανομένης της αυτοματοποίησης της οδήγησης, της ανίχνευσης ασθενειών με μεγαλύτερη ακρίβεια, της βελτίωσης της κατανόησής μας για τον κόσμο και ακόμη και της δημιουργίας τέχνης. Αν δεν μπορούμε να εμπιστευθούμε ότι είναι δίκαιο και αμερόληπτο, πώς θα επιτρέψουμε να συνεχίσει να εξαπλώνεται;
Μία από τις κύριες αιτίες προκατάληψης είναι η ανεπαρκής αντιπροσώπευση του πραγματικού κόσμου στα δεδομένα εκπαίδευσης των μοντέλων. Αυτό μπορεί να προέρχεται από ιστορική διάκριση, υπο-αντιπροσώπευση ορισμένων ομάδων ή ακόμη και εσκεμμένη χειραγώγηση δεδομένων. Για παράδειγμα, ένα σύστημα αναγνώρισης προσώπου που εκπαιδεύτηκε σε δεδομένα κυρίως ανοιχτόχρωμων ατόμων είναι πιθανό να έχει υψηλότερο ποσοστό λάθους στην αναγνώριση ατόμων με σκουρόχρωμα δέρματα. Παρόμοια, ένα μοντέλο γλώσσας που εκπαιδεύτηκε σε δεδομένα κειμένου από ένα περιορισμένο σύνολο πηγών μπορεί να αναπτύξει προκαταλήψεις αν τα δεδομένα είναι προκατειλημμένα προς ορισμένες απόψεις, σε θέματα όπως η θρησκεία, ο πολιτισμός και ούτω καθεξής.
Η λύση δικαιοσύνης της Mona δίνει στις ομάδες AI και επιχειρήσεων την εμπιστοσύνη ότι το AI τους είναι ελεύθερο από προκαταλήψεις. Σε ρυθμιζόμενους τομείς, η λύση της Mona μπορεί να προετοιμάσει τις ομάδες για την ετοιμότητα συμμόρφωσης.
Η λύση δικαιοσύνης της Mona είναι ιδιαίτερη επειδή βασίζεται στην πλατφόρμα Mona – μια γέφυρα μεταξύ δεδομένων AI και μοντέλων και των πραγματικών επιπτώσεων τους στην παραγωγή. Η Mona εξετάζει όλα τα τμήματα της επιχειρηματικής διαδικασίας που το μοντέλο AI εξυπηρετεί στην παραγωγή, για να συσχετίσει τα δεδομένα εκπαίδευσης, τη συμπεριφορά του μοντέλου και τις πραγματικές επιπτώσεις στον κόσμο για να προσφέρει την πιο ολοκληρωμένη αξιολόγηση της δικαιοσύνης.
Δεύτερον, έχει έναν μοναδικό αναλυτικό μηχανισμό που επιτρέπει την ευέλικτη διαίρεση των δεδομένων για τον έλεγχο των σχετικών παραμέτρων. Αυτό επιτρέπει ακριβείς συσχετίσεις αξιολογήσεων στο σωστό πλαίσιο, αποφεύγοντας το Simpson’s Paradox και παρέχοντας μια εμπεριστατωμένη «βαθμολογία προκατάληψης» από πραγματικά δεδομένα για κάθε δείκτη απόδοσης και για κάθε προστατευμένο χαρακτηριστικό.
Συνολικά, θα έλεγα ότι η Mona είναι ένα θεμελιώδες στοιχείο για τις ομάδες που πρέπει να δημιουργήσουν και να αναπτύξουν υπεύθυνα συστήματα AI.
Ποιο είναι το όραμά σας για το μέλλον του AI;
Αυτό είναι ένα μεγάλο ερώτημα.
Νομίζω ότι είναι εύκολο να προβλέψουμε ότι το AI θα συνεχίσει να αυξάνεται σε χρήση και επιρροή σε διάφορους βιομηχανικούς τομείς και πτυχές της ζωής των ανθρώπων. Ωστόσο, είναι δύσκολο να ληφθεί σοβαρά ένα όραμα που είναι λεπτομερές και που προσπαθεί να καλύψει όλες τις περιπτώσεις χρήσης και τις επιπτώσεις του AI στο μέλλον. Διότι κανείς δεν ξέρει αρκετά για να περιγράψει αξιόπιστα αυτή την εικόνα.
Αυτό που ξέρουμε βέβαια είναι ότι το AI θα είναι στα χέρια περισσότερων ανθρώπων και θα εξυπηρετεί περισσότερους σκοπούς. Η ανάγκη για διακυβέρνηση και διαφάνεια θα αυξηθεί σημαντικά.
Η πραγματική ορατότητα στο AI και πώς λειτουργεί θα παίξει δύο πρωταρχικούς ρόλους. Πρώτον, θα βοηθήσει να εμπνεύσει εμπιστοσύνη στους ανθρώπους και να άρει τα εμπόδια αντίστασης για ταχύτερη υιοθέτηση. Δεύτερον, θα βοηθήσει όσους λειτουργούν την AI να διασφαλίσουν ότι δεν ξεφεύγει από τον έλεγχο.
Ευχαριστώ πολύ για τη μεγάλη συνέντευξη, οι αναγνώστες που επιθυμούν να μάθουν περισσότερα πρέπει να επισκεφθούν τη Mona Labs.
Σημείωση για την πηγή: η διατύπωση του πρωτοτύπου για την «ικανότητα» των δεδομένων να αντιπροσωπεύουν την πραγματικότητα αποδόθηκε ως ανεπαρκής αντιπροσώπευση, σύμφωνα με τα παραδείγματα υποεκπροσώπησης και μεροληπτικών πηγών που ακολουθούν.






