
Andersons Blickwinkel
‘Kreatives’ Gesichtsverifizierung mit Generativen Adversarial-Netzwerken

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen

Ein neues Papier der Stanford-Universität hat eine neue Methode vorgeschlagen, um Gesichtsauthentifizierungssysteme auf Plattformen wie Dating-Apps zu täuschen, indem ein Generatives Adversarial-Netzwerk (GAN) verwendet wird, um alternative Gesichtsbilder zu erstellen, die die gleichen wesentlichen ID-Informationen wie ein echtes Gesicht enthalten.
Die Methode hat die Gesichtsverifizierungsprozesse in den Dating-Apps Tinder und Bumble erfolgreich umgangen, in einem Fall sogar ein geschlechtsspezifisches (männliches) Gesicht als authentisch für die Quellenidentität (weibliche) Identität ausgewiesen.

Verschiedene generierte Identitäten, die die spezifische Kodierung des Autors des Papiers (in der ersten Abbildung oben) enthalten. Quelle: https://arxiv.org/pdf/2203.15068.pdf
Laut dem Autor stellt die Arbeit den ersten Versuch dar, Gesichtsverifizierung mit generierten Bildern zu umgehen, die mit spezifischen Identitätsmerkmalen ausgestattet sind, aber eine alternative oder wesentlich veränderte Identität darstellen sollen.
Die Technik wurde auf einem benutzerdefinierten lokalen Gesichtsverifizierungssystem getestet und hat sich in Black-Box-Tests gegen zwei Dating-Apps, die Gesichtsverifizierung auf benutzerhochgeladenen Bildern durchführen, bewährt.
Das neue Papier trägt den Titel Gesichtsverifizierungsumgehung und stammt von Sanjana Sarda, einer Forscherin am Department of Electrical Engineering der Stanford-Universität.
Steuerung des Gesichtsraums
Obwohl das “Einfügen” von ID-spezifischen Merkmalen (z. B. von Gesichtern, Verkehrsschildern usw.) in bearbeitete Bilder ein Standardverfahren bei adversarialen Angriffen ist, legt die neue Studie etwas anderes nahe: dass die wachsende Fähigkeit des Forschungssektors, den latenten Raum von GANs zu kontrollieren, letztendlich die Entwicklung von Architekturen ermöglichen wird, die konsistente alternative Identitäten zu denen eines Benutzers erstellen können – und damit effektiv die Extraktion von Identitätsmerkmalen aus im Internet verfügbaren Bildern eines unbefangenen Benutzers ermöglichen, um sie in eine “Schatten”-Identität zu integrieren.
Konsistenz und Navigierbarkeit haben seit der Einführung von Generativen Adversarial-Netzwerken die primären Herausforderungen im Zusammenhang mit dem latenten Raum von GANs dargestellt. Ein GAN, das erfolgreich eine Sammlung von Trainingsbildern in seinen latenten Raum integriert hat, bietet keine einfache Karte, um Merkmale von einer Klasse in eine andere zu “schieben”.
Während Techniken und Werkzeuge wie Gradient-weighted Class Activation Mapping (Grad-CAM) helfen können, latente Richtungen zwischen den etablierten Klassen zu etablieren und Transformationen zu ermöglichen (siehe Bild unten), stellt die weitere Herausforderung der Verflechtung in der Regel eine “approximative” Reise dar, mit begrenzter Feinsteuerung der Übergänge.
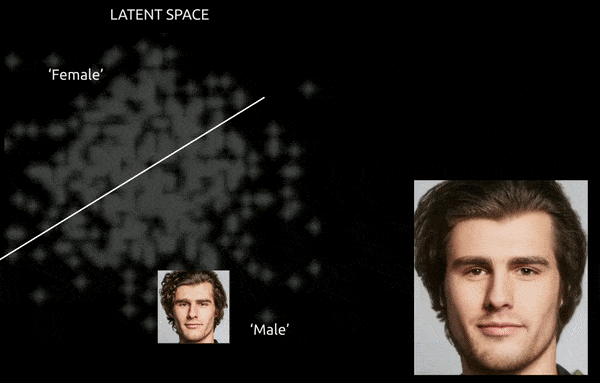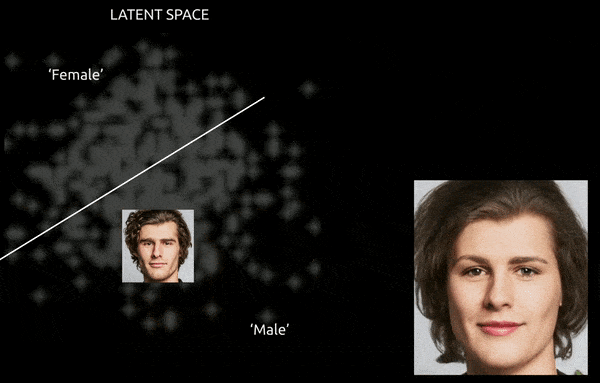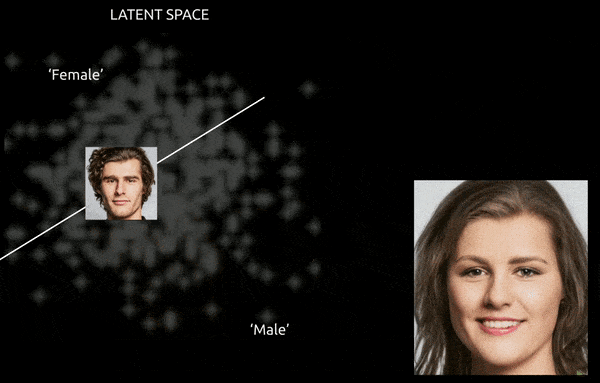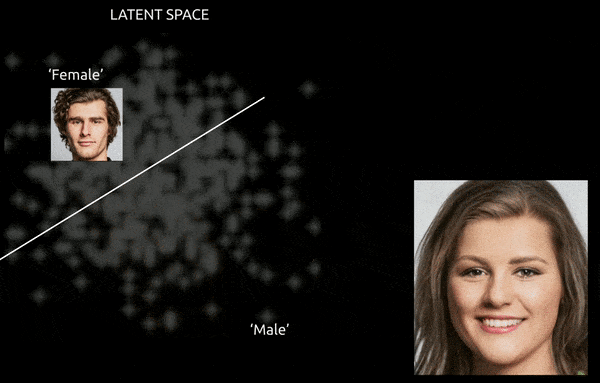
Eine raue Reise zwischen kodierten Vektoren im latenten Raum eines GAN, bei der eine datenbasierte männliche Identität in die “weiblichen” Kodierungen auf der anderen Seite einer der vielen linearen Hyperflächen im komplexen und arkischen latenten Raum geschoben wird. Bildmaterial von https://www.youtube.com/watch?v=dCKbRCUyop8
Die Fähigkeit, ID-spezifische Merkmale “einzufrieren” und zu schützen, während sie in transformative Kodierungen an anderen Stellen im latenten Raum bewegt werden, macht es möglicherweise möglich, eine konsistente (und sogar animierbare) Person zu erstellen, deren Identität von Maschinensystemen als jemand anderes gelesen wird.
Methode
Der Autor verwendete zwei Datensätze als Grundlage für die Experimente: einen Datensatz mit 310 Bildern seines Gesichts, das über einen Zeitraum von vier Jahren aufgenommen wurde, mit variierender Beleuchtung, Alter und Blickwinkeln), mit ausgeschnittenen Gesichtern, die über Caffe extrahiert wurden; und den rassisch ausgewogenen Datensatz mit 108.501 Bildern, der ähnlich extrahiert und ausgeschnitten wurde.
Das lokale Gesichtsverifizierungsmodell wurde von einer Basisimplementierung von FaceNet und DeepFace abgeleitet, das auf ConvNet Inception vor trainiert wurde, wobei jedes Bild durch einen 128-dimensionalen Vektor dargestellt wurde.
Der Ansatz verwendet Gesichtsbilder aus einem trainierten Teil des FairFace-Datensatzes. Um die Gesichtsverifizierung zu bestehen, wird der berechnete Abstand, der durch den Frobenius-Norm eines Bildes verursacht wird, gegen die Zielbenutzerin in der Datenbank angepasst. Jedes Bild unter der Schwelle von 0,7 entspricht der gleichen Identität, andernfalls gilt die Verifizierung als fehlgeschlagen.
Ein StyleGAN-Modell wurde auf dem persönlichen Datensatz des Autors feinjustiert, wodurch ein Modell entstand, das erkennbare Variationen seiner Identität erzeugen konnte, obwohl keines der generierten Bilder identisch mit den Trainingsdaten war. Dies wurde erreicht, indem die ersten vier Schichten im Diskriminator eingefroren wurden, um eine Überanpassung der Daten zu vermeiden und variierte Ausgaben zu erzeugen.
Obwohl mit dem Basis-StyleGAN-Modell diverse Bilder erhalten wurden, führte die geringe Auflösung und Fidelität zu einem zweiten Versuch mit StarGAN V2, der das Training von Seed-Bildern auf ein Zielgesicht ermöglicht.
Das StarGAN-V2-Modell wurde über etwa 10 Stunden mit dem FairFace-Validierungsset, einem Batch-Größe von vier und einer Validierungsgröße von 8, vor trainiert. Im erfolgreichsten Ansatz wurde der persönliche Datensatz des Autors als Quelle mit Trainingsdaten als Referenz verwendet.
Verifizierungsexperimente
Ein Gesichtsverifizierungsmodell wurde auf der Grundlage eines Teils von 1000 Bildern konstruiert, mit dem Ziel, ein willkürliches Bild aus dem Satz zu verifizieren. Bilder, die die Verifizierung erfolgreich bestanden, wurden anschließend gegen die eigene ID des Autors getestet.

Links, der Autor des Papiers, ein echtes Foto; Mitte, ein willkürliches Bild, das die Verifizierung nicht bestanden hat; rechts, ein unabhängiges Bild aus dem Datensatz, das als Autor verifiziert wurde.
Das Ziel der Experimente bestand darin, eine möglichst große Lücke zwischen der wahrgenommenen visuellen Identität und den definierenden Merkmalen der Zielidentität zu schaffen. Dies wurde mit der Mahalanobis-Distanz bewertet, einem Maß, das in der Bildverarbeitung für Muster- und VorlagenSuche verwendet wird.
Für das Basis-Generierungsmodell zeigen die Ergebnisse mit niedriger Auflösung begrenzte Vielfalt, obwohl sie die lokale Gesichtsverifizierung bestanden. StarGAN V2 erwies sich als besser geeignet, um diverse Bilder zu erstellen, die authentifiziert werden konnten.

Alle abgebildeten Bilder haben die lokale Gesichtsverifizierung bestanden. Oben sind die Bildgenerierungen mit niedriger Auflösung des StyleGAN-Basismodells, unten die höher auflösenden und qualitativ besseren Generierungen von StarGAN V2.
Die endgültigen drei Bilder, die oben abgebildet sind, verwendeten den persönlichen Datensatz des Autors als Quelle und Referenz, während die vorherigen Bilder Trainingsdaten als Referenz und den Datensatz des Autors als Quelle verwendeten.
Die resultierenden generierten Bilder wurden gegen die Gesichtsverifizierungssysteme der Dating-Apps Bumble und Tinder getestet, wobei die Identität des Autors als Basis diente, und bestanden die Verifizierung. Eine “männliche” Generation des Gesichts des Autors bestand auch die Verifizierung von Bumble, obwohl die Beleuchtung im generierten Bild vor der Annahme angepasst werden musste. Tinder akzeptierte die männliche Version nicht.

Männliche Versionen der (weiblichen) Identität des Autors.
Schlussfolgerung
Diese sind seminale Experimente in der Identitätsprojektion im Kontext der Manipulation des latenten Raums von GANs, was eine außergewöhnliche Herausforderung in der Bildsynthese und der Deepfake-Forschung darstellt. Dennoch eröffnet die Arbeit das Konzept, hochspezifische Merkmale konsistent über diverse Identitäten zu integrieren und “alternative” Identitäten zu erstellen, die als jemand anderes “gelesen” werden.
Erstveröffentlicht am 30. März 2022.


