
Grundlæggende AI
Hvad er Bayes’ teorem?

 Føj Unite.AI til dine foretrukne kilder på Google
Bayes’ teorem beskriver, hvordan man opdaterer sandsynligheden for en hypotese efter at have observeret beviser. Det forbinder sandsynligheden for beviset givet en hypotese med sandsynligheden for hypotesen givet det bevis.
Dette skel er centralt for statistisk ræsonnement og maskinlæring. En test kan være meget præcis, når en tilstand er til stede, mens et positivt resultat stadig kun har en beskeden sandsynlighed for at indikere tilstanden, hvis tilstanden er sjælden.
Vigtige pointer
- Den posterior kombinerer en forudgående tro med sandsynligheden for observeret bevis.
- Bevisleddet normaliserer de mulige hypoteser.
- Grundrater kan dominere tilsyneladende stærkt bevis.
- Naive Bayes antager, at funktioner er betinget uafhængige givet klassen, ikke uafhængige i alle omstændigheder.
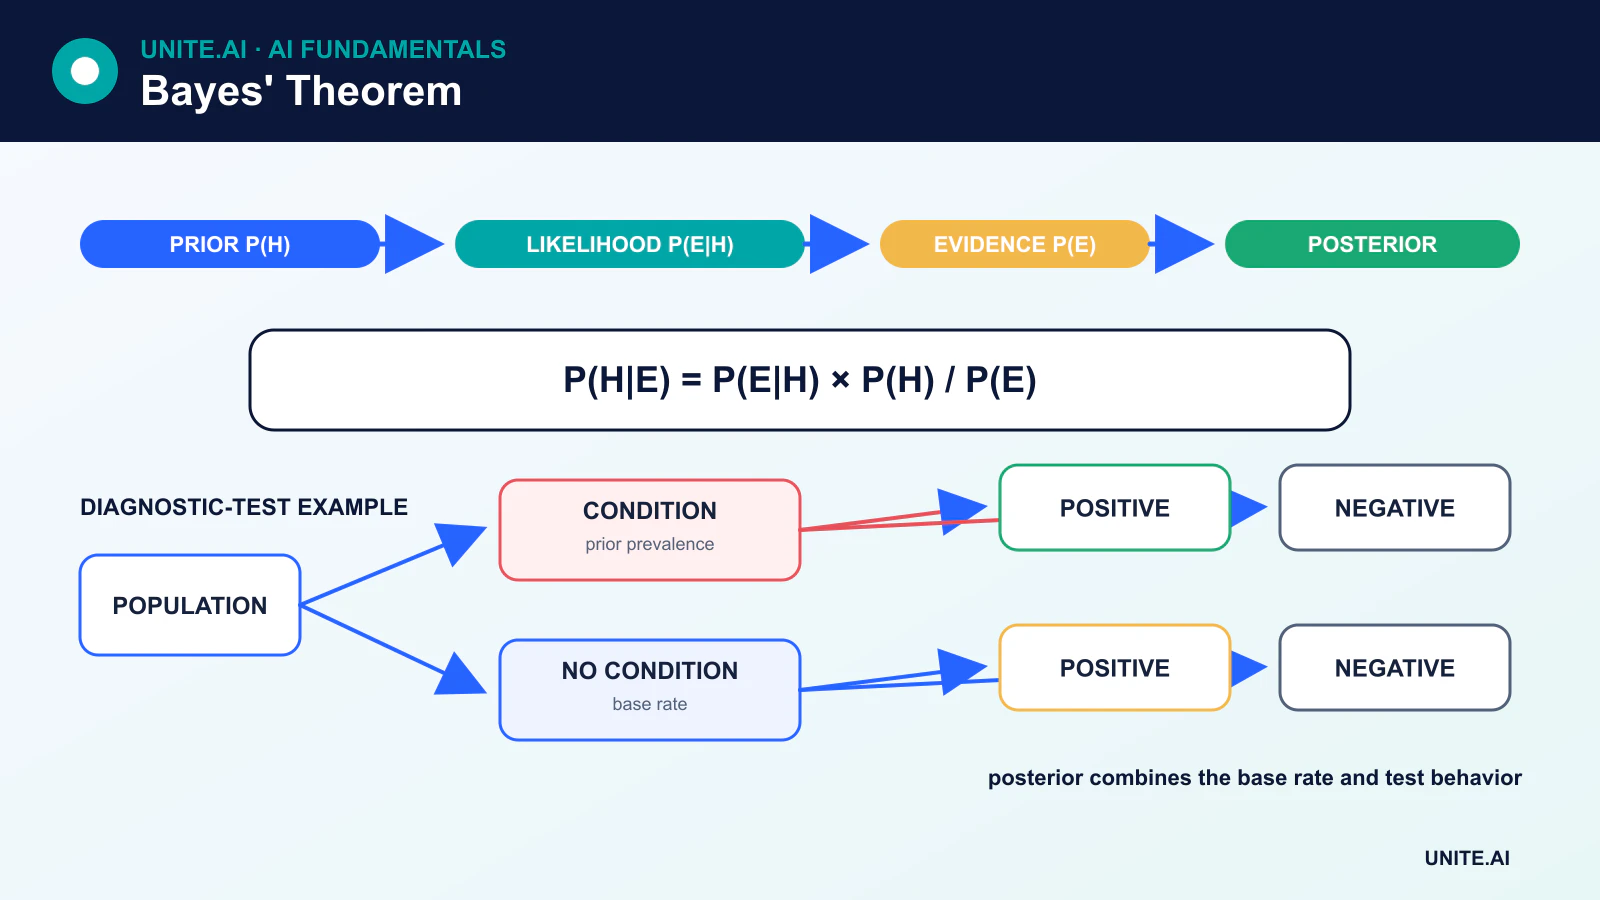
Formlen
P(A|B) = P(B|A)P(A) / P(B)
- P(A) er den forudgående sandsynlighed for hypotese A.
- P(B|A) er sandsynligheden for at observere bevis B, hvis A er sand.
- P(B) er den samlede sandsynlighed for beviset.
- P(A|B) er den posterior sandsynlighed for A efter at have observeret B.
Teoremet følger af to ækvivalente udtryk for fælles sandsynlighed: P(A ∩ B) = P(B|A)P(A) og P(A ∩ B) = P(A|B)P(B).
Et numerisk grundratereksempel
Antag, at en tilstand påvirker 1 % af en befolkning. En test har 90 % sensitivitet og en falsk‑positiv rate på 5 %. Betragt 1.000 personer:
- Omtrent 10 har tilstanden; testen markerer korrekt 9.
- Omtrent 990 har den ikke; en falsk‑positiv rate på 5 % markerer cirka 50.
- Der er derfor omkring 59 positive resultater, hvoraf 9 er sande positive.
Sandsynligheden for tilstanden efter et positivt resultat er omkring 9 / 59 ≈ 15 %, ikke 90 %. Testens sensitivitet svarer på P(positiv | tilstand); brugeren vil typisk have P(tilstand | positiv). Bayes’ teorem forbinder dem ved hjælp af grundraten.
Bayesisk opdatering
Efterhånden som nye beviser ankommer, kan en posterior blive den forudgående for den næste opdatering. En fuldstændig Bayesisk model specificerer mulige hypoteser, forudgående fordelinger, en likelihood og den størrelse, der skal estimeres. Usikkerhed repræsenteres med en posterior fordeling i stedet for kun et punktestimat.
Den forudgående bør dokumenteres og testes for følsomhed. En svagt informativ forudgående kan regulere urealistiske værdier, mens en dårligt valgt stærk forudgående kan dominere begrænsede data.
Naive Bayes-klassifikatorer
Naive Bayes forudsiger en klasse y ud fra funktioner x₁ … xₙ ved hjælp af Bayes’ teorem og antagelsen:
P(x₁, …, xₙ | y) = Π P(xᵢ | y)
Funktionerne antages betinget uafhængige, når klassen er kendt. Dette er ofte urealistisk, men klassifikatoren kan fungere godt, når de resulterende klassescores stadig er brugbare.
Almindelige varianter
- Multinomial Naive Bayes modellerer tælle‑lignende funktioner og er almindelig i dokumentklassificering.
- Bernoulli Naive Bayes modellerer binær tilstedeværelse af funktioner.
- Gaussian Naive Bayes modellerer hver kontinuerlig funktion med en klasse‑betinget Gaussian‑fordeling.
- Categorical Naive Bayes modellerer diskrete kategorier.
Udglatning og numerisk stabilitet
Hvis en funktionsværdi aldrig forekommer med en klasse i træningen, kan et usmoothed sandsynlighedsestimat blive nul og eliminere hele produktet. Additiv eller Laplace‑lignende udglatning forhindrer dette. Implementeringer beregner log‑sandsynligheder, så multiplikation af mange små værdier bliver addition af stabile log‑værdier.
Sandsynligheder, scores og kalibrering
Naive Bayes‑sandsynlighedsoutput kan være dårligt kalibreret, fordi korrelerede funktioner effektivt tælles flere gange. En klassifikator kan rangere klasser godt, mens den overvurderer tilliden. Kalibrering bør evalueres på hold‑out‑data, når sandsynligheder driver beslutninger.
Bayes ud over Naive Bayes
Bayesisk inferens understøtter hierarkiske modeller, A/B‑tests, videnskabelig parameterestimering, prognoser, usikkerheds‑bevidste beslutninger og probabilistiske grafiske modeller. Approximate metoder såsom Markov‑kæde‑Monte‑Carlo og variational inference anvendes, når en posterior ikke kan beregnes i lukket form.
Almindelige ræsonnementfejl
- Forveksling af
P(A|B)medP(B|A). - Ignorering af en sjælden eller almindelig grundrate.
- Behandling af en forudgående som objektiv eller ubegrundet.
- Antagelse om, at en høj likelihood automatisk betyder en høj posterior.
- Fortolkning af en prædiktiv association som kausalitet.
Betinget sandsynlighed, odds og beviser
Bayes’ teorem relaterer sandsynligheden for en hypotese efter bevis til dens forudgående sandsynlighed, likelihood for at observere beviset under hypotesen og den samlede sandsynlighed for beviset. I odds‑form er posterior odds lig med forudgående odds multipliceret med en likelihood‑ratio. Dette adskiller, hvad der blev antaget før en test, fra hvor stærkt testen skelner mellem hypoteser. En test, der ser meget præcis ud, kan stadig producere mange falske positive, når tilstanden er sjælden, fordi grundraten indgår i posterioret.
Likelihood er en funktion af hypotesen for fast observeret data og bør ikke forveksles med sandsynligheden for hypotesen. Bevis‑normalisering summerer eller integrerer på tværs af konkurrerende hypoteser. Antagelser om betinget uafhængighed kan forenkle beregningen, som i Naive Bayes, men skal kontrolleres mod konsekvenser. Flere beviser kan ikke multipliceres som uafhængige, når de deler årsager eller duplikerer information. Den kausale retning betyder også noget: P(bevis|hypotese) er generelt ikke P(hypotese|bevis), den klassiske inverse‑sandsynlighedsfejl.
Modelvalg, beregning og beslutningsanvendelse
Bayesisk analyse specificerer en forudgående, en likelihood og en posterior‑prædiktiv fordeling. Forudgående kan indkode etableret viden, regulere små stikprøver eller være svagt informative; de bør begrundes og testes gennem følsomhedsanalyse. Konjugerede modeller giver analytiske opdateringer, mens Markov‑kæde‑Monte‑Carlo, variational inference og sekventielle metoder approximerer komplekse posteriorer. Diagnosticér konvergens, effektiv stikprøvestørrelse, approximationsfejl og plausibilitet af forudgående prædiktiver i stedet for blot at rapportere et posterior‑tal uden beregningskontrol.
En posterior‑sandsynlighed informerer, men vælger ikke handlingen i sig selv. Beslutninger kræver tab, gevinster, begrænsninger og tilgængelige alternativer. Evaluer probabilistiske modeller med kalibrering, korrekte scorings‑regler og posterior‑prædiktive tjek på nye data. Opdatér kun med beviser indsamlet under en modelleret proces; udvælgelses‑bias og datasæt‑skift kan ugyldiggøre likelihood. Kommunikér troværdige intervaller og antagelser uden at behandle dem som garanterede frekvens‑intervaller. Bayes’ teorem er eksakt sandsynlighedsalgebra, mens kvaliteten af en Bayesisk konklusion afhænger af den anvendte model og de leverede beviser.
Eksempel: fortolkning af en diagnostisk test
En test har 95 % sensitivitet og 90 % specificitet, men tilstanden påvirker kun 1 % af den screenede befolkning. For 10.000 personer forventes omkring 95 sande positive og 990 falske positive, hvilket giver en positiv prædiktiv værdi under 9 %. Bayes’ teorem gør grundrater‑effekten eksplicit. Beregningen angiver befolkning, test‑tærskel og usikkerhed i stedet for blot at reklamere for sensitiviteten som chancen for, at et positivt resultat er korrekt. Dette skel er også grundlæggende for omhyggelig data science.
Klinikere opdaterer sandsynligheden med yderligere beviser kun, når afhængighed mellem tests modelleres. En beslutningstærskel indregner skade ved overset sygdom, risiko ved bekræftende test, omkostninger og patientpræferencer. Kalibrering kontrolleres i den lokale befolkning, og ændringer i prævalens udløser revision. Posterior‑resultatet understøtter drøftelse og næste skridt; det erstatter ikke en bekræftende diagnose. Rapportering bruger naturlige frekvenser og følsomhedsanalyse, så patienter og praktikere kan se, hvordan konklusionen ændres under plausible antagelser.
Implementeringsbeviser og driftsklarhed
En produktionsbeslutning kræver mere end en vellykket demonstration. Definér de tiltænkte brugere, driftsmiljø, input, output, afhængigheder, ejer og konsekvensen af hver væsentlig fejl. Etablér en reproducerbar baseline og et versioneret evaluerings‑sæt før finjustering. Test almindelige tilfælde, grænsetilstande, fejl‑ eller manglende input, distributions‑skift, afhængigheds‑nedbrud, misbrug og de grupper eller miljøer, der sandsynligvis er underbetjent. Mål opgavens kvalitet sammen med kalibrering eller usikkerhed, latenstid, gennemløb, ressourceomkostninger, tilgængelighed, privatliv og sikkerhed. Registrér hver transformation og tærskel, så en uafhængig reviewer kan reproducere resultatet og skelne bevis fra en attraktiv prototype.
Før lancering, tildel myndighed for udgivelse, undtagelser, ændringer, rollback og pensionering. Brug en trinvis udrulning, bevar en sikker fallback, og verificér overvågning med bevidst injicerede fejl. Operativ telemetri bør afsløre input‑kvalitet, output‑adfærd, model‑ eller regel‑version, afhængigheds‑sundhed, menneskelige overstyringer og bekræftede resultater uden at indsamle unødvendige følsomme data. Definér alarm‑tærskler og en ansvarlig responder, gennemgå derefter real‑world‑beviser efter implementering i stedet for at antage, at offline‑præstationen vil bestå. Revurder, når datakilder, brugere, modeller, leverandører, politikker, hardware eller mål ændrer sig. Et vedligeholdt system kræver også dokumenteret genoprettelse, hændelses‑læring, sletnings‑ og opbevaringsprocedurer samt et klart punkt, hvor det skal deaktiveres eller udskiftes.
Ofte stillede spørgsmål
Hvad er forskellen mellem en likelihood og en sandsynlighed?
Med parametre fastlagt tildeler en model sandsynlighed til mulige data. Med observerede data fastlagt kan det samme udtryk betragtes som en likelihood‑funktion over mulige parameter‑værdier. Den numeriske formel kan være identisk, mens fortolkningen er forskellig.
Er Naive Bayes fuldstændig Bayesisk inferens?
Den bruger Bayes’ teorem til klassificering under en stærk betinget‑uafhængighedsmodel. Bredere Bayesisk inferens placerer fordelinger over ukendte størrelser og ræsonnerer med en posterior fordeling.
Primære referencer












