
Grundlæggende AI
Sådan bygger du en chatbot: Arkitektur, data, sikkerhed og evaluering

 Føj Unite.AI til dine foretrukne kilder på Google
En chatbot er en applikation, der modtager en besked, bestemmer hvad brugeren har brug for, og returnerer et svar via tekst eller tale. Moderne systemer kan kombinere regler, genfinding, klassifikatorer, transformere, værktøjer og store sprogmodeller i stedet for at stole på kun én model.
At bygge en brugbar chatbot er derfor et produkt‑ og systemproblem. Dialoglaget skal kobles til pålidelig viden og forretningshandlinger, mens identitet, tilladelser, logning, evaluering, fallback og menneskelig eskalation begrænser, hvad botten må gøre.
Vigtige konklusioner
- Start med en snæver brugeropgave og et målbare succes‑kriterium.
- Adskil sproggenerering fra genfinding, værktøjer, tilladelser og forretningsregler.
- Test komplette samtaler, inklusive tvetydighed, afbrydelse, afvisning og genopretning.
- Behandl prompts og modeloutput som upålidelige data; overvåg produktionen og bevar eskaleringsveje.
Definér opgaven, før du vælger en model
Noter, hvem brugeren er, hvad de forsøger at opnå, hvilke data systemet kan få adgang til, og hvilke handlinger der kræver bekræftelse. En FAQ‑bot, en ordre‑status‑assistent og en konto‑administrationsagent har meget forskellige risikoprofiler.
Opret et ikke‑AI‑baseline og et accept‑sæt af repræsentative samtaler. Mål opgave‑fuldførelse, svar‑støtte, latency, afbrydelse, eskalation og omkostningerne ved skadelige fejl. En flydende demo er ikke bevis på, at arbejdsflowet fungerer pålideligt.
Brug en lagdelt arkitektur
En typisk pipeline indeholder en kanal‑adapter, sessions‑status, input‑validering, intention‑ eller routing‑logik, genfinding, en svar‑ eller politik‑model, værktøjs‑adaptere og overvågningsfunktioner. Genfinding kan forankre svar i godkendte dokumenter; værktøjer udfører kontrollerede handlinger via eksplicitte skemaer.
Hold deterministiske kontroller uden for sprogmodellen. Godkendelse, autorisation, lager‑grænser, refusioner og irreversible handlinger bør håndhæves af applikationskode. Prompt‑engineering kan forme adfærd, men er ikke et adgangskontrolsystem.
Design dialog, viden og genopretning sammen
Gode samtaler håndterer ufuldstændige forespørgsler, korrektioner, flere intentioner og referencer til tidligere udvekslinger. Gem kun den kontekst, der er nødvendig for opgaven, gør opbevaring synlig, og skel mellem en brugerudsagn og et pålideligt faktum returneret af et godkendt system.
Når tillid eller bevismateriale er utilstrækkeligt, bør botten stille et fokuseret spørgsmål, tilbyde et sikkert alternativ eller overføre til en person med et kort resumé. Genopretning er en del af kerneoplevelsen – ikke et sjældent tilfælde, der tilføjes efter lancering.
Evaluer og drift hele systemet
Test genfindingskvalitet, værktøjsvalg, argument‑nøjagtighed, politik‑overholdelse, modstand mod prompt‑injektion, privatlivs‑lækager og ende‑til‑ende‑resultater. Udfør red‑team‑adversarielle input og bekræft, at et ondsindet dokument ikke kan stille sig over systeminstruktioner uden at blive bemærket.
Versionér prompts, indekser, modeller, politikker og værktøjer. Gennemgå udvalgte samtaler med privatlivskontroller, hold øje med drift og fejl‑klynger, og oprethold rollback. Denne operationelle disciplin knytter chatbot‑udvikling til AIOps og hændelsesrespons.
Kerne‑chatbot‑komponenter i mere detaljeret
Kanal‑laget normaliserer input fra web‑chat, mobil‑apps, besked‑platforme eller tale. Et sessions‑lag knytter beskeder til en autentificeret eller anonym samtale, håndhæver udløb, og gemmer kun den status, der er nødvendig for opgaven. Input‑kontroller begrænser størrelse og filtyper, opdager usikre payloads og fjerner markup, som nedstrøms systemer ikke bør udføre.
En router beslutter derefter, om anmodningen hører til en deterministisk flow, søgning, generering eller en menneskelig kø. Klassiske intention‑klassifikatorer forbliver nyttige, når etikett‑sættet er stabilt; sprogmodeller er mere fleksible men sværere at kalibrere. Hybrid‑routere kan reservere regulerede eller høj‑volumen‑opgaver til testede arbejdsflow og bruge en generel model til åbne forklaringer.
Svar‑laget bør bære beviser og tilstand separat. En genereret sætning kan citere et hentet afsnit, men applikationen skal bevare, hvilken kilde og version der understøttede det. Samtale‑hukommelse bør skelne bruger‑præferencer fra verificerede kontodata og må aldrig tillade en tidligere bruger‑besked at give nye tilladelser.
Genfinding, værktøjer og transaktioner
Genfindingskvalitet starter før vektorsøgning. Dokumenter kræver ejerskab, adgangs‑etiketter, kanoniske versioner, brugbare segmenter og fjernelses‑datoer. Forespørgsels‑omskrivning, nøgleords‑søgning, indlejringer, filtre og om‑rangering kan kombineres. Evaluering bør måle, om de nødvendige beviser blev hentet, om irrelevante afsnit blev ekskluderet, og om svaret faktisk følger beviserne.
Værktøjer konverterer et model‑forslag til en typet anmodning til applikationskoden. Hvert værktøj kræver et snævert formål, et eksplicit skema, server‑side validering, mindst‑privilegerede legitimationsoplysninger, tids‑grænser, idempotens hvor muligt, og et klart resultat. Modellen bør ikke konstruere rå database‑forespørgsler eller vilkårlige URL’er, når en afgrænset forretningsoperation kan eksponeres i stedet.
Transaktioner kræver bekræftelse på forpligtelsens tidspunkt. Vis brugeren de relevante felter – modtager, beløb, adresse, dato eller adgangsændring – og behandle ikke et gammelt ‘ja’ som godkendelse af en ny handling. For flerstegs‑arbejde, hold en tilstandsmaskine uden for modellen, så et genforsøg eller omarrangeret besked ikke kan springe et påkrævet gate over.
En praktisk bygge‑ og evalueringsplan
Start med tyve til halvtreds repræsentative opgaver og inkludér mislykkede, tvetydige og uden for scope‑forespørgsler. Marker den forventede handling, bevis, eskalation og forbudt adfærd. Implementer det simpleste levedygtige flow, og tilføj derefter genfinding eller generering kun hvor det forbedrer et målt resultat. Dette skaber en genanvendelig regressions‑suite, før grænsefladen bliver kompleks.
Evaluer komponenter og samtaler separat. Genfindings‑målinger, værktøj‑kald‑nøjagtighed, politik‑kontroller og svar‑støtte diagnosticerer specifikke fejl; opgave‑fuldførelse og bruger‑indsats afslører kvalitet på systemniveau. Brug flertur‑tests, der korrigerer tidligere detaljer, afbryder et flow, skifter emne, tilbageholder påkrævet information, og udløser afhængigheds‑fejl.
Produktions‑udrulning bør ske i faser efter brugergruppe, opgave og tilladelse. Overvåg ikke‑understøttede påstande, gentagne afklaringer, værktøjs‑afvisning, eskalation, latency og afbrydelse. Gennemgå privatlivs‑sikre eksempler, vedligehold en nød‑deaktiverings‑sti for hvert værktøj, og brug hændelses‑fund til at opdatere prompts, data, kode og test‑sættet samlet.
Eksempel: en support‑chatbot fra prototype til produktion
Antag, at en forhandler ønsker en chatbot, der besvarer spørgsmål om ordre og returnering. Definér understøttede intentioner, eskalations‑betingelser, godkendt viden, autentificeringsregler og forbudte handlinger først. Byg et testsæt ud fra anonymiserede historiske spørgsmål, inklusiv vage forespørgsler, stavefejl, flersproget input, vrede brugere, prompt‑injektion og spørgsmål uden svar. Et genfindings‑baseline skal returnere beviser, før nogen generativt svar får lov til at påstå politik‑ eller ordre‑status.
Kørslen kan klassificere intention, hente politik‑afsnit, anmode om identitets‑verifikation kun når kontodata er nødvendige, kalde et snævert afgrænset ordre‑API, sammensætte et svar og vedhæfte kildehenvisninger. Hvert værktøjs‑kald kræver et eksplicit skema, autorisations‑kontrol, timeout, gen‑forsøgs‑politik og en idempotens‑nøgle. Modellen bør aldrig konstruere rå database‑forespørgsler eller bestemme sine egne tilladelser. Høj‑impact‑handlinger såsom annullering eller refusioner kræver bekræftelse og, over de fastsatte grænser, menneskelig godkendelse.
Evaluer intention‑nøjagtighed, svar‑korrekthed, bevis‑støtte, afvisnings‑kvalitet, succesfuld indeholdelse, eskalations‑præcision, latency og omkostning pr. løst samtale. Gennemgå resultater efter intention og bruger‑gruppe i stedet for et samlet gennemsnit. I produktion, log consent‑bevidste spor, værktøjs‑resultater, hentede dokuments‑versioner og bruger‑korrektioner. Udrul gradvist, sammenlign med den eksisterende kanal, og deaktiver funktioner når fejl‑, misbrugs‑ eller afhængigheds‑tærskler overskrides.
Praktisk implementerings‑tjekliste
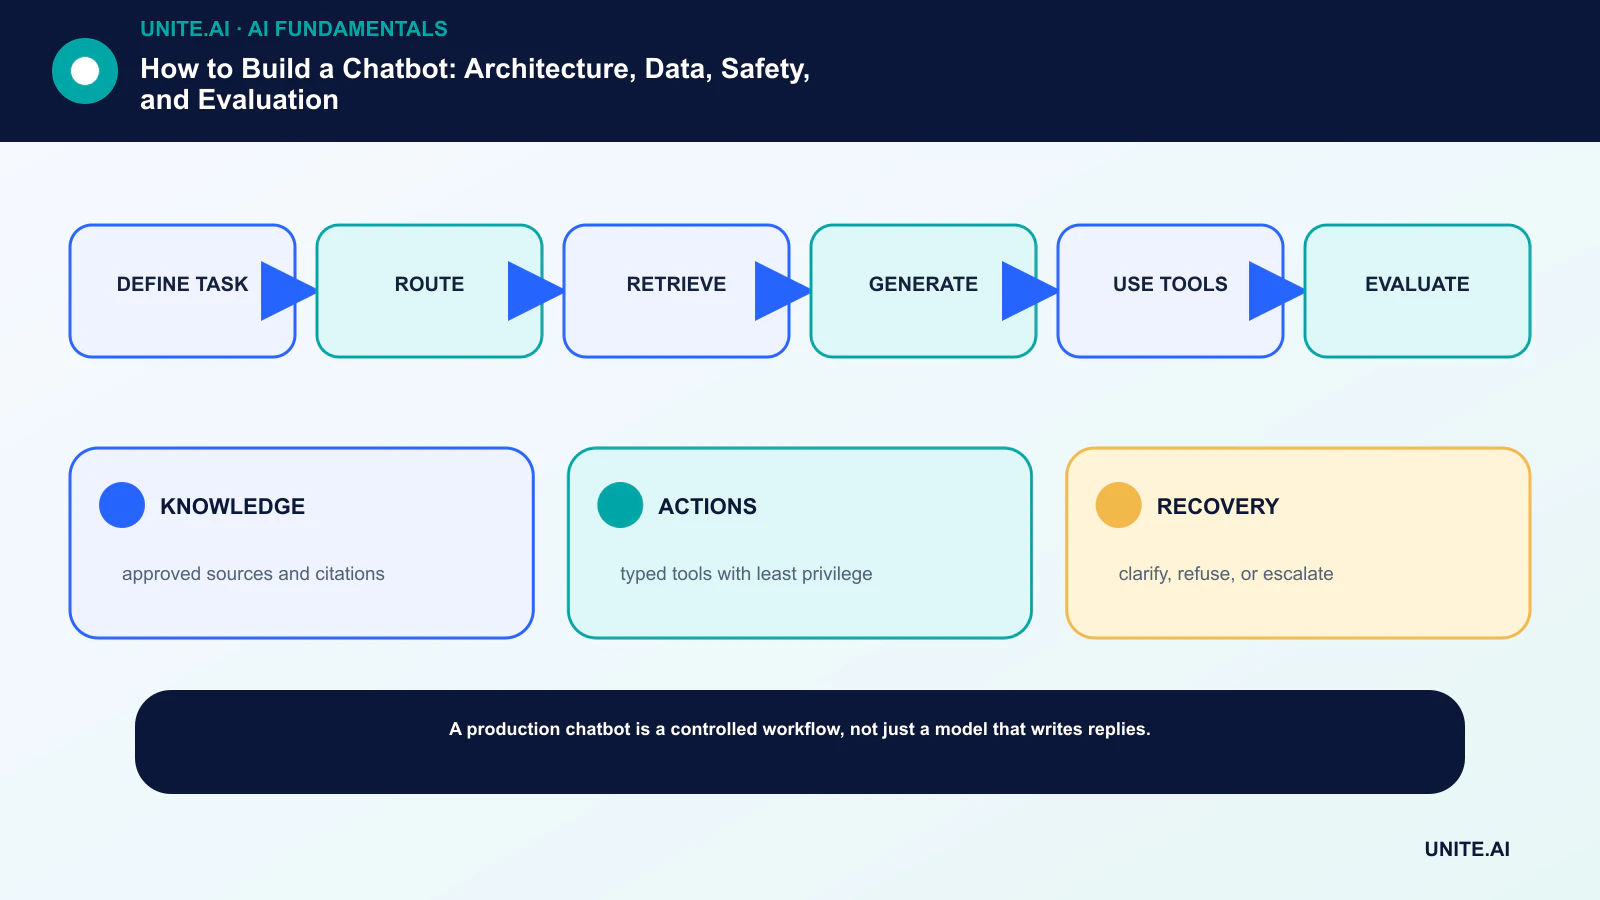
Omform konceptet til et afgrænset, testbart arbejdsflow: definér opgave → route → genfind → generér → brug værktøjer → evaluer. Navngiv en ansvarlig ejer, dokumentér data og afhængigheder, etabler et simpelt baseline, fastsæt accept‑ og stop‑kriterier, test repræsentative fejl, og definér overvågning, rollback og gennemgang før udvidelse af omfanget. Registrér versioner og antagelser, så et andet team kan reproducere resultatet og forstå, hvad der ændrede sig.
Før lancering, udfør en dokumenteret beredskabs‑gennemgang med de personer, der bygger, driver, sikrer og påvirkes af systemet. Test normale tilfælde, rand‑betingelser, afhængigheds‑fejl og misbrug; bevar beviserne og uløste risici. Definér hvem der kan godkende frigivelse, ændre en tærskel, overtrumfe et output eller stoppe driften. Genovervej beslutningen efter at virkelige data ankommer, da en teknisk succesfuld pilot ikke garanterer pålidelig ydeevne i større skala.
- VIDEN: godkendte kilder og kildehenvisninger.
- HANDLINGER: typede værktøjer med mindst privilegium.
- GENOPRETNING: afklar, afvis eller eskaler.
Ofte stillede spørgsmål
Behøver en chatbot en stor sprogmodel?
Nej. Regler, søgning, formularer og små klassifikatorer kan være sikrere og billigere for snævre opgaver. En LLM er nyttig, når fleksibel sprogforståelse eller -generering giver målbar værdi.
Hvad bør testes inden lancering?
Repræsentative opgaver, ikke‑understøttede forespørgsler, tvetydigt sprog, værktøjs‑fejl, privatlivs‑grænser, modstandskraft mod ondsindede prompts, menneskelig overdragelse, latency og nøjagtigheden af hver konsekvent handling.
Primære referencer












