
Grundlæggende AI
Hvad er samtalebaseret talegenkendelse (CSR)?

 Føj Unite.AI til dine foretrukne kilder på Google
Samtalebaseret talegenkendelse (CSR) udvider automatisk talegenkendelse ud over isoleret transskription ved at benytte dialogkontekst, signaler om turtagning, talerinformation og lav‑latens behandling. Målet er at understøtte en live‑interaktion, hvor ord, timing, afbrydelser og tidligere ture alle er vigtige.
CSR er en fremvoksende produkt‑ og forskningsbetegnelse, ikke en enkelt standardiseret modelklasse. Et stærkt system kombinerer streaming‑ASR med endpoint‑detektion, håndtering af talere, kontekstuel sprogmodellering, dialogtilstand og en svarpolitik, hvorefter oplevelsen evalueres fra ende til ende.
Vigtige pointer
- Streaming‑genkendelse udsender foreløbige hypoteser og reviderer dem, efterhånden som mere lyd ankommer.
- Endpoint‑detektion og tur‑forudsigelse er adskilt fra transskriptionsnøjagtighed.
- Samtalehistorik og hotwords kan forbedre genkendelsen, men kan også viderebringe tidligere fejl.
- Evaluer latens, afbrydelser, talere, accenter, støj, privatliv og opgavefuldførelse – ikke kun ordfejlrate.
Fra ASR til live‑dialog
Traditionel ASR kortlægger lyd til tekst. Et samtalesystem skal afgøre, hvornår det skal lytte, hvornår en tur er afsluttet, om tale er rettet mod systemet, og hvordan det skal genoprette, når transskriptionen eller svaret er forkert.
Streaming‑modeller behandler rammer inkrementelt og producerer delvise transskriptioner. Lav latens forbedrer responsen, men for tidlig forpligtelse kan øge revisioner eller fejl. Applikationen har brug for en politik for stabilt versus foreløbigt tekst.
Turtagning, overlapp og talere
Kun varigheden af stilhed er et svagt endpoint‑signal. Lexikalisk færdiggørelse, prosodi, timing, blik og dialogtilstand kan hjælpe med at forudsige, om en person holder eller giver pladsen fra sig. Barge‑in giver en bruger mulighed for at afbryde syntetiseret tale uden at miste kontekst.
Overlappende stemmer og diarisation er stadig udfordrende. Systemer bør bevare usikkerhed omkring taleren, undgå at tilskrive en udtalelse til den forkerte person og give en korrigeringsvej – især for optegnelser brugt i sundhedssektoren, finans eller juridisk arbejde.
Kontekstuel genkendelse
Tidligere ture kan afklare navne og referencer; hotword‑lister kan påvirke genkendelsen mod domænetermer. Tale‑sprog‑modeller kan indkode lyd‑ og tekstkontekst i en fælles prompt‑ eller opmærksomhedsramme.
Kontekst kan også forstærke en fejlagtig tidligere transskription eller lække information mellem sessioner. Begræns historikken til det aktuelle formål, adskil betroet metadata fra brugerens tale, og brug transformer-kontekst med eksplicitte opbevarings‑ og adgangsregler.
Evaluering og ansvarlig implementering
Rapporter streaming‑ordfejlrate, første‑token‑ og færdiggørelses‑latens, revisionsrate, endpoint‑fejl, barge‑in‑succes, taler‑attribuering og opgavefuldførelse. Test med rigtige mikrofoner, støj, accenter, kode‑skift, handicap og følelsesmæssigt ladet tale.
Stemmedata kan identificere eller afsløre følsomme oplysninger. Anvend samtykke, minimalisering, kryptering, opbevaringsgrænser og menneskelig gennemgang. Forbind genererede svar til chatbot-sikkerhedskontroller, fordi præcis transskription ikke gør et svar korrekt eller autoriseret.
Fra akustisk input til samtaletilstand
Et samtalesystem for tale indsamler lyd, anvender signalbehandling, opdager tale, genkender ord eller semantiske enheder, identificerer talere efter behov og opdaterer dialogtilstanden. Streaming‑systemer producerer delvise hypoteser før en ytring slutter. Disse hypoteser kan ændre sig, så efterfølgende komponenter skal skelne mellem foreløbige og endelige resultater.
Tale‑aktivitet‑detektion og endpoint‑detektion afgør, hvornår tale starter og hvornår brugeren er færdig. Faste stilhedstærskler fejler ved langsomme talere, baggrundsstøj og tænke‑pauser. Turtagnings‑modeller kan bruge ord, prosodi, blik og dialogkontekst, men de skal afbalancere hurtig respons mod at afbryde taleren.
Diarisation svarer på, hvem der talte hvornår; taler‑genkendelse estimerer identitet; kilde‑separation isolerer overlappende stemmer. Dette er forskellige opgaver med forskellige risici. I møder, sundhedssektoren og kundeservice kan det at tilskrive de rigtige ord til den rigtige person være lige så vigtigt som transskriptionens ordfejlrate.
Kontekst, overlapp, følelser og interaktionsgenopretning
Samtalekontekst løser pronomener, ellipser, rettelser, domænetermer og referencer til tidligere ture. Et system kan kombinere akustisk evidens med dialoghistorik og hentet viden, men tidligere kontekst kan også påvirke genkendelsen mod en forkert forventning. Bevar lyd‑evidens og sikkerhed, så kontekst ikke tavst overskriver usikkerhed.
Naturlig dialog inkluderer backchannels, afbrydelser, falske starter, latter, kode‑skift og simultan tale. En responsiv agent har brug for barge‑in‑håndtering: stoppe eller dæmpe sit output, indfange brugerens nye tale, afgøre om afbrydelsen ændrer intentionen, og genoprette uden at duplikere eller miste en handling.
Prosodi og paralingvistiske signaler kan indikere betoning eller usikkerhed, men at udlede følelser, helbred eller intention fra stemme er fejlbehæftet og kulturelt afhængigt. Brug sådanne estimater konservativt, gør dem tydelige hvor det er passende, og træf ikke væsentlige beslutninger baseret på en uvalideret følelsesmærkat.
Evaluering, privatliv og produktionsdesign
Ordfejlrate forbliver nyttig, men samtale‑evaluering bør også måle taler‑attribuering, entitets‑nøjagtighed, semantisk opgave‑succes, stabilitet af delvise hypoteser, endpoint‑latens, afbrydelses‑succes, genopretning og bruger‑korrektionsrate. Segmentér efter accent, sprog, enhed, støj, overlapp, talestil og netværksforhold.
Streaming‑arkitektur kræver afgrænsede buffere, back‑pressure, genforbindelse, sekvensnumre og eksplicit færdiggørelse. Hold model‑ og dialog‑latensbudgetter adskilt, spor hver fase, og test forringede netværk. Når et system udløser handlinger, bekræft høj‑impact intention og gør genforsøg idempotente, så gentagen lyd eller genforbindelser ikke duplikerer transaktioner.
Tale indeholder identitet, indhold, miljø‑ og tilskuereinformation. Minimér opbevaring, krypter transport og lagring, kontroller adgang, definer sletning, og adskil lyd fra afledte transskriptioner og indlejringer. Giv synlige optagelsesindikatorer og alternativer, når samtykke mangler. En lokal model kan reducere overførsel, men kræver stadig tilladelse og livscyklus‑kontrol.
Praktisk eksempel: en stemmeagent der håndterer afbrydelse og korrektion
En opkalder siger, ‘Book tirsdag – nej, onsdag eftermiddag,’ mens agenten begynder at svare efter ‘tirsdag.’ Streaming‑genkendelse udsender skiftende delvise transskriptioner, endpoint‑detektion registrerer fortsat tale, og barge‑in stopper output. Dialogtilstanden markerer den tidligere dato som overhalet i stedet for at oprette to anmodninger. Entitets‑bekræftelse fokuserer på den korrigerede dato og tid, mens systemet bevarer sikkerhed og evidens for den endelige fortolkning.
Arkitekturen adskiller lydoptagelse, tale‑detektion, streaming‑genkendelse, taler‑håndtering, dialogpolitik, værktøjs‑eksekvering og syntese. Sekvensnumre og færdiggørelse forhindrer sene delvise resultater i at overskrive den endelige transskription. Booking‑værktøjet accepterer en struktureret anmodning, tjekker autorisation og tilgængelighed og bruger en idempotens‑nøgle. En væsentlig booking læses tilbage og bekræftes før udførelse; en genforbindelse kan ikke tavst gentage den.
Testning kombinerer ord‑ og entitets‑nøjagtighed med endpoint‑latens, afbrydelses‑succes, korrektion‑håndtering, taler‑attribuering, opgavefuldførelse og duplikat‑handlingsrate. Scenarier dækker støj, overlapp, accenter, kode‑skift, langsom tale, hjælpeteknologier, svage netværk og syntetiske angreb. Lyd‑opbevaring minimeres og offentliggøres, tilskuerdata håndteres eksplicit, og brugere kan skifte til tekst eller en menneskelig assistent. Samtale‑intelligens måles på sikker genopretning og resultat, ikke kun transskript‑nøjagtighed.
Praktisk implementerings‑tjekliste
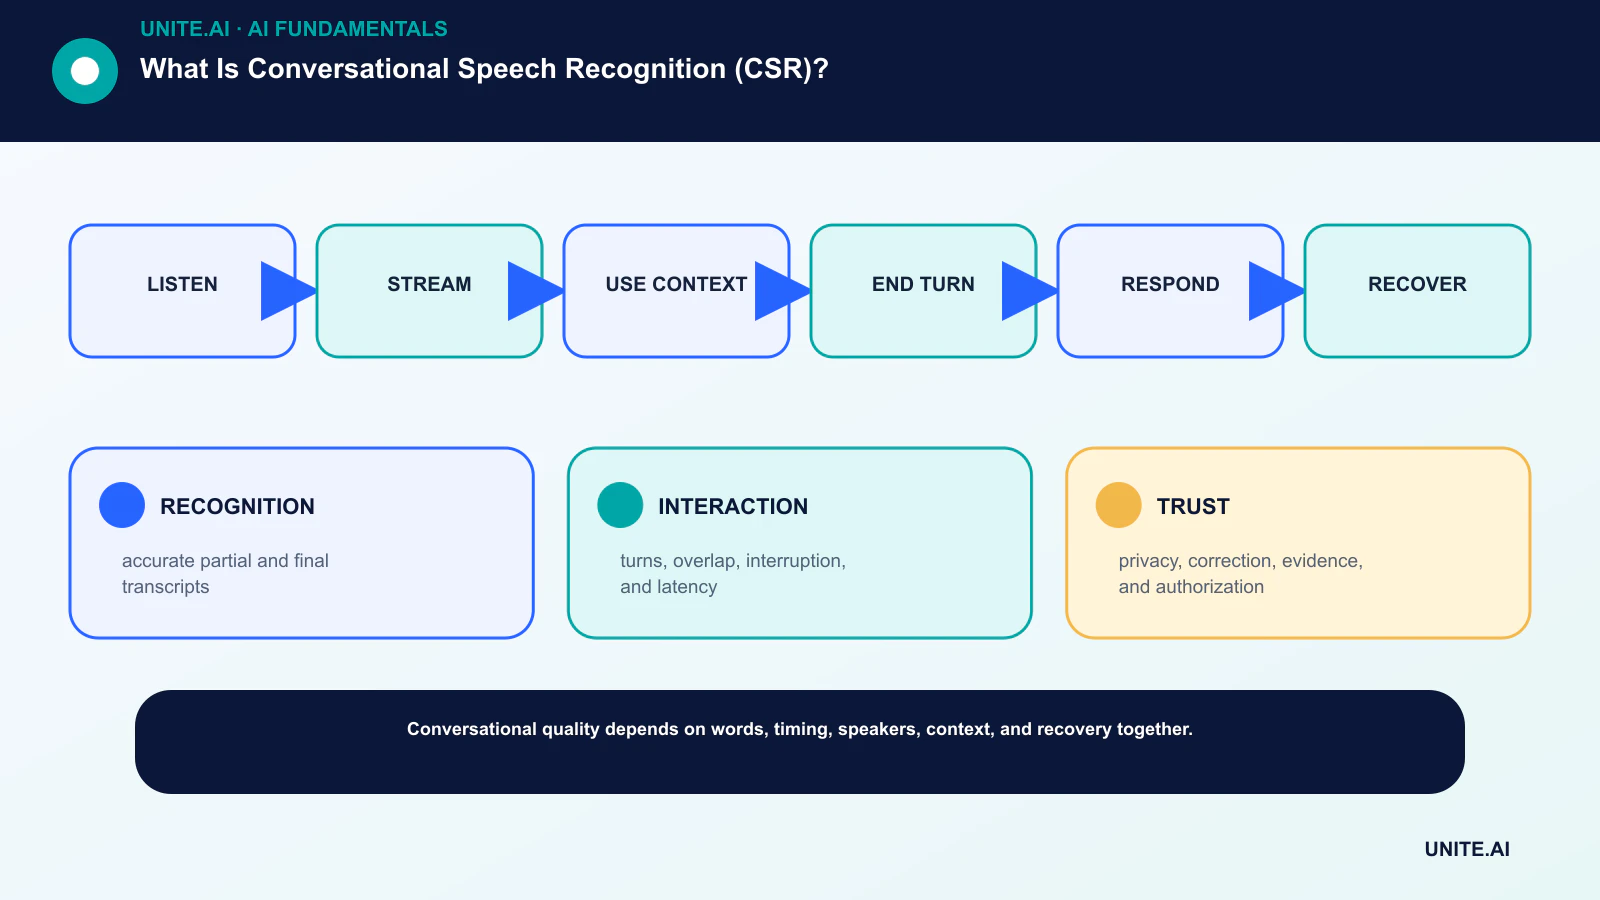
Omform konceptet til en afgrænset, testbar arbejdsgang: lyt → stream → brug kontekst → afslut tur → svar → genopret. Navngiv en ansvarlig ejer, dokumentér data og afhængigheder, etabler en simpel baseline, fastsæt accept‑ og stop‑kriterier, test repræsentative fejl, og definér overvågning, rollback og gennemgang inden udvidelse af omfanget. Registrér versioner og antagelser, så et andet team kan reproducere resultatet og forstå, hvad der ændrede sig.
Før lancering skal der gennemføres en dokumenteret beredskabs‑gennemgang med de personer, der bygger, driver, sikrer og påvirkes af systemet. Test normale tilfælde, grænsetilstande, afhængigheds‑fejl og misbrug; bevar evidens og uafklarede risici. Definér hvem der kan godkende frigivelse, ændre en tærskel, tilsidesætte et output eller stoppe driften. Genovervej beslutningen, når data fra den virkelige verden ankommer, fordi en teknisk succesfuld pilot ikke garanterer pålidelig ydeevne i større skala.
- GENKENDELSE: nøjagtige delvise og endelige transskriptioner.
- INTERAKTION: ture, overlapp, afbrydelse og latens.
- TILLID: privatliv, korrektion, evidens og autorisation.
Ofte stillede spørgsmål
Er CSR anderledes end ASR?
ASR er tale‑til‑tekst‑komponenten. CSR bruger ASR plus dialogkontekst, timing, taler‑ og endpoint‑håndtering samt interaktionspolitikker for live‑samtaler.
Garanterer en lavere ordfejlrate en bedre stemmeagent?
Nej. Et system kan transskribere præcist, men alligevel afbryde brugere, svare langsomt, fejlagtigt tilskrive talere eller udføre den forkerte handling. End‑to‑end‑interaktionsmålinger er påkrævet.
Primære referencer












