
Rozhovory
Xavier Conort, spoluzakladatel a produktový ředitel FeatureByte – Série rozhovorů

 Přidejte Unite.AI mezi své preferované zdroje na Google
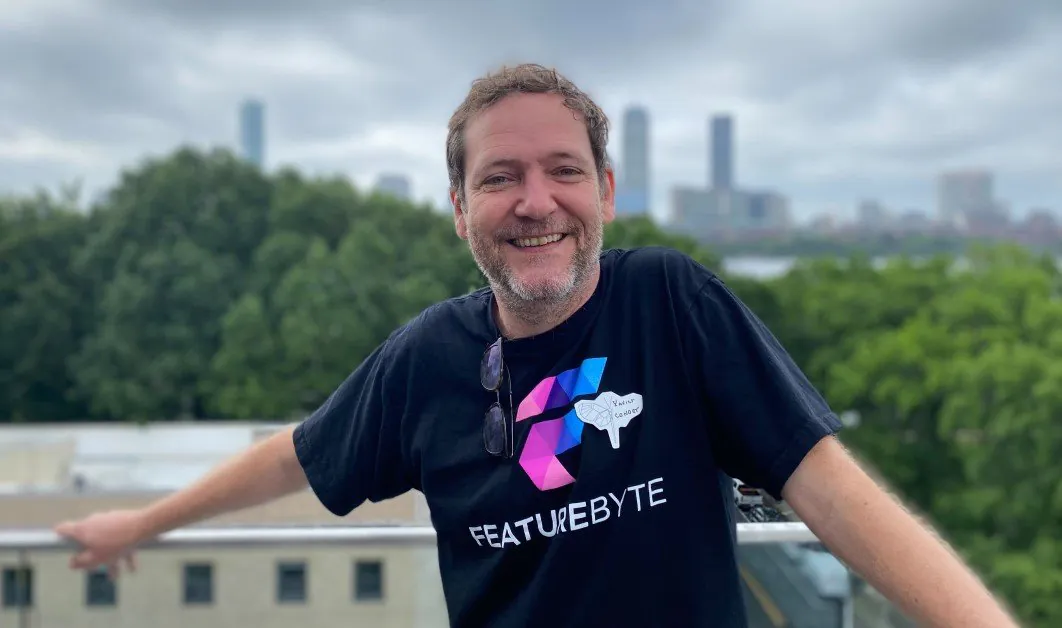
Xavier Conort je vizionářský datový vědec s více než 25 lety zkušeností s daty. Začal svou kariéru jako aktuár v pojišťovacím průmyslu, než přešel do datové vědy. Je špičkovým soutěžícím na Kaggle a byl hlavním datovým vědcem v DataRobot, než se stal spoluzakladatelem FeatureByte.
FeatureByte má za cíl rozšiřovat podnikovou AI tím, že radikálně zjednoduší a industrializuje AI data. Platforma pro tvorbu a správu příznaků umožňuje datovým vědcům vytvářet a sdílet pokročilé příznaky a datové toky připravené pro produkční provoz během několika minut – místo týdnů nebo měsíců.
Začali jste svou kariéru jako aktuár v pojišťovacím průmyslu, než jste přešli do datové vědy, co způsobilo tuto změnu?
Definujícím okamžikem byla výhra v soutěži GE Flight Quest, kterou pořádala společnost GE a jejíž celková finanční odměna činila 250 000 dolarů. V ní účastníci museli předpovědět zpoždění domácích letů v USA. Částečně jsem této výhry dosáhl díky cenné praxi v pojišťovnictví: dvoufázovému modelování. Tento přístup pomáhá kontrolovat zkreslení v příznacích, které postrádají dostatečné zastoupení v dostupných trénovacích datech. Kromě dalších výher na Kaggle mě tato výhra přesvědčila, že mi mé zkušenosti pojistného matematika poskytují konkurenční výhodu v oblasti datové vědy.
Během své cesty na Kaggle jsem také měl možnost spojit se s dalšími nadšenci pro datovou vědu, včetně Jeremyho Achina a Toma De Godoye, kteří později založili DataRobot. Sdíleli jsme společné zázemí v pojišťovnictví a dosáhli jsme pozoruhodných úspěchů na Kaggle. Když nakonec spustili DataRobot, společnost specializující se na AutoML, pozvali mě, abych se k nim připojil jako hlavní datový vědec. Jejich vize spojení nejlepších praktik z pojišťovnictví s mocí strojového učení mě nadchla, protože to představovalo příležitost vytvořit něco inovativního a významného.
V DataRobot jste sehrál klíčovou roli při vytváření plánu rozvoje datové vědy. Jakým problémům s daty jste čelil?
Největší výzvou, které jsme čelili, byla proměnlivá kvalita dat, která byla poskytována jako vstup do našeho AutoML řešení. Tento problém často vedl k časově náročné spolupráci mezi našim týmem a klienty nebo k zklamáním výsledků v produkci, pokud nebyla tato otázka řešena vhodně. Problémy s kvalitou dat pocházely z více zdrojů, které vyžadovaly naši pozornost.
Jednou z hlavních výzev byla běžné používání nástrojů pro obchodní inteligenci pro přípravu a správu dat. Zatímco tyto nástroje jsou cenné pro generování přehledů, postrádají schopnosti, které jsou nezbytné pro zajištění časové správnosti dat pro přípravu dat pro strojové učení. V důsledku toho mohlo dojít k průniku informací z budoucnosti do trénovacích dat, což vedlo k přeučení a nesprávnému výkonu modelu.
Další výzvou byla nedostatečná komunikace mezi datovými vědci a datovými inženýry, která ovlivňovala přesnost modelů v produkčním provozu. Nesoulad mezi těmito týmy mohl způsobovat rozdíly mezi trénovací a produkční fází, a tím zhoršovat výkon modelu v reálném prostředí.
Jaké byly některé z hlavních poznatků z této zkušenosti?
Má zkušenost v DataRobot upozornila na význam příprav dat pro strojové učení. Řešením problémů s přípravou dat pro strojové učení, jako je časová správnost dat, mezery v odborných znalostech, doménové znalosti, omezení nástrojů a škálovatelnost, můžeme zlepšit přesnost a spolehlivost modelů strojového učení. Došel jsem k závěru, že zjednodušení procesu přípravy dat a začlenění inovativních technologií sehraje klíčovou roli při odemknutí plného potenciálu AI a splnění jeho slibů.
Také jsme slyšeli od vašeho spoluzakladatele Razi Raziuddina o původu FeatureByte, mohli byste nám říci svou verzi událostí?
Když jsem diskutoval o svých pozorováních a poznatcích s mým spoluzakladatelem Razi Raziuddinem, uvědomili jsme si, že sdílíme společné pochopení problémů v přípravě dat pro strojové učení. Během našich diskusí jsem sdílel s Razim své poznatky o nedávných pokrocích v komunitě MLOps. Pozoroval jsem vznik úložišť příznaků a platforem pro práci s příznaky, které technologické firmy zaměřené primárně na AI zaváděly ke snížení prodlev při poskytování příznaků, podpoře jejich opakovaného použití a zjednodušení jejich materializace do trénovacích dat při zachování konzistence mezi trénováním a produkčním poskytováním. Nicméně, bylo zřejmé, že stále existuje mezera ve splnění potřeb datových vědců. Razi sdílel se mnou své poznatky o tom, jak moderní technologické zázemí pro práci s daty revolucionizoval obchodní inteligenci a analytiku, ale není plně využíván pro AI.
Oběma nám bylo jasné, že můžeme významně pomoci radikálním zjednodušením tvorby příznaků a poskytnutím vhodných nástrojů a uživatelského prostředí datovým vědcům a inženýrům strojového učení pro plynulé experimentování s příznaky a jejich poskytování modelům.
Jaké byly některé z vašich největších výzev při přechodu z datové vědy na podnikání?
Přechod z datové vědy na podnikání vyžadoval, abych změnil svůj pohled z technického na širší, obchodně orientovaný. Zatímco jsem měl silný základ pro pochopení bolestivých míst, vytváření roadmap, provádění plánů, budování týmu a správu rozpočtů, zjistil jsem, že vytváření správného sdělení, které skutečně rezonuje s našimi cílovými uživateli, bylo jednou z mých největších překážek.
Jako datový vědec jsem se vždy soustředil především na analýzu a interpretaci dat s cílem získat cenné poznatky. Jako podnikatel jsem však musel své uvažování přesměrovat k trhu, zákazníkům a podnikání jako celku.
Naštěstí jsem tuto výzvu dokázal překonat díky zkušenostem svého spoluzakladatele Raziho.
Slyšeli jsme od Raziho o tom, proč je feature engineering tak obtížný, z vašeho pohledu, co ho činí tak náročným?
Feature engineering má dvě hlavní výzvy:
- Přeměna existujících sloupců: To zahrnuje převod dat do vhodného formátu pro algoritmy strojového učení. Používají se techniky, jako je one-hot encoding, škálování příznaků a pokročilé metody, jako je transformace textu a obrázků. Vytváření nových příznaků z existujících, například interakčních příznaků, může výrazně zlepšit výkon modelu. Populární knihovny, jako je scikit-learn a Hugging Face, poskytují rozsáhlou podporu pro tento typ feature engineeringu. Řešení AutoML také usilují o zjednodušení tohoto procesu.
- Extrahování nových sloupců z historických dat: Historická data jsou zásadní v problémech, jako jsou systémy doporučení, marketing, detekce podvodů, stanovení pojistného a hodnocení úvěrového rizika, předpověď poptávky a zpracování dat ze senzorů. Extrahování informativních sloupců z těchto dat je náročné. Příklady zahrnují dobu od poslední události, agregace nad nedávnými událostmi a vektorové reprezentace posloupností událostí. Tento typ feature engineeringu vyžaduje odborné znalosti, experimentování, silné kodovací a datové inženýrské dovednosti a hluboké znalosti datové vědy. Faktory, jako je únik informací z budoucnosti, zpracování velkých dat a efektivní výkon kódu, také vyžadují pozornost.
Celkově feature engineering vyžaduje odborné znalosti, experimentování a konstrukci komplexních ad-hoc datových potrubí v nepřítomnosti nástrojů speciálně navržených pro něj.
Můžete sdílet, jak FeatureByte posiluje profesionály v oblasti datové vědy, zatímco zjednodušuje datové toky příznaků?
FeatureByte posiluje profesionály v oblasti datové vědy tím, že zjednodušuje celý proces feature engineeringu. S intuitivním Python SDK umožňuje rychlé vytváření a extrakci příznaků z velmi rozsáhlých tabulek událostí a položek. Výpočet je efektivně zpracován pomocí škálovatelnosti datových platforem, jako jsou Snowflake, DataBricks a Spark. Výpočetní notebooky usnadňují experimentování, zatímco sdílení a opětovné použití příznaků šetří čas. Audit zajišťuje správnost příznaků a okamžité nasazení odstraňuje potíže se správou datových toků.
Vedle těchto možností naší otevřené knihovny nabízí naše podnikové řešení komplexní rámec pro správu a organizaci provozu AI ve velkém měřítku, včetně pracovních postupů řízení a kontroly a uživatelského rozhraní katalogu příznaků.
Jaký je váš výhled do budoucna pro FeatureByte?
Náš konečný výhled pro FeatureByte je revolucionalizovat oblast datové vědy a strojového učení tím, že uživatelům umožní využít svůj plný tvůrčí potenciál a získat bezprecedentní hodnotu z jejich datových aktiv.
Zvláště nás těší rychlý pokrok generativní AI a transformerů, který našim uživatelům otevírá nové možnosti. Usilujeme také o demokratizaci tvorby příznaků. Generativní AI může snížit vstupní bariéry pro kreativní tvorbu příznaků a zpřístupnit ji širšímu okruhu lidí.
Naše vize budoucnosti FeatureByte tedy spočívá v neustálých inovacích, využívání síly generativní AI a demokratizaci tvorby příznaků. Chceme být platformou, na kterou se datoví profesionálové obracejí, když potřebují proměnit surová data v prakticky využitelné vstupy pro strojové učení a přinášet tak průlomové výsledky a pokrok napříč odvětvími.
Máte nějaké rady pro ambiciózní AI podnikatele?
Definujte svůj prostor, zůstaňte soustředění a přijímejte novinky.
Vymezením oblasti, ve které chcete vyniknout, se můžete odlišit a získat v ní silnou pozici. Prozkoumejte trh, pochopte potřeby a problémy potenciálních zákazníků a usilujte o jedinečné řešení, které tyto výzvy účinně řeší.
Definujte dlouhodobou vizi a stanovte jasné krátkodobé cíle, které s ní souvisejí. Soustřeďte se na budování pevných základů a poskytování hodnoty ve zvolené oblasti.
A přestože je důležité udržet zaměření, nevyhýbejte se novinkám a zkoumání nových nápadů ve své oblasti. AI se neustále vyvíjí a inovativní přístupy mohou otevřít nové příležitosti.
Děkuji za skvělý rozhovor, čtenáři, kteří se chtějí dozvědět více, by měli navštívit FeatureByte.








