
Rozhovory
Razi Raziuddin, spoluzakladatel a CEO FeatureByte – rozhovor

 Přidejte Unite.AI mezi své preferované zdroje na Google
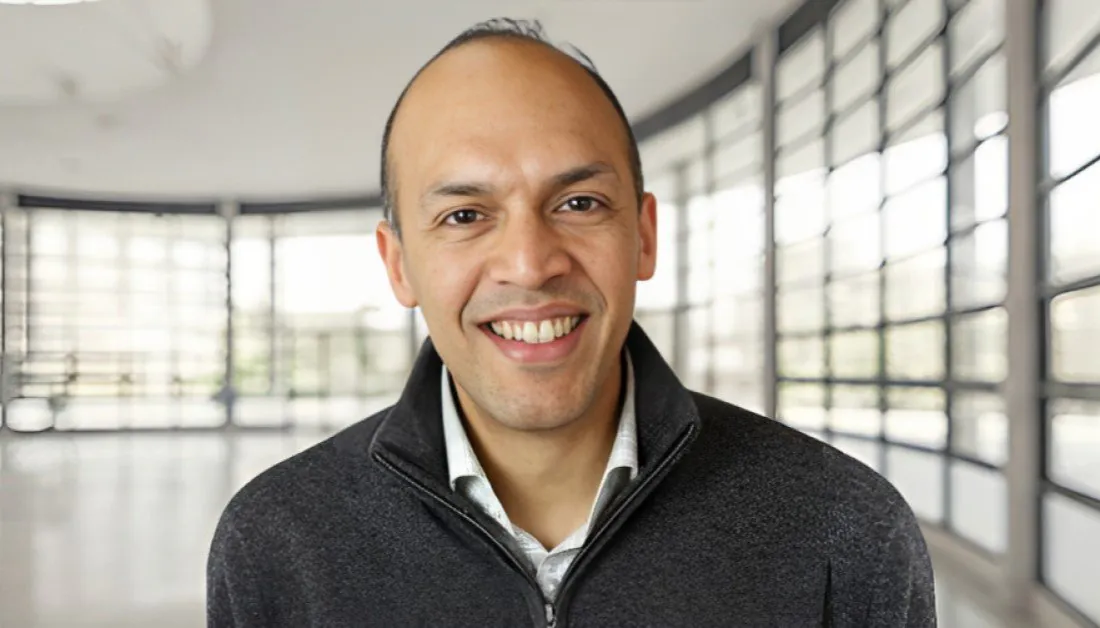
Razi Raziuddin je spoluzakladatel a CEO FeatureByte, jeho vize je odstranit poslední velkou překážku pro škálování AI v podniku. Raziho zkušenosti s analýzami a růstem sahají až k vedení dvou startupů s hodnotou přes 1 miliardu dolarů. Razi pomohl škálovat DataRobot z 10 na 850 zaměstnanců za méně než šest let. Byl průkopníkem strategie vedené službami pro vstup na trh, která se stala známkou rychlého růstu DataRobotu.
FeatureByte je na misi škálovat podnikové AI, radikálně zjednodušovat a industrializovat AI data. Platforma pro inženýrství a správu příznaků (FEM) umožňuje datovým vědcům vytvářet a sdílet špičkové příznaky a připravené datové pipeline během několika minut – místo týdnů nebo měsíců.
Co vás původně přitáhlo k počítačovým vědám a strojovému učení?
Jako někdo, kdo začal programovat na střední škole, jsem byl fascinován strojem, se kterým jsem mohl “mluvit” a ovládat kódem. Byl jsem okamžitě přitahován nekonečnými možnostmi nových aplikací. Strojové učení představovalo paradigmatický posun v programování, umožňující strojům učit se a vykonávat úkoly bez specifikace kroků v kódu. Nekonečný potenciál aplikací ML je to, co mě každý den nadchne.
Byl jste prvním obchodním zaměstnancem v DataRobot, automatizované platformě pro strojové učení, která umožňuje organizacím využívat AI jako základ svého fungování. Pak jste pomohl škálovat společnost z 10 na 1 000 zaměstnanců za méně než 6 let. Jaké byly některé klíčové poznatky z této zkušenosti?
Přejít ze nuly na jednu je těžké, ale neuvěřitelně vzrušující a odměňující. Každá fáze evoluce společnosti představuje jinou sadu výzev, ale vidět společnost růst a prosperovat je úžasný pocit.
Mé zkušenosti s AutoML mi otevřely oči nekonečnému potenciálu AI. Je fascinující vidět, jak lze tuto technologii použít napříč mnoha různými průmysly a aplikacemi. Na konci dne je vytváření nové kategorie vzácným výkonem, ale neuvěřitelně odměňujícím. Mé klíčové poznatky z této zkušenosti:
- Vytvořte úžasný produkt a vyhněte se honbě za módami
- Nebojte se jít proti proudu
- Soustřeďte se na řešení problémů zákazníků a poskytování hodnoty
- Vždy buďte otevřeni inovacím a pokusu o nové věci
- Vytvořte a vdechte správnou firemní kulturu od samého začátku
Můžete sdílet příběh o vzniku FeatureByte?
Je všeobecně známo ve světě AI/ML – že skvělá AI začíná kvalitními daty. Ale příprava, nasazení a správa AI dat (nebo příznaků) je komplexní a časově náročná. Můj spoluzakladatel, Xavier Conort, a já jsme viděli tento problém na vlastní oči v DataRobot. Zatímco modelování se stalo díky AutoML nástrojům enormně zjednodušeno, inženýrství a správa příznaků zůstává obrovskou výzvou. Na základě našich kombinovaných zkušeností a odborných znalostí Xavier a já cítili, že můžeme skutečně pomoci organizacím vyřešit tuto výzvu a dodat na slib AI všude.
Inženýrství příznaků je jádrem FeatureByte, můžete vysvětlit, co to je pro naše čtenáře?
Kvalita dat v konečném důsledku určuje kvalitu a výkon modelů AI. Data, která jsou krmena do modelů pro výuku a předpověď budoucích výsledků, se nazývají příznaky. Příznaky reprezentují informace o entitách a událostech, jako je demografická nebo psychografická data spotřebitelů, nebo vzdálenost mezi držitelem karty a obchodníkem pro transakci kreditní karty nebo počet položek různých kategorií z nákupu v obchodě.
Proces transformace surových dat na příznaky – pro výuku ML modelů a předpověď budoucích výsledků – se nazývá inženýrství příznaků.
Proč je inženýrství příznaků jednou z nejsložitějších částí projektů strojového učení?
Inženýrství příznaků je super důležité, protože proces je přímo zodpovědný za výkon ML modelů. Dobré inženýrství příznaků vyžaduje tři poměrně nezávislé dovednosti, které se spojují – znalost domény, datové vědy a datové inženýrství. Znalost domény pomáhá datovým vědcům určit, které signály extrahovat z dat pro konkrétní problém nebo případ použití. Potřebujete datové vědecké dovednosti k extrahování těchto signálů. A nakonec, datové inženýrství vám pomáhá nasadit datové pipeline a provádět všechny tyto operace ve velkém měřítku na velkých objemech dat.
Ve většině organizací tyto dovednosti žijí v různých týmech. Tyto týmy používají různé nástroje a nekomunikují dobře mezi sebou. To vede k velkému tření v procesu a zpomaluje ho na minimum.
Můžete sdílet některé poznatky o tom, proč je inženýrství příznaků nejslabším článkem při škálování AI?
Podle Andrew Ng, uznávaného odborníka v oblasti AI, „Aplikované strojové učení je v podstatě inženýrství příznaků.“ Navzdory své kritičnosti pro životní cyklus strojového učení zůstává inženýrství příznaků komplexní, časově náročné a závislé na odborných znalostech. Existuje vážný nedostatek nástrojů, které by proces usnadnily, urychlily a více industrializovaly. Úsilí a odborné znalosti vyžadované brání podnikům v nasazení AI ve velkém měřítku.
Můžete sdílet některé z výzev spojených se stavbou řešení AI zaměřeného na data, které radikálně zjednodušuje inženýrství příznaků pro datové vědce?
Stavba produktu, který má 10X výhodu oproti status quo, je super těžká. Xavier má hluboké odborné znalosti v oblasti datové vědy, které využívá k předefinování celého toku příznaků na základě prvních principů. Máme špičkový tým datových vědců s komplexními dovednostmi a inženýrů, kteří dokážou naši vizi proměnit ve skutečnost. Máme také uživatele a vývojové partnery, kteří nám radí, jak zjednodušit uživatelskou zkušenost a co nejlépe řešit jejich problémy.
Jak platforma FeatureByte urychlí přípravu dat pro aplikace strojového učení?
Příprava dat pro ML je iterativní proces, který závisí na rychlé experimentaci. Open-source SDK FeatureByte je deklarativní rámec pro vytváření špičkových příznaků s několika řádky kódu a nasazení datových pipeline během několika minut místo týdnů nebo měsíců. To umožňuje datovým vědcům soustředit se na kreativní řešení problémů a iterovat rychle na živých datech, místo aby se starali o základní technickou infrastrukturu.
Výsledek je nejen rychlejší příprava dat a jejich poskytování v produkčním prostředí, ale také lepší výkon modelu díky silným příznakům.
Můžete diskutovat, jak bude platforma FeatureByte navíc nabízet možnost zjednodušit různé průběžné úkoly správy?
Platforma FeatureByte je navržena pro správu celého životního cyklu ML příznaků. Deklarativní rámec umožňuje FeatureByte automaticky nasadit datové pipeline, zatímco extrahuje metadata relevantní pro správu celého prostředí. Uživatelé mohou sledovat stav datových pipeline a náklady, a spravovat původ a tok dat, verzi a správnost příznaků ze stejného GUI. Řízení přístupu podle rolí a schvalovací postupy na podnikové úrovni zajišťují soukromí a bezpečnost dat a současně brání nekontrolovanému množení příznaků.
Je něco jiného, co byste rádi sdíleli o FeatureByte?
Většina podnikových nástrojů AI se zaměřuje na zlepšení modelů strojového učení. My jsme si dali za cíl pomoci podnikům škálovat jejich AI, zjednodušovat a industrializovat AI data. V FeatureByte řešíme největší výzvu pro AI praktiky: Poskytování konzistentního, škálovatelného způsobu přípravy, poskytování a správy dat napříč celým životním cyklem modelu, zatímco radikálně zjednodušujeme celý proces.
Jestliže jste datový vědec nebo inženýr, který se chce držet na špičce datové vědy, doporučuji vám vyzkoušet FeatureByte zdarma.
Děkuji za skvělý rozhovor, čtenáři, kteří chtějí se dozvědět více, by měli navštívit FeatureByte.


