
Modely a platformy AI
OpenAI’s GPT-4o: Multimodální model AI transformující interakci mezi lidmi a stroji

 Přidejte Unite.AI mezi své preferované zdroje na Google

Klíčové bodyGPT-4o poprvé nativně spojuje text, zvuk a obraz v jednom modelu.
Zobrazit více
- GPT-4o poprvé nativně spojuje text, zvuk a obraz v jednom modelu.
- GPT-4o rozpoznává emoční signály a přizpůsobuje svůj tón, aby reagoval s empatií.
- OpenAI nabízí základní schopnosti GPT-4o zdarma všem uživatelům.
OpenAI představil svou nejnovější a nejvyspělejší jazykovou model – GPT-4o, také známý jako “Omni” model. Tento revoluční systém AI představuje obrovský skok vpřed, s možnostmi, které rozostřují hranice mezi lidskou a umělou inteligencí.
V srdci GPT-4o leží jeho nativní multimodální povaha, která umožňuje bezproblémové zpracování a generování obsahu napříč textem, audiem, obrázky a videem. Toto integrování více modality do jednoho modelu je prvním svého druhu a slibuje změnit, jak interagujeme s asistenty AI.
GPT-4o je však mnohem více než jen multimodální systém. Má ohromující zlepšení výkonu oproti svému předchůdci, GPT-4, a nechává konkurenční modely za sebou jako Gemini 1.5 Pro, Claude 3 a Llama 3-70B daleko za sebou. Pojďme se podívat blíže na to, co dělá tento model AI skutečně průlomový.
Nepřekonatelný výkon a efektivita
Jedním z nejpozoruhodnějších aspektů GPT-4o je jeho bezprecedentní výkonnost. Podle hodnocení OpenAI má model ohromující 60 Elo bodů náskok před předchozím špičkovým performerem, GPT-4 Turbo. Tento významný náskok umístil GPT-4o do samostatné ligy, překonávající dokonce i nejvyspělejší modely AI v současnosti dostupné.
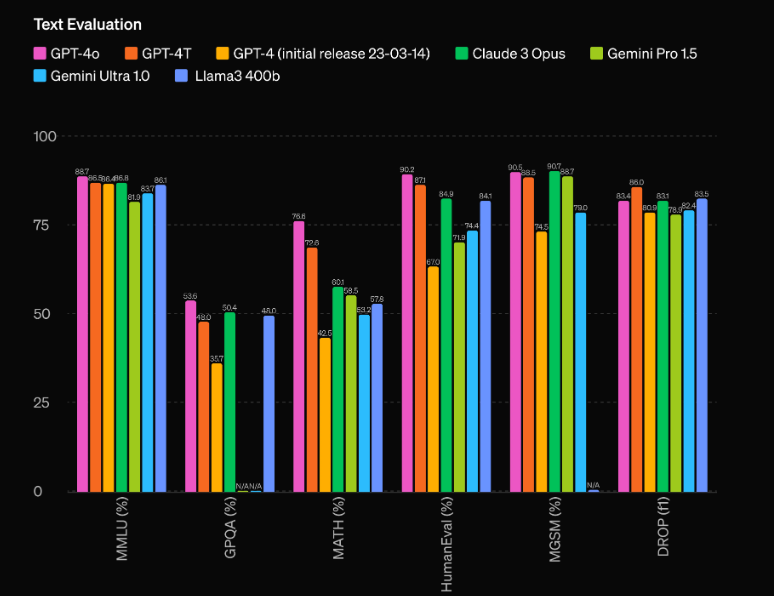
GPT-4o však nevyniká pouze ve své surové výkonnosti. Model také nabízí ohromující efektivitu, fungující na dvojnásobku rychlosti GPT-4 Turbo a zároveň stojí pouze polovinu nákladů na provoz. Tato kombinace vyšší výkonnosti a nákladové efektivity činí GPT-4o velmi atraktivní nabídkou pro vývojáře a podniky, které chtějí integrovat špičkové AI schopnosti do svých aplikací.
Multimodální schopnosti: kombinace textu, audio a vize
Možná nejpozoruhodnější aspekt GPT-4o je jeho nativní multimodální povaha, která umožňuje bezproblémové zpracování a generování obsahu napříč více modality, včetně textu, audio a vize. Toto integrování více modality do jednoho modelu je prvním svého druhu a slibuje revoluci v tom, jak interagujeme s asistenty AI.
S GPT-4o mohou uživatelé vést přirozené, reálné konverzace pomocí řeči, s modelem, který okamžitě rozpoznává a reaguje na audio vstupy. Ale schopnosti modelu nekončí tam – GPT-4o může také interpretovat a generovat vizuální obsah, otevírající široké možnosti aplikací od analýzy a generování obrázků až po pochopení a tvorbu videa.
Jednou z nejpozoruhodnějších demonstrací multimodálních schopností GPT-4o je jeho schopnost analyzovat scénu nebo obrázek v reálném čase, přesně popisující a interpretující vizuální prvky, které vnímá. Tato funkce má hluboké důsledky pro aplikace, jako jsou asistenční technologie pro zrakově postižené, stejně jako v oblastech, jako je bezpečnost, dohled a automatizace.
Schopnosti GPT-4o však sahají daleko za pouhé pochopení a generování obsahu napříč více modality. Model může také bezproblémově kombinovat tyto modality, vytvářející skutečně imerzivní a atraktivní zkušenosti. Například během živé demonstrace OpenAI GPT-4o dokázal vygenerovat píseň na základě vstupních podmínek, kombinujíc své pochopení jazyka, hudební teorie a audio generování do koherentního a působivého výstupu.
Použití GPT0 pomocí Pythonu
import openai
<p># Nahraďte svým skutečným API klíčem
OPENAI_API_KEY = "your_openai_api_key_here"</p>
<p># Funkce pro extrakci obsahu odpovědi
def get_response_content(response_dict, exclude_tokens=None):
if exclude_tokens is None:
exclude_tokens = []</p>
<p> if response_dict and response_dict.get("choices") and len(response_dict["choices"]) > 0:
content = response_dict["choices"][0]["message"]["content"].strip()
if content:
for token in exclude_tokens:
content = content.replace(token, '')
return content</p>
<p> raise ValueError(f"Unable to resolve response: {response_dict}")</p>
<p># Asynchronní funkce pro odeslání požadavku do OpenAI chat API
async def send_openai_chat_request(prompt, model_name, temperature=0.0):
openai.api_key = OPENAI_API_KEY</p>
<p> message = {"role": "user", "content": prompt}
response = await openai.ChatCompletion.acreate(
model=model_name,
messages=[message],
temperature=temperature,
)</p>
<p> return get_response_content(response)</p>
<p># Příklad použití
async def main():
prompt = "Ahoj!"
model_name = "gpt-4o-2024-05-13"
response = await send_openai_chat_request(prompt, model_name)
print(response)</p>
<p>if __name__ == "__main__":
import asyncio
asyncio.run(main())</p>
Mám:
- Importoval jsem modul openai přímo místo použití vlastního třídy.
- Přejmenoval jsem funkci openai_chat_resolve na get_response_content a provedl einige menší změny v její implementaci.
- Nahradil jsem třídu AsyncOpenAI funkcí openai.ChatCompletion.acreate, která je oficiální asynchronní metodou poskytovanou knihovnou OpenAI pro Python.
- Přidal jsem příklad hlavní funkce, která demonstruje, jak použít funkci send_openai_chat_request.
Vezměte prosím na vědomí, že musíte nahradit “your_openai_api_key_here” svým skutečným API klíčem OpenAI, aby kód fungoval správně.


